Deterministisches CBOR ist über Bibliotheken hinweg nicht deterministisch
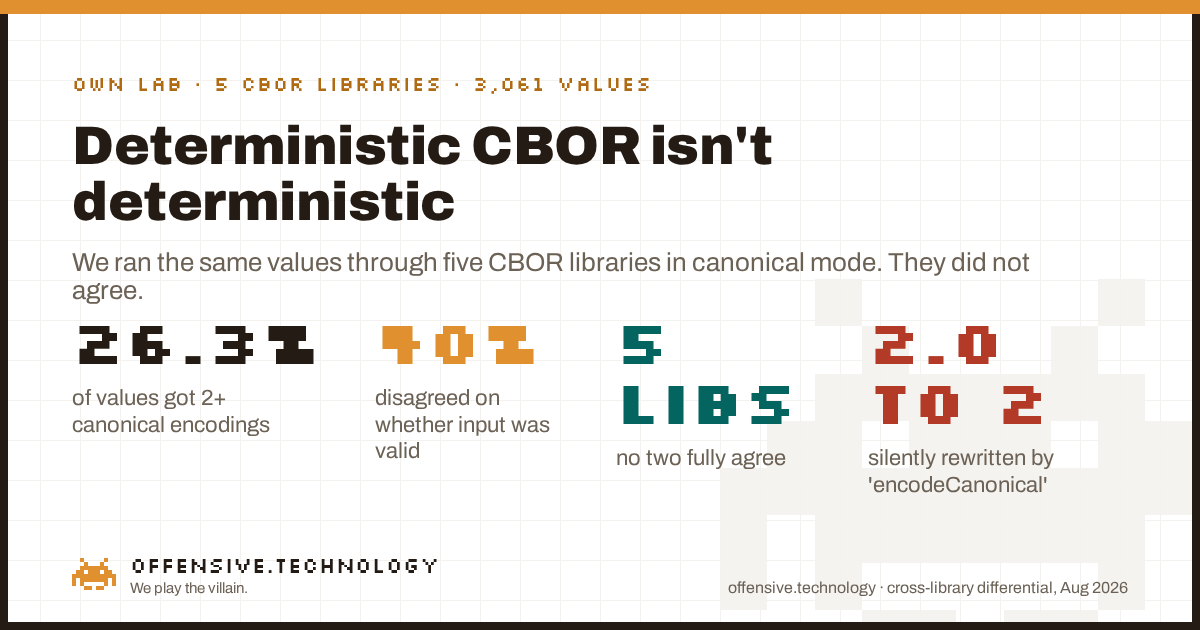
Deterministisches CBOR soll garantieren, dass ein Wert genau eine Byte-Kodierung hat. Wir haben dieselben 3,061 Werte durch fünf weit verbreitete CBOR-Bibliotheken in deren deterministischem oder kanonischem Modus geschickt, und bei 26.3% kamen mehrere unterschiedliche kanonische Kodierungen heraus. Bei 40% der Werte herrschte unter den Bibliotheken nicht einmal Einigkeit darüber, ob die Eingabe überhaupt schon eine gültige kanonische Form war. Das ist relevant, weil COSE- und CWT-Signaturen über die kodierten Bytes berechnet werden. Wenn also ein Wert mit einer Bibliothek als kanonisch signiert und mit einer anderen als kanonisch neu kodiert wird, können beide bei den Bytes voneinander abweichen und die Signaturprüfung schlägt fehl. Der extremste Fall: Eine Bibliothek wandelt unter einer Funktion namens encodeCanonical, stillschweigend den Gleitkommawert 2.0 in die Ganzzahl 2 um, wodurch sich die Bytes ändern, die ein Verifizierer hasht.
Was deterministisches CBOR eigentlich leisten soll
CBOR, die in RFC 8949 definierte Concise Binary Object Representation, ist der kompakte binäre Verwandte von JSON und bildet das Fundament für COSE, CWT, WebAuthn/FIDO2 sowie immer mehr IoT- und Supply-Chain-Formate. Standard-CBOR erlaubt es, denselben Wert auf viele Arten darzustellen: Ein Integer kann mit mehr Bytes als nötig aufgefüllt werden, die Schlüssel einer Map können in beliebiger Reihenfolge stehen, ein Float kann in halber, einfacher oder doppelter Genauigkeit gespeichert werden. Diese Flexibilität ist unproblematisch, bis ein Wert gehasht oder signiert werden muss, denn eine Signatur bezieht sich auf Bytes. Wenn die Bytes variieren können, ist die Signatur wertlos.
Deterministische Kodierung, beschrieben in RFC 8949 Section 4.2, ist die Lösung: Ein Regelwerk, das jeden Wert auf genau eine einzige Kodierung reduziert. Ältere Dokumente nennen dies kanonisches CBOR, der aktuelle Begriff lautet deterministisch, beides meint dasselbe. Das Core-Profil verlangt vier Dinge: Integers und Längen in kürzester Form, ausschliesslich definite Längen, Floats in kürzester Form und nach byteweiser Reihenfolge ihrer kodierten Form sortierte Map-Schlüssel. Setzt man alle vier korrekt um, erzeugen zwei Encoder für identische Werte im Prinzip identische Bytes. Der gesamte Nutzen des Schemas hängt an diesem Wort identisch. Also haben wir es getestet.
Was wir gemessen haben und warum Zweifler den Daten vertrauen können
Wir haben ein differentielles Orakel gebaut: Ein gemeinsamer Satz von Testwerten wurde an mehrere unabhängige CBOR-Bibliotheken in deren deterministischem oder kanonischem Modus übergeben, um die jeweiligen Ergebnisse zu vergleichen. Dieselbe Methode haben wir bereits genutzt, um bibliotheksübergreifendes TLS-Verhalten unter FIPS zu tabellieren. Das Verfahren benötigt keine Dritte und berührt fremde Infrastruktur nicht. Es ist unser eigener Code in unserem eigenen Einweg-Labor, der von uns generierte Zahlen kodiert. Die Bibliotheken tauchen lediglich in einer neutralen Kompatibilitätstabelle auf, so wie eine Browser-Kompatibilitätsübersicht Browser aufführt.
Die fünf Implementierungen, ausgewählt über mehrere Programmiersprachen hinweg und inklusive einer strikten dCBOR-Baseline:
| Bibliothek | Version | Verwendeter Modus |
|---|---|---|
| cbor2 (Python) | 6.1.4 | dumps(canonical=True) |
| cbor (Node.js) | 10.0.12 | encodeCanonical |
| fxamacker/cbor (Go) | v2.9.3 | Core Deterministic, duplicate-key enforced |
| ciborium (Rust) | 0.2.2 | Standard-Encoder (kein dedizierter kanonischer Modus) |
| bc-dcbor (Rust) | 0.15.2 | Striktes dCBOR-Profil |
Der Korpus umfasste 3,061 Werte: 61 manuell erstellte Edge-Case-Vektoren für zehn bekannte Entscheidungspunkte sowie 3,000 zufällig generierte, wohl-typisierte Werte aus einem festen Seed, damit der Durchlauf exakt reproduzierbar ist. Für jeden Wert und jede Bibliothek haben wir zwei Dinge erfasst: die kanonische Neukodierung als Hexadezimalwert und ein Urteil darüber, ob die Bibliothek die Eingabe als bereits gültig-kanonisch akzeptierte, als nicht-kanonisch dekodierte oder direkt verwarf. Anschliessend haben wir die Differenzen verglichen. Die Methode ist bewusst simpel gehalten, was ihre Stärke ist: Sie bewertet nicht, wer recht hat, sondern zählt lediglich, wo unabhängige Implementierungen, die alle für sich beanspruchen kanonisch zu sein, voneinander abweichen.
Das Ergebnis: Bei 26% der Werte mehr als eine kanonische Kodierung
Über die 3,061 Werte hinweg führten 806 (26.3%) zu mehr als einer eindeutigen kanonischen Kodierung unter den fünf Bibliotheken, und 1,223 (40.0%) führten zu unterschiedlichen Akzeptanz- oder Ablehnungsentscheidungen. Allein im Zufallskorpus, also bei ganz gewöhnlichen Werten, wie sie eine reale Anwendung serialisieren würde, wich die Kodierung in 26.2% der Fälle ab. Das ist kein reines Edge-Case-Phänomen. Ein Viertel alltäglicher Werte wird unterschiedlich kodiert, je nachdem, welchem Kanonisierer man sie übergibt.
Die manuell erstellten Vektoren zeigen, wo sich die Uneinigkeit konzentriert. Jede Zeile unten stellt einen bekannten Entscheidungspunkt deterministischer Kodierung dar. Die Prozentangaben zeigen, wie oft sich die fünf Bibliotheken bei der Kodierung und beim Gültigkeitsurteil uneins waren.
| Entscheidungspunkt | Abweichung bei Kodierung | Abweichung beim Urteil |
|---|---|---|
| Doppelte Map-Schlüssel | 100% | 100% |
| Numerische Reduktion (2.0 zu 2) | 83% | 83% |
| Map-Schlüssel-Sortierung | 67% | 67% |
| Shortest Float | 50% | 70% |
| Negative Null | 33% | 100% |
| Nicht-kanonisches NaN | 25% | 63% |
| Integer-Minimalität | 0% | 60% |
| Indefinite Längen | 0% | 80% |
| Trailing Bytes | 0% | 75% |
Lesen Sie die letzten drei Zeilen aufmerksam, denn hier liegt die Subtilität. Bei Integer-Minimalität, indefiniten Längen und nachfolgenden Restdaten erzeugen alle Bibliotheken, die überhaupt eine Kodierung ausgeben, die gleiche Kodierung, weshalb die Spalte für Kodierungsabweichungen 0% beträgt. Sie sind sich jedoch völlig uneins darüber, ob die Eingabe überhaupt zulässig war: 60% bis 80% Urteilsabweichung. Eine Bibliothek zuckt mit den Schultern und kodiert einen nicht-minimalen Integer neu, eine andere markiert ihn, eine dritte lehnt ihn ab. Für eine Signatur-Pipeline ist ein Konflikt zwischen Akzeptieren und Ablehnen genauso gefährlich wie eine Byte-Abweichung, denn er entscheidet darüber, ob eine Nachricht überhaupt verarbeitet wird.
Die Konsequenz: Eine Signatur, die auf einem Stack verifiziert und auf einem anderen fehlschlägt
Hier wird deutlich, warum das keine theoretische Spitzfindigkeit ist. COSE (RFC 9052) und CWT (RFC 8392) signieren keinen abstrakten Wert. COSE konstruiert eine Sig_structure, ein CBOR-Array, das den Kontext, die geschützten Header, externe Daten und die Payload enthält, kodiert dieses Array als CBOR und berechnet die Signatur über diese Bytes. Der Verifizierer rekonstruiert dieselbe Struktur, kodiert sie und prüft die Signatur gegen diese Bytes. Das gesamte Schema setzt voraus, dass beide Seiten für denselben Wert dieselben Bytes erzeugen. Deterministische Kodierung ist genau diese Annahme.
Und so bricht sie zusammen. Der eindeutigste Fall in unseren Daten ist der Gleitkommawert 2.0, CBOR f94000:
| Bibliothek | Kanonische Ausgabe | Verhalten |
|---|---|---|
| cbor (Node.js) | 02 | reduzierte den Float auf das Integer 2 |
| cbor2 (Python) | f94000 | behielt es als Float bei |
| fxamacker/cbor (Go) | f94000 | behielt es als Float bei |
| ciborium (Rust) | f94000 | behielt es als Float bei |
| bc-dcbor (Rust) | reject | lehnte die Float-Form ab |
Drei unterschiedliche Ergebnisse für eine triviale Zahl, erzeugt von Funktionen, die alle als kanonisch oder deterministisch beworben werden. Ein Dienst, der ein Token mit der Zahl 2.0 unter Verwendung der Node-Bibliothek signiert, deren kanonischer Modus eine numerische Reduktion im dCBOR-Stil anwendet und 02 ausgibt, und ein Verifizierer, der den Wert mit der Python- oder Go-Bibliothek neu kodiert und f94000 erhält, werden unterschiedliche Byte-Strings hashen. Die Signaturprüfung schlägt fehl, und der Fehler wirkt wie ein mysteriöser, sporadischer Interoperabilitäts-Bug, statt als das erkannt zu werden, was er ist: zwei Bibliotheken, die sich beide für kanonisch halten, aber nicht dasselbe unter kanonisch verstehen.
Der Fall doppelter Schlüssel ist auf andere Weise noch gravierender. Gegeben sei die Map {1:1, 1:2} (Eingabe a201010102), lehnen Go und die dCBOR-Baseline sie ab, Python und Node reduzieren sie stillschweigend auf eine Map mit einem Eintrag {1:2}, und der Standard-Rust-Encoder reicht das Duplikat unverändert durch. Fünf Bibliotheken, drei sicherheitsrelevante Verhaltensweisen: ablehnen, Daten stillschweigend verwerfen oder eine uneindeutige Struktur beibehalten. Jede dieser Diskrepanzen zwischen Signierer und Verifizierer eröffnet Angreifern die Möglichkeit zu steuern, welche Seite welchen Wert sieht.
Zwei Kanons und eine Ablehnungsrate, die Bände spricht
Dass dies ein strukturelles Problem und keine Ansammlung isolierter Bugs ist, liegt daran, dass es mehr als einen Kanon gibt. Reines RFC 8949 deterministic encoding ist ein Ziel. Das strengere Profil dCBOR, draft-mcnally-deterministic-cbor, ist ein anderes, und es verlangt bewusst mehr: Es schreibt eine numerische Reduktion vor, sodass 2.0 zu 2 wird, kanonisiert jedes NaN auf eine einheitliche Form und lehnt doppelte Schlüssel kategorisch ab. Es gibt noch weitere Entwürfe, darunter die Arbeit der IETF an draft-ietf-cbor-cde Common Deterministic Encoding, die genau deshalb existiert, weil das Ökosystem noch nicht konvergiert ist. Googles Adam Langley dokumentierte bereits 2022 mindestens drei widersprüchliche Sortierreihenfolgen für Map-Schlüssel, und diese Uneinigkeit wird weiterhin produktiv ausgeliefert: Reale Interoperabilitätsprobleme sind für .NETs CBOR-Bibliothek bezüglich der Sortierung nach RFC 7049 versus RFC 8949 gemeldet.
Unsere eigenen Zahlen belegen diese Spaltung in zwei Kanons mit einem deutlichen Wert: Die strikte dCBOR-Bibliothek lehnte 1,221 der 3,061 Werte (40%) ab, da sie kein gültiges dCBOR darstellten, obwohl die anderen Bibliotheken sie nach den regulären Regeln von RFC 8949 problemlos akzeptierten und kanonisch kodierten. Bei den 1,840 Werten, die dCBOR akzeptierte, stimmte es in mehr als 99.9% der Fälle mit den anderen überein. Mit anderen Worten: dCBOR und Core Deterministic CBOR sind kein strengeres, aber kompatibles Paar, sondern zwei verschiedene Sprachen, die sich lediglich auf einer Teilmenge überschneiden. Wählt man die eine auf dem Signierer und die andere auf dem Verifizierer, fallen 40% der Werte durch das Raster.
Die paarweisen Übereinstimmungswerte verdeutlichen das aus der Gegenrichtung:
- cbor2 (Python) und fxamacker/cbor (Go) stimmten bei 99.93% der Werte überein. Zwei unabhängige Implementierungen in verschiedenen Sprachen, die bei der deterministischen Kernkodierung nach RFC 8949 tatsächlich konvergieren. Es ist machbar.
- cbor (Node.js) und ciborium (Rust) stimmten bei nur 73.7% überein. Das Paar mit der geringsten Übereinstimmung, mehr als ein Viertel der Werte wich voneinander ab, weil die eine Bibliothek numerische Reduktion anwendet und die andere überhaupt nicht kanonisiert.
- Der Standard-Rust-Encoder sortierte Maps nie und kürzte Floats nicht. Das ist kein Bug; ciborium besitzt schlicht keinen dedizierten kanonischen Modus, was genau die Falle ist. Ein Entwickler, der zu einer CBOR-Bibliothek greift und keine Option für Kanonisierung findet, signiert ahnungslos nicht-kanonische Bytes.
Wie wir gemessen haben und die methodischen Grenzen
Der Datensatz stammt von uns, wurde aus von uns erzeugten Werten aufgebaut und aggregiert ausgewertet. Wir haben keine externen Systeme untersucht und keine Bibliothek als verwundbar eingestuft. Ein Kompatibilitätsunterschied ist keine Schwachstelle, sondern ein Kompatibilitätsunterschied. Die Nennung konkreter Versionen dient der Reproduzierbarkeit, nicht dem Anprangern.
- Der Korpus. 61 manuell erstellte Vektoren für zehn Entscheidungspunkte (Integer-Minimalität, Map-Sortierung, doppelte Schlüssel, Shortest-Float, numerische Reduktion, NaN, negative Null, indefinite Länge, Trailing Bytes, Big Integers) sowie 3,000 deterministisch generierte Zufallswerte, damit der gesamte Durchlauf reproduzierbar bleibt.
- Das Urteil. Für jeden Wert und jede Bibliothek haben wir die kanonische Neukodierung in Hex erfasst und festgehalten, ob die Bibliothek die Eingabe als gültig-kanonisch, nicht-kanonisch oder abgelehnt einstufte. Abweichungen wurden über jene Bibliotheken ermittelt, die eine Kodierung zurückgaben, sodass eine Bibliothek, die einen Wert ablehnt, nicht fälschlich als Erzeuger einer abweichenden Kodierung gewertet wird.
- Modi statt Standardwerte, sofern ein kanonischer Modus existiert. Jede Bibliothek wurde in ihrem dokumentierten deterministischen oder kanonischen Modus betrieben, mit Ausnahme von ciborium, das über keinen verfügt. Wir haben den Standard-Encoder genau deshalb aufgenommen, um zu zeigen, was Entwickler erhalten, wenn kein kanonischer Modus angeboten wird.
- Die Grenzen. Fünf Bibliotheken bilden nicht das gesamte Ökosystem ab, und jede Bibliothek bietet verschiedene Konfigurationsschalter für Striktheit; andere Einstellungen könnten die Zahlen verschieben. Zudem handelt es sich um Bibliotheksverhalten, nicht um den Nachweis, dass ein produktives System tatsächlich über solche Inkompatibilitäten hinweg signiert. Das Ergebnis zeigt jedoch, dass die Uneinigkeit real und häufig ist und genau jene Entscheidungspunkte betrifft, die Signaturen brechen lassen. Es ist eine Warnung vor einer falschen Annahme, kein Vorwurf an ein Produkt.
- Kein Parser-Sicherheits-Bug. CBOR-Decoder haben ihre eigene Historie an Härtungsmassnahmen, etwa die Speicher- und Denial-of-Service-Fixes in den Security Advisories von cbor2. Dabei handelt es sich um Probleme der Decoder-Robustheit, eine völlig andere Kategorie. Kanonisierungsverwirrung ist kein Absturz. Es sind zwei integre Implementierungen, die stillschweigend eine andere Auffassung von der Wahrheit haben.
Handlungsempfehlungen für das Signieren von CBOR
Die defensiven Kernpunkte sind unspektakulär, woran man erkennt, dass sie zutreffen.
- Auf beiden Seiten mit derselben Bibliothek und Version signieren und verifizieren, wo immer möglich. Stack-übergreifendes Signieren ist genau das Szenario, in dem die 26% zuschlagen.
- Das Profil explizit festlegen. Entscheiden Sie, ob Sie Standard-RFC-8949-Core-Deterministic oder striktes dCBOR benötigen, dokumentieren Sie dies und verpflichten Sie alle Teilnehmer darauf. Sie sind nicht austauschbar.
- Niemals auf Standardeinstellungen verlassen. Wenn eine Bibliothek keinen kanonischen Modus besitzt, ist ihre Standardausgabe mit an Sicherheit grenzender Wahrscheinlichkeit nicht kanonisch, und Sie erhalten keine Warnung.
- Gegen feste Testvektoren testen, einschliesslich der unangenehmen Fälle: doppelte Schlüssel,
2.0, negative Null, NaN und Maps, deren Schlüssel unterschiedlich lange Kodierungen aufweisen. Wenn Signierer und Verifizierer bei einem dieser Fälle unterschiedliche Bytes erzeugen, haben Sie Ihren Interoperabilitäts-Bug vor einem Angreifer gefunden.
Deterministisches CBOR ist ein gutes Konzept, das meistens funktioniert, und zwei unserer fünf Bibliotheken haben bewiesen, dass man Byte für Byte konvergieren kann. Aber meistens ist nicht die Garantie, die das Wort deterministisch verspricht, und Signaturen verzeihen kein meistens. Die Lücke betrifft ein Viertel gewöhnlicher Werte und liegt genau unter Formaten, von denen viel Sicherheit abhängt.
Häufig gestellte Fragen
Was ist deterministisches CBOR und wie unterscheidet es sich von kanonischem CBOR?
Deterministisches CBOR ist eine Reihe zusätzlicher Regeln über regulärem CBOR (RFC 8949), die erzwingen, dass ein Wert genau eine Byte-Kodierung hat. Ältere Dokumente bezeichnen dies als kanonisches CBOR. Der aktuelle Standard verwendet das Wort deterministisch, beides meint dasselbe. RFC 8949 Section 4.2 definiert die Kernregeln: Integers und Längen in kürzester Form, ausschliesslich definite Längen, Floats in kürzester Form und sortierte Map-Schlüssel. Das Ziel ist, dass zwei unabhängige Encoder für denselben Wert dieselben Bytes ausgeben, worauf Signier- und Hash-Verfahren angewiesen sind.
Was verlangt RFC 8949 Section 4.2 für die deterministische Kodierung?
Vier Dinge. Bevorzugte Serialisierung (Preferred Serialization), sodass jeder Integer, jede Länge und jedes Tag-Argument so wenige Bytes wie möglich belegt. Ausschliesslich definite Längen, also keine Strings, Arrays oder Maps mit indefiniter Länge. Sortierung von Map-Schlüsseln durch byteweisen lexikografischen Vergleich der kodierten Schlüssel, die sogenannte One-Step-Sortierung. Und Shortest-Float, sodass ein Wert die kleinste Variante aus Half, Single oder Double verwendet, die ihn exakt darstellt. Section 4.2.3 dokumentiert zudem eine ältere Length-First-Schlüsselsortierung zur Wahrung der RFC-7049-Kompatibilität, was eine direkte Ursache für bibliotheksübergreifende Abweichungen ist.
Wie werden CBOR-Map-Schlüssel bei deterministischer Kodierung sortiert?
Unter RFC 8949 werden Schlüssel sortiert, indem ihre vollständig kodierten Byte-Strings lexikografisch, Byte für Byte, verglichen werden. Die Vorgängerversion RFC 7049 sortierte kürzere kodierte Schlüssel grundsätzlich vor längeren ein. Beide Regeln weichen voneinander ab, sobald Schlüssel unterschiedlich lange Kodierungen aufweisen, etwa ein 1-Byte-Integer-Schlüssel neben einem 2-Byte-Schlüssel. Bibliotheken, die nach unterschiedlichen Versionen gebaut wurden, sortieren dieselbe Map daher unterschiedlich, obwohl beide das Ergebnis als kanonisch bezeichnen.
Was ist dCBOR und wie unterscheidet es sich von deterministischem CBOR nach RFC 8949?
dCBOR ist ein strengeres Profil, das im Entwurf draft-mcnally-deterministic-cbor definiert ist. Zusätzlich zu RFC 8949 verlangt es numerische Reduktion, sodass ein Float ohne Nachkommastellen als Integer kodiert werden muss, sofern er hineinpasst, und 2.0 zu 2 werden muss. Ausserdem kanonisiert es jedes NaN auf ein einheitliches Half-Width-Format und verwirft Maps mit doppelten Schlüsseln als Dekodierfehler. Da es 2.0 zu 2 reduziert, kann eine unter regulärem deterministischem CBOR gültige Map zu einer ungültigen dCBOR-Map werden, wenn zwei Schlüssel auf denselben reduzierten Wert zusammenfallen.
Warum ist deterministische Kodierung für COSE- und CWT-Signaturen wichtig?
COSE (RFC 9052) und CWT (RFC 8392) berechnen Signaturen über kodierte CBOR-Bytes und nicht über abstrakte Werte. COSE baut eine Sig_structure auf, kodiert sie als CBOR und signiert diese Bytes. Wenn der Signierer einen Wert auf die eine Art kanonisiert und der Verifizierer ihn auf eine andere neu kodiert, hasht der Verifizierer andere Bytes und die Signaturprüfung schlägt fehl, oder ein speziell konstruierter Grenzwert wird von einer Seite akzeptiert, bedeutet auf der anderen Seite jedoch etwas anderes. Deterministische Kodierung ist die Grundannahme, die das Signieren strukturierter Werte sicher macht.
Erzeugen verschiedene CBOR-Bibliotheken dieselben kanonischen Bytes?
Nicht immer. In unserem Test von fünf weit verbreiteten Bibliotheken im kanonischen Modus führten 26.3% von 3,061 Werten zu mehr als einer eindeutigen kanonischen Kodierung und 40% zu unterschiedlichen Gültigkeitsurteilen. Die Abweichungen häufen sich bei doppelten Schlüsseln, Float-Reduktion, Map-Sortierung und Shortest-Float. Zwei Bibliotheken stimmten bei mehr als 99.9% der Werte überein, während das am wenigsten übereinstimmende Paar auf unter 74% kam. Wie hoch die Übereinstimmung ist, hängt also stark von den kombinierten Implementierungen ab.
Wird 2.0 in CBOR genauso kodiert wie 2?
Das hängt von der Bibliothek und dem Profil ab. Im regulären deterministischen CBOR nach RFC 8949 bleibt der Float 2.0 ein Float und wird anders kodiert als das Integer 2. Unter dCBOR schreibt die numerische Reduktion vor, dass 2.0 als das Integer 2 kodiert wird. In unserem Test wandelte eine Bibliothek 2.0 unter einem Modus namens encodeCanonical in 2 um, drei behielten es als Float bei und die dCBOR-Baseline lehnte die Float-Form ab. Derselbe Wert, auf zwei Stacks kanonisiert, kann somit unterschiedliche signierte Bytes erzeugen.
Wie kodiert man CBOR deterministisch?
Aktivieren Sie den expliziten deterministischen oder kanonischen Modus der Bibliothek, statt sich auf Standardeinstellungen zu verlassen, da diese Maps nicht sortieren und Floats nicht kürzen. Legen Sie das exakte Profil fest, Standard-RFC-8949 oder striktes dCBOR, und stellen Sie sicher, dass Signierer und Verifizierer dasselbe verwenden. Testen Sie mit Grenzfällen, insbesondere doppelten Schlüsseln, Floats ohne Nachkommastellen, negativer Null, NaN und Map-Schlüsseln mit gemischten Längen. Wenn Sie CBOR signieren, besteht das sicherste Design darin, auf beiden Seiten identische Bibliotheken und Versionen einzusetzen oder Bytes mit festen Testvektoren abzugleichen.
Weiterführende Artikel
- Deaktiviert FIPS Post-Quantum-TLS? Dieselbe differentielle Methode, ein Eingabesatz über viele Bibliotheken hinweg, angewendet auf den TLS-Handshake statt auf ein Serialisierungsformat.
- Certificate Transparency Post-Quantum: 43% der Static-CT-Logs signieren bereits mit ML-DSA-44. Eine weitere Stelle, an der Signaturen über eine präzise Byte-Kodierung berechnet werden und an der die Analyse der Bytes die eigentliche Wahrheit offenbart.
- Was die Zertifikate beweisen. Eine kryptografische Garantie konstruktionsbedingt direkt aus dem Datenstrom abzulesen, statt der Kennzeichnung zu vertrauen, derselbe Ansatz wie beim Zählen der Bytes hier.
Ist die Kryptografie, auf die Sie sich verlassen, tatsächlich vorhanden?
Unser $100-Check analysiert Ihren tatsächlichen externen Krypto- und Protokollstatus so, wie ein Angreifer ihn kartiert, auf einem Scope, dessen Eigentum Sie bestätigt und schriftlich autorisiert haben, mit einem Senior Operator bei der Besprechung. Die Annahmen, auf die sich Ihre Signaturen und Tokens stillschweigend stützen, sind Teil dieser Angriffsfläche.
Einen $100-Check buchen