JCS-Signaturprüfung: Sechs von sieben RFC 8785-Bibliotheken stimmen bei der kanonischen Form überein, eine nicht
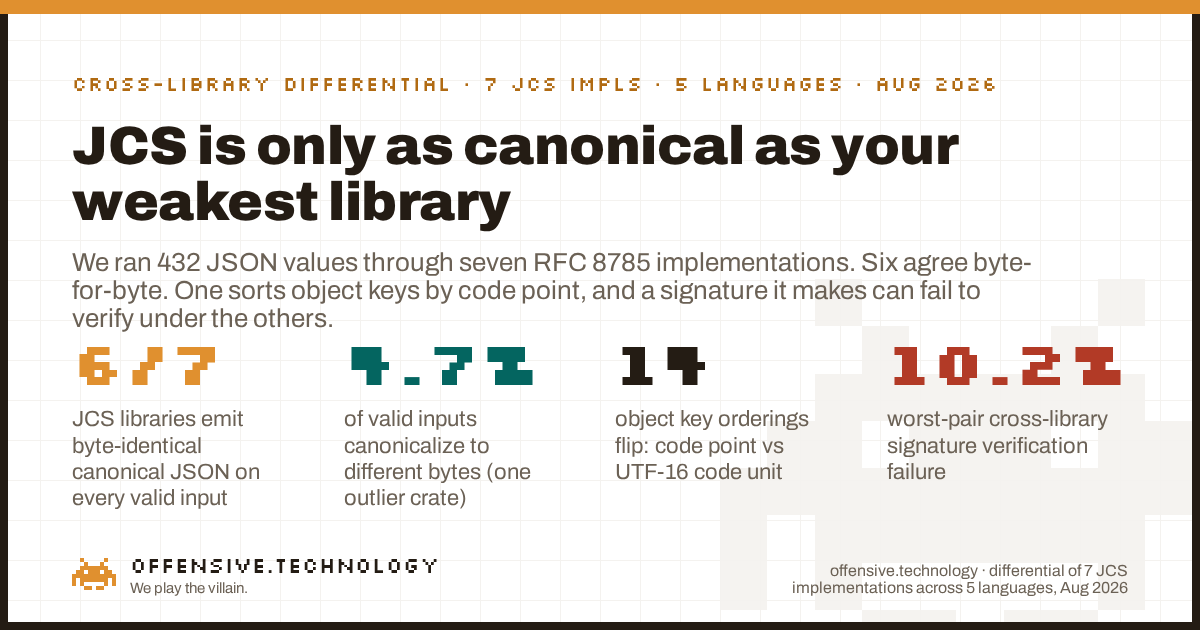
Sechs der sieben von uns getesteten RFC 8785 JSON-Kanonisierungsbibliotheken liefern bei jeder gültigen Eingabe byte-identische Ausgaben. Die siebte tut dies nicht, und diese einzelne Abweichung führt zu einem Bruch bei der Signaturprüfung. Wir haben 432 gültige JSON-Werte durch sieben unabhängige JCS-Implementierungen in fünf Sprachen geschickt. Alle sieben stimmen mit dem Praxisbeispiel in RFC 8785 Anhang B überein, alle sieben sind also echtes JCS. Doch eine davon, das Rust-Crate serde_jcs, sortiert Objektschlüssel nach Unicode-Codepunkten statt nach UTF-16-Code-Units, wie es die Spezifikation verlangt. Bei 4.7% unserer gültigen Eingaben gibt sie andere Bytes aus als die übrigen sechs. Befindet sie sich auf einer Seite einer Signatur und eine der anderen Bibliotheken auf der Gegenseite, kann ein von der einen signiertes JSON-Objekt bei der anderen die Prüfung nicht bestehen. Als wir dies direkt mit HMAC simulierten, scheiterte die ungünstigste Bibliothekskombination bei 10.2% der Nachrichten, die sie hätte akzeptieren müssen.
Warum ein einziges abweichendes Byte eine Sicherheitslücke ist
Reines JSON lässt zu viele Freiheiten. Dasselbe logische Objekt kann mit beliebiger Schlüsselreihenfolge, beliebigem Whitespace und Zahlen in vielen äquivalenten Schreibweisen formatiert sein. Diese Flexibilität ist unproblematisch, bis man das Objekt signieren möchte, denn eine Signatur wird über Bytes berechnet, nicht über Bedeutungen. Wenn Signierer und Prüfer das Objekt unterschiedlich serialisieren, hasht der Prüfer andere Bytes und die Signaturprüfung schlägt fehl. Schlimmer noch: Wenn ein Angreifer zwei Bytefolgen finden kann, die eine Seite als gleich und die andere als unterschiedlich behandelt, entsteht ein Kanonisierungsangriff: eine manipulierte Nachricht, die als das eine verifiziert wird, während sie etwas anderes bedeutet. Eine Übersicht aus dem Jahr 2026 führt Kanonisierungsfehler als wiederkehrende Schwachstellenklasse in genau solchen Systemen auf.
RFC 8785, das JSON Canonicalization Scheme, ist die Lösung. Es beseitigt jeden Freiheitsgrad: Objektschlüssel werden sortiert, Zahlen mit dem ECMAScript-Number.prototype.toString-Algorithmus serialisiert, Strings erhalten das minimal zulässige Escaping und unbedeutender Whitespace wird verworfen. Gibt man denselben JSON-Wert in eine konforme Implementierung, erhält man dieselben Bytes, sodass sich beide Enden einer Signatur darüber einig sind, was signiert wurde. Dieses Schema ist inzwischen tragend. Das Agent-to-Agent-Protokoll signiert eine Agent Card als JWS über den mit JCS kanonisierten Inhalt der Card und empfiehlt Clients, mindestens eine Signatur zu prüfen, bevor sie der Card vertrauen. Verifiable Credentials und detached JWS-Abläufe tun dasselbe. Die kanonischen Bytes bilden die Vertrauensgrenze.
Die interessante Frage ist also nicht, ob die Spezifikation solide ist. Sondern ob die tatsächlich eingesetzten Bibliotheken untereinander übereinstimmen. Wir haben das gemessen.
Was wir getestet haben
Wir haben sieben unabhängige JCS-Implementierungen in fünf Sprachen zusammengestellt, ausgewählt nach der Wahrscheinlichkeit, dass Entwickler sie aus einer Paket-Registry beziehen:
canonicalize4.0.0 für JavaScript (npm), das weit verbreitete Modul aus der erdtman-Linie.- Die
cyberphone/json-canonicalization-Referenzimplementierung in Python, der eigene Referenzcode des Autors. - Das PyPI-Paket
jcs, Version 0.2.1, eine eigenständige Python-Implementierung. gowebpki/jcsv1.0.1 für Go.- Die
cyberphone/json-canonicalization-Referenzimplementierung in Go. serde_jcs0.1.0 für Rust.java-json-canonicalization1.1 für Java (das erdtman-Maven-Artefakt).
Jede lief in einem eigenen Container mit offiziellem Image, sodass das Ergebnis reproduzierbar ist und keine Bibliothek eine andere beeinflussen konnte. Wir haben einen Korpus aus 440 gezielten Eingaben erstellt, davon 432 gültiges JSON, unterteilt nach Kategorien: Zahlenformatierung an den Grenzen von IEEE-754 und ECMAScript, negative Null, Schlüsselsortierung bei Zeichen mit unterschiedlicher Reihenfolge unter UTF-16 gegenüber Codepunkten, Unicode-Escaping und -Normalisierung, doppelte Schlüssel, isolierte Surrogates und strukturelle Randfälle. Wir haben jeder Bibliothek identische Bytes übergeben und deren kanonische Ausgabe erfasst, wobei die Bytes exakt erhalten blieben, damit keine Diskrepanz auf unsere eigene Testumgebung zurückzuführen ist.
Zwei Orakel analysierten die Ausgaben. Das erste ist ein reiner Differenzabgleich: Liefern die erfolgreichen Bibliotheken für jede Eingabe dieselben Bytes? Das zweite ist der Angriff selbst: Mit einem festen HMAC-SHA256-Schlüssel kanonisiert eine Signierer-Bibliothek eine Eingabe und versieht sie mit einem Tag. Eine Prüfer-Bibliothek kanonisiert dieselbe Eingabe und verifiziert das Tag. Jedes geordnete Bibliothekspaar, jede Eingabe. Ein Fehler dort bedeutet eine bibliotheksübergreifende Signatur, die verifiziert werden müsste, es aber nicht wird.
Bevor wir den Ergebnissen vertrauten, prüften wir die Basisdaten. Alle sieben Implementierungen reproduzieren die kanonische Ausgabe aus RFC 8785 Anhang B Byte für Byte, einschließlich der absichtlich sperrigen Zahlen und des maskierten Strings. Sie sind alle echtes JCS. Genau das macht die folgende Abweichung bedeutsam: Es geht nicht um eine defekte Bibliothek gegen eine korrekte, sondern um sieben korrekt wirkende Bibliotheken, von denen eine an einem Randfall unbemerkt falsch liegt.
Das Ergebnis: 4.7% der gültigen Eingaben weichen ab, und zwar immer auf dieselbe Weise
Bei den 426 gültigen, eindeutigen Eingaben, die jede Bibliothek akzeptierte, waren sechs der sieben bei ausnahmslos allen Werten byte-identisch. Nicht nur ähnlich: identisch, bei jedem einzelnen Wert. Die siebte, serde_jcs, wich bei 20 dieser 426 Eingaben ab, das sind 4.7%, und bildete jedes Mal die einzige Minderheit. Wenn JCS-Bibliotheken in unserem Korpus uneins sind, steht eine Bibliothek gegen alle anderen.
| Kategorie | Eingaben | Abweichend | Ursache |
|---|---|---|---|
| Schlüsselsortierung | 80 | 14 | Codepunkt- vs. UTF-16-Reihenfolge |
| Zahlenformatierung | 194 | 6 | Ganzzahlen über 253 |
| Negative Null | 18 | 0 | alle einig (-0 zu 0) |
| Unicode-Escaping | 76 | 0 | alle einig |
| Unicode-Normalisierung | 27 | 0 | alle einig (keine stille NFC/NFD-Konvertierung) |
| Strukturell | 30 | 0 | alle einig |
Zwei Kategorien machen die gesamte Abweichung aus, und die erste ist die entscheidende.
Die Sortierabweichung: Codepunkt versus UTF-16-Code-Unit
RFC 8785 legt explizit fest, dass Objektschlüssel nach ihrer UTF-16-Kodierung durch Vergleich von Code-Units sortiert werden. Dieses Detail rührt daher, dass JCS die String-Sortierung von ECMAScript übernimmt, und ECMAScript-Strings sind Sequenzen von UTF-16-Code-Units. Bei Zeichen in der Basic Multilingual Plane sind Code-Unit- und Codepunkt-Reihenfolge identisch, weshalb es fast niemandem auffällt. Sie divergieren erst bei Zeichen ergänzender Ebenen, also jenen jenseits von U+FFFF, die als Surrogate-Paar kodiert werden. Ein Emoji wie U+1F600 hat den Codepunkt 0x1F600, der größer ist als ein Zeichen der Basic Multilingual Plane wie U+E000. Seine UTF-16-Kodierung beginnt jedoch mit der High-Surrogate-Code-Unit 0xD83D, und diese ist kleiner als 0xE000. Nach den beiden Regeln sortieren sich die beiden Schlüssel also in umgekehrter Reihenfolge.
Vierzehn unserer Sortier-Testfälle trafen genau auf diesen Bruchpunkt, und serde_jcs sortiert nach Codepunkten, während die anderen sechs nach UTF-16-Code-Units sortieren. Hier ist der kleinste Fall, ein Objekt mit zwei Schlüsseln:
input:      {"😀": 1, "\uE000": 2}

six libs:   {"😀":1,"\uE000":2}     😀 first  (0xD83D < 0xE000)
serde_jcs:  {"\uE000":2,"😀":1}     😀 last   (0x1F600 > 0xE000)
Das Private-Use-Zeichen U+E000 wird hier zur Lesbarkeit als Escape-Sequenz dargestellt. JCS gibt es tatsächlich als literales Byte aus, und darin stimmen beide Bibliotheken überein. Worin sie nicht übereinstimmen, ist die Reihenfolge der beiden Einträge, und das genügt. Signiert man das linke Objekt mit HMAC oder JWS und übergibt es an einen Prüfer mit serde_jcs, kanonisiert dieser zum rechten Objekt, berechnet ein anderes Tag und verwirft eine völlig gültige Signatur. Vertauscht man die Rollen, geschieht dasselbe in die Gegenrichtung. Zwischen den beiden Bibliotheken besteht ein stabiler, stiller Widerspruch darüber, wie die kanonische Form dieses Objekts lautet.
Das ist keine neuartige Entdeckung des Schemas. Es ist die klassische Konformitätsfalle von JCS, die im RFC selbst und in früheren Berichten zur Kanonisierung thematisiert wurde. Unsere Messung liefert dazu die Basisrate: Von sieben ausgelieferten, installierbaren Bibliotheken, die alle den Testvektor des RFCs bestehen, macht es eine bis heute falsch. Die Konformität beim Standardbeispiel garantiert keine Konformität an den Rändern.
Die Zahlenabweichung und warum wir sie getrennt aufführen
Die anderen sechs abweichenden Eingaben sind Ganzzahlen größer als 253, wie beispielsweise 9007199254740993. JCS schreibt vor, dass Zahlen über den ECMAScript-Number-to-String-Algorithmus serialisiert werden, der auf einem IEEE-754-Double basiert. Jenseits von 253 kann ein Double nicht mehr jede Ganzzahl darstellen, daher rundet 9007199254740993 auf 9007199254740992. Sechs Bibliotheken tun genau das. serde_jcs behält die Ganzzahl stattdessen exakt bei. Wir weisen dies transparent als schwächeren Befund aus als die Schlüsselsortierung: RFC 8785 ist nur für Zahlen im Wertebereich von IEEE-754-Doubles definiert, eine Ganzzahl über 253 ist also streng genommen eine unzulässige Eingabe, die ein Aufrufer nie übergeben sollte. Dennoch ist es syntaktisch gültiges JSON, erzeugt reale Byte-Abweichungen zwischen Bibliotheken und kann Systeme treffen, die numerische Identifikatoren außerhalb des sicheren JavaScript-Ganzzahlbereichs verarbeiten. Wir führen es im Differenztest auf, lassen es aber aus der Hauptaussage heraus.
Alles andere blieb stabil. Negative Null kanonisierte überall zu 0. Keine Bibliothek wendete unbemerkt eine Unicode-Normalisierung an. Ein String in NFC und derselbe String in NFD blieben über alle sieben hinweg unterschiedlich, was korrekt ist: JCS normalisiert nicht. Das Escaping von Strings war einheitlich. Die Unstimmigkeiten sind eng begrenzt und spezifisch, was sie gefährlich statt offensichtlich macht.
Aus der Abweichung wird ein Signaturfehler
Eine Diskrepanz in den kanonischen Bytes ist nur dann relevant, wenn sie Funktionsstörungen verursacht. Also haben wir sie provoziert. Mit einem festen HMAC-SHA256-Schlüssel fungierte jede Bibliothek als Signierer und jede als Prüfer, über jede gültige Eingabe hinweg, bei der beide Bytes lieferten: 42 geordnete Paare, 11,754 Verifikationsprüfungen insgesamt. Eine Prüfung schlägt fehl, wenn sich die kanonischen Bytes von Signierer und Prüfer unterscheiden, weil dann die Tags divergieren.
Über alle Paare hinweg schlugen 1.87% der Prüfungen fehl. Diese Zahl wird durch die sechs Bibliotheken relativiert, die untereinander nie abweichen. Realistisch betrachtet muss man die Werte daher paarweise betrachten. Jedes Paar, das nicht serde_jcs einbindet, verifizierte zu 100%. Jedes Paar, das serde_jcs mit einer konformen Bibliothek kombiniert, scheiterte bei den abweichenden Eingaben. Die schlechteste Kombination, die cyberphone-Go-Referenz als Signierer und serde_jcs als Prüfer, scheiterte bei 15 von 147 Prüfungen. Das entspricht einer Fehlerrate von 10.2% bei der Signaturprüfung zwischen zwei Bibliotheken, die beide den RFC-Testvektor bestehen. In einer Umgebung, die verschiedene Sprachen über Vertrauensgrenzen hinweg kombiniert, und Agent-to-Agent-Systeme tun genau das, ist dies der Fehler, der in der Praxis auftritt.
Die andere Dimension: Manche Bibliotheken verwerfen, was andere akzeptieren
Neben den Byte-Abweichungen stießen wir auf eine breite Interoperabilitätskluft zwischen Akzeptanz und Ablehnung: 288 Eingaben, bei denen mindestens eine Bibliothek eine Ausgabe erzeugte und eine andere einen Fehler meldete. Das ist keine Diskrepanz der kanonischen Form, aber ein ernstes Interoperabilitätsrisiko, das die Bibliotheken in Lager spaltet.
- Top-Level-Skalare. Die beiden Parser aus der Referenzlinie,
cyberphonein Go underdtmanin Java, lehnen ein isoliertes0oder"x"als Top-Level-Eingabe ab; die anderen kanonisieren es. Wenn Ihr Protokoll jemals einen einfachen JSON-Skalar signiert, wird die Hälfte dieser Bibliotheken ihn überhaupt nicht verarbeiten. - Doppelte Schlüssel. Bei
{"a":1,"a":2}lehnen alle drei Go- und Java-Parser das Objekt strikt ab, während die Implementierungen in JavaScript, Python und Rust stillschweigend den letzten Wert übernehmen. Die Handhabung doppelter Schlüssel ist so unzureichend spezifiziert, dass Signierer und Prüfer uneins darüber sein können, ob die Nachricht überhaupt zulässig ist. - Isolierte Surrogates. Ein unvollständiges Surrogate-Paar in einem String ist ungültiges JSON, und die Reaktionen driften auseinander: Eine Bibliothek gibt das Ersetzungszeichen U+FFFD aus, eine leitet die rohen Nicht-UTF-8-Bytes ungefiltert durch und der Rest verweigert die Verarbeitung. Jedes dieser Verhaltensweisen auf der einen Seite und ein anderes auf der Gegenseite führt unausweichlich zur Divergenz.
Wir klammern dies aus der Hauptkennzahl aus, da es sich um Akzeptanz versus Ablehnung handelt und nicht um Byte-Differenzen. Die Lehre bleibt dieselbe: Sicherheit garantiert die Implementierung, nicht das Akronym des Standards.
Das Spiegelbild unseres CBOR-Ergebnisses
Wir haben denselben Versuch ein Kodierungsformat weiter auf binärem CBOR durchgeführt und das umgekehrte Bild erhalten. Dort war deterministisches CBOR zwischen den Bibliotheken keineswegs deterministisch: 26% der Werte ergaben mehr als eine kanonische Kodierung, und die Uneinigkeit zog sich durch das gesamte Testfeld. JCS ist das strukturiertere Format. Seine Regeln sind strenger und seine Bibliotheken stimmen größtenteils überein, sodass die Divergenz auf einen Ausreißer und wenige Randfälle schrumpft, statt ein Viertel aller Fälle zu betreffen. Dieser Kontrast liefert die entscheidende Erkenntnis: Die Sicherheit eines Kanonisierungsschemas ist keine Eigenschaft des Schemas allein. Sie ist das Produkt aus der Präzision des Schemas und der Konformität der konkret eingesetzten Bibliotheken. JCS bietet das bessere Schema. Es entbindet Sie aber nicht davon, Ihre Bibliotheken zu prüfen.
Testen Sie Ihre eigene Bibliothek in zehn Sekunden
Sie benötigen unsere Testumgebung nicht, um festzustellen, auf welcher Seite dieser Trennlinie Sie stehen. Kanonisieren Sie dieses Objekt mit der von Ihnen eingesetzten JCS-Bibliothek:
{ "😀": 1, "\uE000": 2 }Steht in der Ausgabe das Emoji an erster Stelle, sortiert Ihre Bibliothek nach UTF-16-Code-Units und entspricht dem RFC sowie der Mehrheit. Steht der Private-Use-Schlüssel an erster Stelle, sortiert sie nach Codepunkten und wird mit konformen Gegenstellen bei jedem Objekt kollidieren, dessen Schlüssel Zeichen aus ergänzenden Ebenen mit solchen der Basic Multilingual Plane mischen. Führen Sie diesen Test an beiden Enden jeder Vertrauensgrenze durch, die JSON signiert, besonders wenn unterschiedliche Programmiersprachen aufeinandertreffen und Schlüssel angreifergesteuertes Unicode enthalten können.
Wie wir gemessen haben, damit Zweifler den Zahlen vertrauen können
Der Datensatz ist vollständig synthetisch und stammt von uns. Wir haben keine Dienste Dritter kontaktiert, nichts gescannt und keine realen Daten gesammelt. Jede Eingabe ist ein von uns geschriebener JSON-Wert, um gezielt Randfälle zu prüfen. Die Bibliotheken sind öffentliche Open-Source-Pakete, getestet in ihren veröffentlichten Versionen und namentlich genannt, weil das Benennen des Verhaltens einer Implementierung der Zweck eines Konformitätstests ist und kein Vorwurf.
- Isolation. Jede Implementierung lief in einem Container mit eigenem offiziellem Image, verarbeitete denselben Datenkorpus und schrieb ihre kanonische Ausgabe unter exakter Beibehaltung der Bytes. So liegt eine Diskrepanz bei der Bibliothek und nicht bei unserer Pipeline.
- Referenzbasis. Alle sieben Bibliotheken reproduzieren die kanonische Ausgabe aus RFC 8785 Anhang B Byte für Byte. Daran erkennen wir, dass es sich um echtes JCS und nicht um ungefähre Serialisierer handelt.
- Zwei unabhängige Orakel. Ein Byte-Level-Differenzabgleich und ein praktischer HMAC-Sign-then-Verify-Test über alle 42 geordneten Bibliothekspaare. Die Signaturfehler belegen die Differenzen in der Praxis und sind keine theoretische Behauptung.
- Transparente Kategorisierung. Wir trennen Byte-Abweichungen bei gültigen Eingaben (die Kernkennzahl) strikt von Akzeptanz-gegen-Ablehnungs-Fällen und Eingaben außerhalb der Spezifikation. So beansprucht keine Zahl mehr Aussagekraft, als ihr zusteht.
Die Testumgebung, der Korpus-Generator und die Ausführungsskripte der Bibliotheken sind archiviert, um die Methode reproduzierbar zu halten. Wir berichten hier ausschließlich die aggregierten Ergebnisse.
Warum das wichtig ist, und die realistischen Grenzen
Kanonisierung gewinnt im Hintergrund wieder fundamentale Bedeutung. Das Bestreben, autonomen Agenten überprüfbare Identitäten über signierte Agent Cards und Verifiable Credentials zu verleihen, leitet Vertrauensentscheidungen durch eine Kette aus JCS und Signatur, oft mit Signierern und Prüfern in unterschiedlichen Sprachen von verschiedenen Teams. Unter genau diesen Bedingungen wird eine Konformitätslücke in einer einzelnen Bibliothek zum Verifikationsbruch. Die gute Nachricht dieser Erhebung: JCS bietet eine hohe Interoperabilität. Wählt man zwei konforme Bibliotheken, verhalten sie sich ununterscheidbar. Die schlechte Nachricht: Konformität wird nicht durch das Label garantiert, und die Stelle, an der eine ausgelieferte Bibliothek noch heute versagt, die Schlüsselsortierung bei Zeichen ergänzender Ebenen, ist für Angreifer erreichbar und wird leicht übersehen.
Ein Ergebnis ohne Grenzen ist bloßes Marketing, daher hier die Einschränkungen.
- Sieben Bibliotheken, nicht das gesamte Ökosystem. Dies sind verbreitete, installierbare Implementierungen. Es gibt weitere, und eine von uns nicht getestete C- oder C-Sharp-Implementierung könnte auf beiden Seiten der Trennlinie stehen. Die Methodik lässt sich übertragen, die genauen Zahlen gelten für dieses Set in diesen Versionen.
- Geringe Wahrscheinlichkeit in typischen Payloads. Die Abweichung bei der Schlüsselsortierung greift nur, wenn Objektschlüssel Zeichen ergänzender Ebenen enthalten. In gewöhnlichen Agent Cards oder Credentials mit ASCII-Feldnamen ist das selten. Das Risiko ist real, aber an Bedingungen geknüpft, und ein Angreifer mit Kontrolle über einen Schlüssel wird diese Bedingung gezielt herbeiführen.
- Versionen verändern sich. Bibliotheken werden korrigiert. Ein Crate, das heute nach Codepunkten sortiert, arbeitet morgen vielleicht konform. Genau deshalb lautet der dauerhafte Rat, die konkret eingesetzte Version zu testen, anstatt einem Namen blind zu vertrauen oder zu misstrauen.
- Zahlenabweichungen betreffen Randfälle. Ganzzahlen über 253 liegen außerhalb des für JCS definierten Bereichs. Wir behandeln diese Divergenz daher als schwächeren Sekundärbefund und halten sie aus der Hauptaussage heraus.
Häufig gestellte Fragen
Was ist das JSON Canonicalization Scheme (JCS)?
JCS, definiert in RFC 8785, ist ein Regelwerk, das einen JSON-Wert in eine eindeutige, deterministische Bytefolge überführt. Es sortiert Objektschlüssel, serialisiert Zahlen mit dem ECMAScript-Number-to-String-Algorithmus, wendet minimales String-Escaping an und entfernt unbedeutenden Whitespace. Zwei Parteien, die vom selben JSON-Wert ausgehen, erzeugen exakt dieselben Bytes, sodass sie diese hashen oder signieren können und übereinstimmende Ergebnisse erzielen. JCS ermöglicht es, JSON zu signieren, ohne sich vorab auf dessen exakte Schreibweise einigen zu müssen.
Warum schlägt die JCS-Signaturprüfung über verschiedene Sprachen hinweg fehl?
Sie schlägt fehl, wenn die Bibliothek des Signierers und die des Prüfers für denselben Wert unterschiedliche kanonische Bytes erzeugen. In unserem Test stimmten sechs von sieben Implementierungen Byte für Byte überein, aber ein Rust-Crate sortierte Objektschlüssel nach Unicode-Codepunkten statt nach UTF-16-Code-Units, wie es RFC 8785 vorschreibt. Enthält ein Objekt Schlüssel mit Emojis oder anderen Zeichen ergänzender Ebenen, geben beide Bibliotheken die Schlüssel in unterschiedlicher Reihenfolge aus, wodurch sich das Tag unterscheidet und die Verifikation fehlschlägt.
Liefern JCS-Implementierungen dieselbe kanonische Ausgabe?
Überwiegend. Bei 426 gültigen, eindeutigen Eingaben an sieben Implementierungen in fünf Sprachen waren sechs bei jeder Eingabe byte-identisch, und alle sieben entsprachen RFC 8785 Anhang B. Eine Implementierung wich bei 4.7% der Eingaben ab, wobei jede Abweichung entweder einen Objektschlüssel aus einer ergänzenden Ebene oder eine Ganzzahl über 2 hoch 53 betraf. JCS interoperiert bei regulären Daten zuverlässig und divergiert nur an spezifischen Rändern.
Wie verhindert JCS die Umgehung von Signaturen?
Es eliminiert die Freiheiten von Standard-JSON: Schlüsselreihenfolge, Whitespace und die alternativen Schreibweisen von Zahlen. So wird ein Wert auf genau eine Bytefolge abgebildet und kann nicht in ein anders aussehendes Äquivalent umkodiert werden. Diese Garantie gilt nur, wenn beide Seiten eine konforme Implementierung nutzen. Eine nicht konforme Implementierung führt genau die Mehrdeutigkeit wieder ein, die JCS beseitigen sollte. Daher ist die Konformität der Implementierung die entscheidende Eigenschaft, nicht bloß die Verwendung von JCS.
Wie nutzt A2A JCS zum Signieren von Agent Cards?
Im Agent-to-Agent-Protokoll ist eine Agent Card ein JSON-Dokument, das Identität und Fähigkeiten eines Agenten beschreibt. Die Signatur ist ein JWS über den Inhalt der Card, nachdem dieser mit JCS kanonisiert wurde. Clients wird geraten, mindestens eine Signatur zu prüfen, bevor sie einer Card vertrauen. Da die signierten Bytes der JCS-Ausgabe entsprechen, berechnet ein Client, dessen JCS-Bibliothek anders kanonisiert als die des Signierers, eine abweichende Eingabe für die Prüfung.
Was ist ein Kanonisierungs-Verwirrungsangriff?
Er nutzt Uneinigkeiten darüber aus, wie Signierer und Prüfer eine Nachricht in die kanonische Form überführen. Erzeugen beide unterschiedliche Bytes für denselben logischen Wert, kann ein Angreifer Eingaben konstruieren, die als das eine verifiziert werden, aber etwas anderes bedeuten, oder er kann legitime Signaturen ungültig werden lassen. Kanonisierungsfehler sind eine wiederkehrende Schwachstellenklasse in Systemen, die strukturierte Daten signieren, da die Sicherheit davon abhängt, dass jede Partei die absolut identische kanonische Form ermittelt.
Ist RFC 8785 ein offizieller IETF-Standard?
RFC 8785 ist ein im Juni 2020 veröffentlichter Informational RFC der IETF. Es handelt sich um eine stabile, referenzierbare Spezifikation des JSON Canonicalization Scheme, auf die neuere Arbeiten zu signiertem JSON, Verifiable Credentials und Agent-to-Agent-Sicherheit verweisen. Der Status Informational bedeutet, dass es sich nicht um einen verbindlichen Internet Standard handelt, wohl aber um die verbindliche Definition, an der sich Implementierungen orientieren.
Weiterführende Analysen
- Deterministisches CBOR ist zwischen Bibliotheken nicht deterministisch. Derselbe Differenztest eine Kodierungsebene weiter, auf binärem CBOR, bei dem 26% der Werte mehr als eine kanonische Form erhielten.
- Sicherheit von Remote-MCP-Servern: Was eine Zählung von 19.321 Servern offenlegt. Die Angriffsfläche im Agenten-Tooling, die diese signierten Cards schützen sollen, flächendeckend untersucht.
- Was Zertifikate wirklich belegen. Kryptografische Zusicherungen direkt aus den Bytes ablesen, statt Labels zu vertrauen, dieselbe Methode angewendet auf Zertifikate.