CBOR determinista no es determinista entre bibliotecas
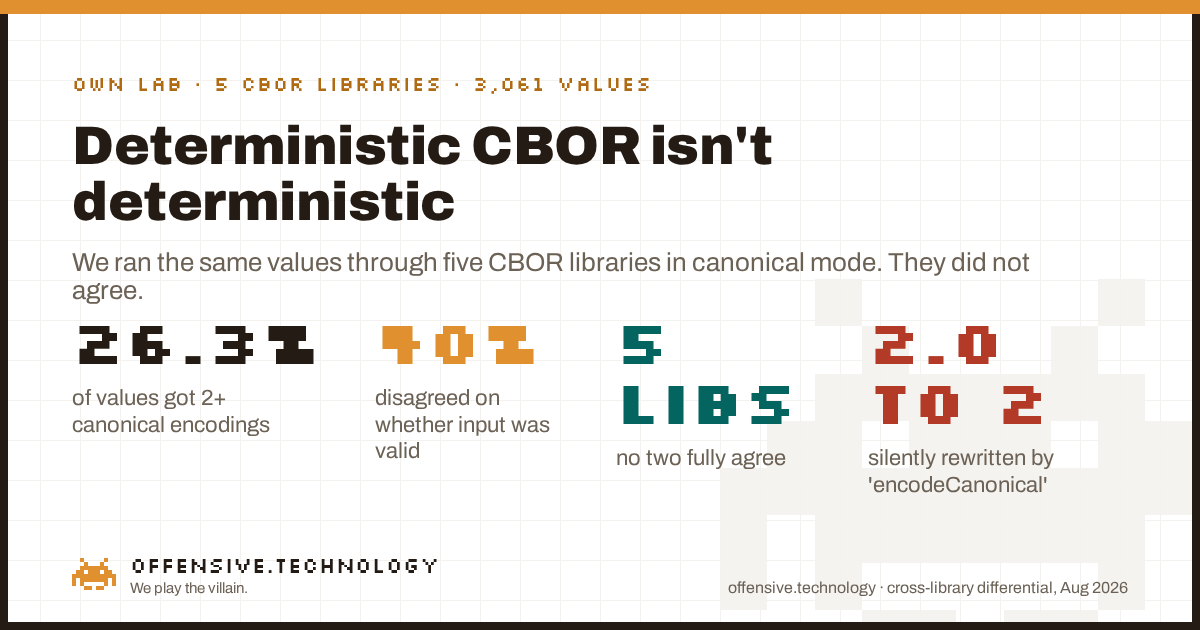
Se supone que CBOR determinista garantiza que un valor tiene exactamente una codificación en bytes. Pasamos los mismos 3,061 valores por cinco bibliotecas de CBOR ampliamente utilizadas en su modo determinista o canónico, y el 26.3% resultó con más de una codificación canónica distinta. En el 40% de los valores, las bibliotecas ni siquiera pudieron ponerse de acuerdo sobre si la entrada ya era una forma canónica válida. Esto importa porque las firmas COSE y CWT se calculan sobre los bytes codificados, por lo que cuando un valor se firma como canónico en una biblioteca y se vuelve a codificar como canónico en otra, ambas pueden discrepar sobre los bytes y la firma falla al verificarse. El caso más extremo: una biblioteca, bajo una función literalmente llamada encodeCanonical, reescribe silenciosamente el valor de punto flotante 2.0 en el entero 2, cambiando los bytes sobre los que el verificador calculará el hash.
Qué se supone que debe hacer CBOR determinista
CBOR, la Concise Binary Object Representation definida en RFC 8949, es el primo binario compacto de JSON que sustenta COSE, CWT, WebAuthn/FIDO2 y una creciente cantidad de formatos de IoT y cadena de suministro. CBOR básico permite escribir el mismo valor de muchas formas: un entero puede rellenarse con más bytes de los necesarios, las claves de un mapa pueden aparecer en cualquier orden, un flotante puede almacenarse en precisión media, simple o doble. Esa flexibilidad está bien hasta que necesita calcular un hash o firmar un valor, porque una firma se realiza sobre bytes, y si los bytes pueden variar, la firma carece de sentido.
La codificación determinista, descrita en RFC 8949 Section 4.2, es la solución: un conjunto de reglas que reducen cada valor a una y solo una codificación. El material más antiguo llama a esto CBOR canónico; la palabra actual es determinista, y ambas significan lo mismo. El perfil principal exige cuatro cosas: enteros y longitudes en su forma más corta, solo longitudes definidas, flotantes en su forma más corta y claves de mapa ordenadas byte por byte según su forma codificada. Si se cumplen las cuatro correctamente, en principio, dos codificadores cualesquiera emiten bytes idénticos para valores idénticos. Todo el valor del esquema reside en esa palabra idénticos. Así que lo pusimos a prueba.
Qué medimos y por qué un escéptico debería confiar en ello
Construimos un oráculo diferencial: un conjunto compartido de valores de prueba, pasado por varias bibliotecas independientes de CBOR en su modo determinista o canónico, comparando lo que producía cada una. Este es el mismo método que utilizamos para tabular el comportamiento de TLS entre bibliotecas bajo FIPS. No requiere terceros y no toca la infraestructura de nadie; es nuestro propio código, en nuestro propio laboratorio desechable, codificando números que inventamos. Las bibliotecas solo aparecen en una tabla de compatibilidad neutral, del mismo modo que una tabla de compatibilidad de navegadores nombra navegadores.
Las cinco implementaciones, elegidas para abarcar distintos lenguajes e incluir una línea base estricta de dCBOR:
| Biblioteca | Versión | Modo utilizado |
|---|---|---|
| cbor2 (Python) | 6.1.4 | dumps(canonical=True) |
| cbor (Node.js) | 10.0.12 | encodeCanonical |
| fxamacker/cbor (Go) | v2.9.3 | Core Deterministic, duplicate-key enforced |
| ciborium (Rust) | 0.2.2 | codificador predeterminado (sin modo canónico dedicado) |
| bc-dcbor (Rust) | 0.15.2 | perfil dCBOR estricto |
El corpus consistió en 3,061 valores: 61 vectores límite elaborados a mano que cubrían diez puntos de decisión conocidos, más 3,000 valores bien tipados generados aleatoriamente a partir de una semilla fija para que la ejecución sea exactamente reproducible. Para cada valor y cada biblioteca registramos dos cosas: la recodificación canónica en hexadecimal y un veredicto sobre si la biblioteca aceptó la entrada como canónica ya válida, la decodificó como no canónica o la rechazó directamente. Luego comparamos las diferencias. El método es deliberadamente simple, lo cual es su mayor fortaleza: no juzga quién tiene razón, solo cuenta dónde discrepan implementaciones independientes que afirman ser canónicas.
El resultado: 26% de los valores, más de una codificación canónica
En los 3,061 valores, 806 (26.3%) produjeron más de una codificación canónica distinta entre las cinco bibliotecas, y 1,223 (40.0%) produjeron más de un veredicto de aceptación o rechazo. Solo el corpus aleatorio, valores comunes que una aplicación real podría serializar, se dividió en la codificación el 26.2% de las veces. Este no es un fenómeno exclusivo de casos extremos; una cuarta parte de los valores cotidianos se codifica de manera diferente según el canonicalizador que se utilice.
Los vectores elaborados a mano muestran dónde se concentran las discrepancias. Cada fila a continuación es un punto de decisión conocido en la codificación determinista, y los porcentajes indican la frecuencia con la que las cinco bibliotecas discreparon en la codificación y en el veredicto de validez.
| Punto de decisión | Discrepancia de codificación | Discrepancia de veredicto |
|---|---|---|
| Claves de mapa duplicadas | 100% | 100% |
| Reducción numérica (2.0 a 2) | 83% | 83% |
| Ordenación de claves de mapa | 67% | 67% |
| Flotante más corto | 50% | 70% |
| Cero negativo | 33% | 100% |
| NaN no canónico | 25% | 63% |
| Minimalidad de enteros | 0% | 60% |
| Longitudes indefinidas | 0% | 80% |
| Bytes sobrantes al final | 0% | 75% |
Lea las últimas tres filas con atención, porque son las más sutiles. En cuanto a minimalidad de enteros, longitudes indefinidas y datos sobrantes al final, las bibliotecas que producen una codificación generan todas la misma codificación, por lo que la columna de discrepancia de codificación es 0%. Sin embargo, discrepan rotundamente sobre si la entrada era aceptable en primer lugar: discrepancias de veredicto de entre el 60% y el 80%. Una biblioteca ignora el problema y recodifica un entero no mínimo; otra lo marca; una tercera lo rechaza. Para un flujo de firma, un desacuerdo de aceptación frente a rechazo es tan peligroso como una discrepancia en los bytes, porque decide si un mensaje se procesa o no.
El impacto real: una firma que se verifica en un stack y falla en otro
He aquí por qué esto deja de ser una simple curiosidad. COSE (RFC 9052) y CWT (RFC 8392) no firman un valor abstracto. COSE construye una estructura Sig_structure, un array CBOR que contiene el contexto, las cabeceras protegidas, los datos externos y el payload, codifica ese array como CBOR y la firma se calcula sobre esos bytes. El verificador reconstruye la misma estructura, la codifica y comprueba la firma con respecto a sus bytes. Todo el esquema asume que ambas partes producen los mismos bytes para el mismo valor. La codificación determinista es esa suposición.
Ahora observe cómo se rompe. El caso más evidente en nuestros datos es el valor de punto flotante 2.0, en CBOR f94000:
| Biblioteca | Salida canónica | Qué hizo |
|---|---|---|
| cbor (Node.js) | 02 | redujo el flotante al entero 2 |
| cbor2 (Python) | f94000 | lo mantuvo como flotante |
| fxamacker/cbor (Go) | f94000 | lo mantuvo como flotante |
| ciborium (Rust) | f94000 | lo mantuvo como flotante |
| bc-dcbor (Rust) | reject | rechazó la forma de flotante |
Tres resultados distintos para un número trivial, bajo funciones promocionadas todas como canónicas o deterministas. Un servicio que firma un token que contiene el número 2.0 usando la biblioteca de Node, cuyo modo canónico aplica reducción numérica al estilo dCBOR y emite 02, y un verificador que recodifica el valor con la biblioteca de Python o Go y obtiene f94000, calcularán el hash sobre cadenas de bytes diferentes. La firma no se verificará y el fallo parecerá un misterioso problema intermitente de interoperabilidad en lugar de lo que realmente es: dos bibliotecas que creen ser canónicas y no son el mismo canónico.
El caso de las claves duplicadas es peor en otro sentido. Dado el mapa {1:1, 1:2} (entrada a201010102), Go y la línea base dCBOR lo rechazan, Python y Node lo colapsan silenciosamente a un mapa de una sola entrada {1:2}, y el codificador predeterminado de Rust transfiere el duplicado sin modificar. Cinco bibliotecas, tres comportamientos relevantes para la seguridad: rechazar, descartar datos en silencio o preservar una estructura ambigua. Cualquier discrepancia entre firmante y verificador representa un punto donde un atacante puede elegir qué parte ve qué valor.
Dos cánones y una tasa de rechazo que cuenta la historia
La razón por la que este es un problema estructural y no un conjunto de fallos aislados es que existe más de un canon. La codificación determinista de RFC 8949 es un objetivo. El perfil más estricto dCBOR, draft-mcnally-deterministic-cbor, es otro, y deliberadamente va más allá: exige reducción numérica para que 2.0 se convierta en 2, canonicaliza cada NaN a una única forma y rechaza de plano las claves duplicadas. Hay aún más propuestas en curso, incluyendo el trabajo de draft-ietf-cbor-cde Common Deterministic Encoding del IETF, que existe precisamente porque el ecosistema no ha convergido. Adam Langley de Google catalogó al menos tres ordenaciones contradictorias de claves de mapa en 2022, y el desacuerdo sigue presente en producción: hay incidencias reales de interoperabilidad abiertas contra la biblioteca CBOR de .NET sobre la ordenación de RFC 7049 frente a RFC 8949.
Nuestros propios números muestran la división de los dos cánones en una única cifra contundente. La biblioteca dCBOR estricta rechazó 1,221 de los 3,061 valores (40%) por no ser dCBOR válido, a pesar de que las otras bibliotecas los aceptaron y codificaron canónicamente sin problemas según las reglas estándar de RFC 8949. En los 1,840 valores que dCBOR sí aceptó, coincidió con las demás más del 99.9% de las veces. En otras palabras, dCBOR y CBOR determinista estándar no son un par estricto pero compatible; son dos lenguajes distintos que se solapan en un subconjunto. Si elige uno en el firmante y el otro en el verificador, el 40% de sus valores caerá en la brecha.
Las cifras de concordancia por pares demuestran lo mismo desde la otra perspectiva:
- cbor2 (Python) y fxamacker/cbor (Go) coincidieron en el 99.93% de los valores. Dos implementaciones independientes, en lenguajes diferentes, que convergen genuinamente en la codificación determinista principal de RFC 8949. Es alcanzable.
- cbor (Node.js) y ciborium (Rust) coincidieron solo en el 73.7%. El par menos similar, con más de una cuarta parte de los valores en desacuerdo, porque uno aplica reducción numérica y el otro no canonicaliza en absoluto.
- El codificador predeterminado de Rust nunca ordenó mapas ni acortó flotantes. Eso no es un fallo; ciborium simplemente no tiene un modo canónico dedicado, lo cual es exactamente la trampa. Un desarrollador que busca una biblioteca CBOR y no encuentra una opción canónica firmará con gusto bytes no canónicos sin enterarse jamás.
Cómo lo medimos y las limitaciones reales
El conjunto de datos es nuestro, construido a partir de valores que creamos y reportado de forma agregada. No sondeamos ningún sistema externo ni señalamos a ninguna biblioteca como vulnerable; una diferencia de compatibilidad no es una vulnerabilidad, es una diferencia de compatibilidad. El objetivo de nombrar las versiones es la reproducibilidad, no la culpa.
- El corpus. 61 vectores elaborados a mano dirigidos a diez puntos de decisión (minimalidad de enteros, ordenación de mapas, claves duplicadas, flotante más corto, reducción numérica, NaN, cero negativo, longitud indefinida, bytes sobrantes, enteros grandes), más 3,000 valores aleatorios con semilla para que toda la ejecución sea determinista y reproducible.
- El veredicto. Para cada valor y biblioteca registramos la recodificación canónica en hexadecimal y si la biblioteca trató la entrada como canónica válida, no canónica o si la rechazó. La divergencia se cuenta sobre las bibliotecas que devolvieron una codificación, por lo que una biblioteca que rechaza un valor no se contabiliza erróneamente como si produjera una diferente.
- Modos, no configuraciones predeterminadas cuando existe un modo canónico. Cada biblioteca se ejecutó en su modo determinista o canónico documentado, excepto ciborium, que no tiene ninguno; incluimos su codificador predeterminado precisamente para mostrar lo que obtiene un desarrollador cuando no se ofrece un modo canónico.
- Las limitaciones. Cinco bibliotecas no representan la totalidad del ecosistema, y cada biblioteca expone varios parámetros de rigurosidad; un ajuste distinto podría cambiar un número. Estos son también comportamientos de biblioteca, no una prueba de que algún producto en producción firme a través de una incompatibilidad. El hallazgo es que la discrepancia es real, común y recae en los puntos de decisión exactos que rompen las firmas. Es una advertencia sobre una suposición, no una acusación contra un producto.
- No es lo mismo que un fallo de seguridad en el parser. Los decodificadores CBOR tienen su propio historial de mitigaciones y robustecimiento, por ejemplo las correcciones de memoria y denegación de servicio en los avisos de seguridad de cbor2. Esos son problemas de robustez del decodificador, una categoría independiente. La confusión en la canonicalización no es una caída del sistema; son dos implementaciones honestas que discrepan silenciosamente sobre la verdad.
Qué hacer si firma CBOR
Las conclusiones defensivas son aburridas, que es precisamente como se sabe que son correctas.
- Firme y verifique con la misma biblioteca y versión en ambos extremos siempre que sea posible. Firmar entre distintos stacks es exactamente donde afecta ese 26%.
- Fije el perfil explícitamente. Decida si requiere RFC 8949 core deterministic estándar o dCBOR estricto, documéntelo y haga que cada participante use ese mismo. No son intercambiables.
- Nunca confíe en los valores predeterminados. Si una biblioteca no tiene modo canónico, su salida predeterminada casi con total seguridad no es canónica y no recibirá ninguna advertencia.
- Realice pruebas con vectores fijos, incluyendo los más problemáticos: claves duplicadas,
2.0, cero negativo, NaN y mapas cuyas claves tienen diferentes longitudes codificadas. Si su firmante y su verificador producen bytes diferentes para cualquiera de ellos, habrá encontrado su fallo de interoperabilidad antes de que lo haga un atacante.
CBOR determinista es una buena idea que en su mayor parte funciona, y dos de nuestras cinco bibliotecas demostraron que es posible converger hasta el último byte. Pero en su mayor parte no es la garantía que implica la palabra determinista, y las firmas no toleran un en su mayor parte. La brecha abarca una cuarta parte de los valores ordinarios y subyace a formatos de los que depende gran parte de la seguridad.
Preguntas frecuentes
¿Qué es CBOR determinista y en qué se diferencia de CBOR canónico?
CBOR determinista es un conjunto de reglas adicionales sobre CBOR estándar (RFC 8949) que obligan a que un valor tenga exactamente una codificación en bytes. Es lo que los documentos más antiguos llaman CBOR canónico; el estándar actual utiliza la palabra determinista y significan lo mismo. La Sección 4.2 de RFC 8949 establece las reglas principales: enteros y longitudes en su forma más corta, solo longitudes definidas, flotantes en su forma más corta y claves de mapa ordenadas. El objetivo es que dos codificadores independientes emitan los mismos bytes para el mismo valor, que es en lo que se basan la firma y el hashing.
¿Qué exige la Sección 4.2 de RFC 8949 para la codificación determinista?
Cuatro cosas. Serialización preferida, para que cada entero, longitud y argumento de etiqueta utilice el menor número de bytes posible. Solo longitudes definidas, sin cadenas, arrays o mapas de longitud indefinida. Ordenación de claves de mapa mediante comparación lexicográfica byte por byte de las claves codificadas, la ordenación one-step. Y flotante más corto, para que un valor use la menor precisión entre media, simple o doble que lo represente con exactitud. La Sección 4.2.3 también documenta una ordenación de claves más antigua que prioriza la longitud, mantenida por compatibilidad con RFC 7049, la cual es una fuente directa de desacuerdos entre bibliotecas.
¿Cómo se ordenan las claves de mapa en CBOR en la codificación determinista?
Según RFC 8949, las claves se ordenan comparando sus cadenas de bytes totalmente codificadas de forma lexicográfica, byte por byte. RFC 7049, la versión anterior, ordenaba primero una clave codificada más corta antes que una más larga. Las dos reglas discrepan siempre que las claves tienen diferentes longitudes codificadas, por ejemplo una clave entera de un byte junto a una de dos bytes, por lo que las bibliotecas creadas según diferentes versiones ordenan el mismo mapa de manera distinta mientras que ambas denominan canónico al resultado.
¿Qué es dCBOR y cómo se diferencia de CBOR determinista según RFC 8949?
dCBOR es un perfil más estricto definido en el borrador draft-mcnally-deterministic-cbor. Por encima de RFC 8949, añade reducción numérica, por lo que un flotante sin parte fraccionaria debe codificarse como un entero cuando quepa y 2.0 debe convertirse en 2. También canonicaliza cada NaN a una forma de ancho medio y rechaza mapas con claves duplicadas como un error de decodificación. Dado que reduce 2.0 a 2, un mapa que es válido bajo CBOR determinista estándar puede convertirse en un mapa dCBOR no válido cuando dos claves colapsan al mismo valor reducido.
¿Por qué importa la codificación determinista para las firmas COSE y CWT?
COSE (RFC 9052) y CWT (RFC 8392) calculan una firma sobre los bytes CBOR codificados, no sobre un valor abstracto. COSE construye una estructura Sig_structure, la codifica como CBOR y firma esos bytes. Si el firmante canonicaliza un valor de una manera y el verificador lo recodifica de otra, el verificador calcula el hash de bytes diferentes y la firma falla, o un valor manipulado en los límites pasa en un extremo y significa algo distinto en el otro. La codificación determinista es la suposición que hace que firmar un valor estructurado sea seguro.
¿Producen las distintas bibliotecas de CBOR los mismos bytes canónicos?
No siempre. En nuestra prueba de cinco bibliotecas ampliamente utilizadas en modo canónico, el 26.3% de 3,061 valores produjo más de una codificación canónica distinta, y el 40% produjo más de un veredicto de validez. Las discrepancias se concentran en claves duplicadas, reducción de flotantes, ordenación de mapas y flotante más corto. Dos bibliotecas coincidieron en más del 99.9% de los valores, mientras que el par menos similar coincidió en menos del 74%, por lo que la concordancia depende en gran medida de las implementaciones que se emparejen.
¿Se codifica 2.0 igual que 2 en CBOR?
Depende de la biblioteca y del perfil. En CBOR determinista estándar según RFC 8949, el flotante 2.0 permanece como flotante y se codifica de forma diferente al entero 2. Bajo dCBOR, la reducción numérica exige que 2.0 se codifique como el entero 2. En nuestra prueba, una biblioteca reescribió 2.0 a 2 bajo un modo llamado encodeCanonical, tres lo mantuvieron como flotante y la línea base dCBOR rechazó la forma de flotante, por lo que el mismo valor canonicalizado en dos stacks puede producir bytes firmados diferentes.
¿Cómo se codifica CBOR de forma determinista?
Active el modo determinista o canónico explícito de la biblioteca en lugar de confiar en los valores predeterminados, que no ordenan mapas ni acortan flotantes. Fije el perfil exacto, RFC 8949 estándar o dCBOR estricto, y asegúrese de que el firmante y el verificador utilicen el mismo. Pruebe con casos extremos, especialmente claves duplicadas, flotantes sin parte fraccionaria, cero negativo, NaN y claves de mapa de longitud mixta. Si firma CBOR, el diseño más seguro es utilizar la misma biblioteca y versión en ambos extremos, o comparar los bytes frente a vectores de prueba fijos.
Lecturas relacionadas
- ¿Desactiva FIPS el soporte de TLS poscuántico? El mismo método diferencial, un conjunto de entradas aplicado a múltiples bibliotecas, aplicado al handshake de TLS en lugar de a un formato de serialización.
- Certificate Transparency poscuántico: el 43% de los logs static-CT ya firman con ML-DSA-44. Otro escenario donde las firmas se calculan sobre una codificación en bytes precisa y donde analizar los bytes cuenta la verdadera historia.
- Lo que prueban los certificados. Leer una garantía criptográfica directamente del tráfico por diseño en lugar de confiar en la etiqueta, el mismo principio detrás de examinar los bytes aquí.
¿Está realmente presente la criptografía de la que depende?
Nuestra revisión de $100 analiza su postura externa real de criptografía y protocolos tal como la mapea un atacante, sobre un alcance cuya propiedad ha verificado y autorizado por escrito, con un operador sénior a cargo de la entrega de resultados. Las suposiciones en las que confían silenciosamente sus firmas y tokens son parte de esa superficie.
Contratar una revisión de $100