Le CBOR déterministe n'est pas déterministe d'une bibliothèque à l'autre
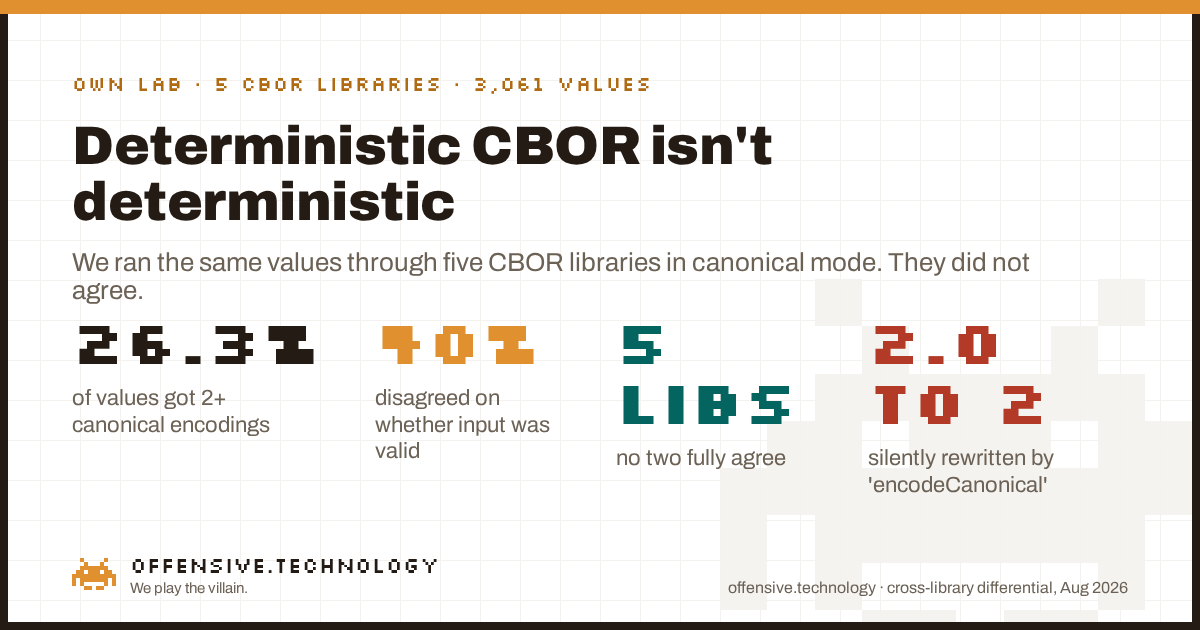
Le CBOR déterministe est censé garantir qu'une valeur possède exactement un seul encodage en octets. Nous avons soumis les mêmes 3,061 valeurs à cinq bibliothèques CBOR très répandues dans leur mode déterministe ou canonique, et 26.3% ont généré plus d'un encodage canonique distinct. Sur 40% des valeurs, les bibliothèques ne sont même pas parvenues à s'accorder sur le fait que l'entrée était déjà sous une forme canonique valide. Cela a son importance, car les signatures COSE et CWT sont calculées sur les octets encodés. Dès lors, lorsqu'une valeur est signée sous forme canonique avec une bibliothèque et réencodée sous forme canonique avec une autre, les deux peuvent être en désaccord sur les octets et la vérification de la signature échoue. Le cas le plus flagrant : une bibliothèque, sous une fonction littéralement nommée encodeCanonical, réécrit silencieusement la valeur à virgule flottante 2.0 en l'entier 2, modifiant ainsi les octets qu'un vérificateur va hacher.
Ce que le CBOR déterministe est censé faire
Le CBOR, ou Concise Binary Object Representation défini dans la RFC 8949, est le pendant binaire compact de JSON qui sous-tend COSE, CWT, WebAuthn/FIDO2 et un nombre croissant de formats IoT et de supply chain. Le CBOR standard permet d'écrire la même valeur de multiples façons : un entier peut être complété sur plus d'octets que nécessaire, les clés d'une map peuvent apparaître dans n'importe quel ordre, un flottant peut être stocké en demi-précision, simple ou double précision. Cette flexibilité ne pose pas de problème jusqu'à ce que vous deviez hacher ou signer une valeur, car une signature porte sur des octets, et si les octets peuvent varier, la signature n'a plus aucun sens.
L'encodage déterministe, décrit dans la section 4.2 de la RFC 8949, apporte la solution : un ensemble de règles qui réduisent chaque valeur à un seul et unique encodage. La littérature plus ancienne parle de CBOR canonique ; le terme actuel est déterministe, et les deux désignent la même chose. Le profil de base exige quatre éléments : des entiers et des longueurs sous leur forme la plus courte, des longueurs définies uniquement, des flottants sous leur forme la plus courte et des clés de map triées selon l'ordre lexicographique octet par octet de leur forme encodée. Respectez ces quatre règles et, en principe, deux encodeurs quelconques produiront des octets identiques pour des valeurs identiques. Tout l'intérêt du schéma repose sur ce terme : identiques. Nous l'avons donc mis à l'épreuve.
Ce que nous avons mesuré, et pourquoi les sceptiques peuvent s'y fier
Nous avons mis en place un oracle différentiel : un jeu unique de valeurs de test, injecté dans plusieurs bibliothèques CBOR indépendantes dans leur mode déterministe ou canonique, en comparant la production de chacune. Il s'agit de la même méthode que celle employée pour cartographier le comportement TLS inter-bibliothèques sous FIPS. Elle ne nécessite aucun tiers et ne touche à l'infrastructure de personne ; il s'agit de notre propre code, dans notre propre laboratoire éphémère, encodant des nombres que nous avons générés. Les bibliothèques n'apparaissent que dans un tableau comparatif neutre, à la manière d'une matrice de compatibilité entre navigateurs.
Les cinq implémentations, choisies pour couvrir plusieurs langages et inclure une référence stricte en dCBOR :
| Bibliothèque | Version | Mode utilisé |
|---|---|---|
| cbor2 (Python) | 6.1.4 | dumps(canonical=True) |
| cbor (Node.js) | 10.0.12 | encodeCanonical |
| fxamacker/cbor (Go) | v2.9.3 | Core Deterministic, rejet des clés dupliquées forcé |
| ciborium (Rust) | 0.2.2 | encodeur par défaut (aucun mode canonique dédié) |
| bc-dcbor (Rust) | 0.15.2 | profil dCBOR strict |
Le corpus comprenait 3,061 valeurs : 61 vecteurs limites conçus à la main couvrant dix points d'arbitrage connus, plus 3,000 valeurs bien typées générées aléatoirement à partir d'une graine fixe pour que le test soit rigoureusement reproductible. Pour chaque valeur et chaque bibliothèque, nous avons consigné deux informations : le réencodage canonique sous forme hexadécimale, et un verdict, indiquant si la bibliothèque acceptait l'entrée comme étant déjà sous une forme canonique valide, la décodait comme non canonique ou la rejetait purement et simplement. Ensuite, nous avons comparé les différences. La méthode est délibérément simpliste, ce qui constitue sa force : elle ne juge pas qui a raison, elle se contente de dénombrer les points de divergence entre des implémentations indépendantes, prétendant toutes être canoniques.
Le résultat : 26% des valeurs obtiennent plus d'un encodage canonique
Sur les 3,061 valeurs, 806 (26.3%) ont produit plus d'un encodage canonique distinct parmi les cinq bibliothèques, et 1,223 (40.0%) ont généré plus d'un verdict d'acceptation ou de rejet. Le corpus aléatoire à lui seul, constitué de valeurs ordinaires qu'une application réelle pourrait sérialiser, a divergé sur l'encodage dans 26.2% des cas. Il ne s'agit pas d'un phénomène limité aux seuls cas limites ; un quart des valeurs courantes s'encode différemment selon le canonicaliseur auquel vous les confiez.
Les vecteurs conçus manuellement mettent en évidence les zones de concentration des désaccords. Chaque ligne ci-dessous représente un point d'arbitrage d'encodage déterministe connu, et les pourcentages indiquent la fréquence à laquelle les cinq bibliothèques ont divergé sur l'encodage et sur le verdict de validité.
| Point d'arbitrage | Divergence d'encodage | Divergence de verdict |
|---|---|---|
| Clés de map dupliquées | 100% | 100% |
| Réduction numérique (2.0 en 2) | 83% | 83% |
| Ordonnancement des clés de map | 67% | 67% |
| Flottant le plus court | 50% | 70% |
| Zéro négatif | 33% | 100% |
| NaN non canonique | 25% | 63% |
| Minimalité des entiers | 0% | 60% |
| Longueurs indéfinies | 0% | 80% |
| Octets superflus en fin de flux | 0% | 75% |
Lisez attentivement les trois dernières lignes, car elles cachent une subtilité. Sur la minimalité des entiers, les longueurs indéfinies et les données superflues de fin de flux, les bibliothèques qui génèrent un encodage produisent toutes le même encodage, d'où un taux de 0% dans la colonne de divergence d'encodage. En revanche, elles divergent nettement sur la question de savoir si l'entrée était acceptable au départ : 60% à 80% de divergences sur les verdicts. Une bibliothèque hausse les épaules et réencode un entier non minimal ; une autre signale une anomalie ; une troisième le rejette. Dans une chaîne de signature, un désaccord d'acceptation ou de rejet est tout aussi dangereux qu'un désaccord sur les octets, car il décide si un message est traité ou non.
L'impact concret : une signature valide sur une stack et invalide sur une autre
Voici pourquoi ce problème dépasse le cadre du simple détail technique. COSE (RFC 9052) et CWT (RFC 8392) ne signent pas une valeur abstraite. COSE construit une structure Sig_structure, un tableau CBOR contenant le contexte, les en-têtes protégés, les données externes et la charge utile, encode ce tableau en CBOR, et la signature est calculée sur ces octets. Le vérificateur reconstruit la même structure, l'encode et vérifie la signature par rapport à ses octets. L'ensemble du mécanisme suppose que les deux parties produisent les mêmes octets pour la même valeur. L'encodage déterministe constitue précisément cette hypothèse.
Observez maintenant la rupture. Le cas le plus net de nos données concerne la valeur à virgule flottante 2.0, en CBOR f94000:
| Bibliothèque | Sortie canonique | Action effectuée |
|---|---|---|
| cbor (Node.js) | 02 | a réduit le flottant à l'entier 2 |
| cbor2 (Python) | f94000 | l'a conservé sous forme de flottant |
| fxamacker/cbor (Go) | f94000 | l'a conservé sous forme de flottant |
| ciborium (Rust) | f94000 | l'a conservé sous forme de flottant |
| bc-dcbor (Rust) | reject | a refusé la forme flottante |
Trois résultats distincts pour un nombre anodin, sous des fonctions toutes présentées comme canoniques ou déterministes. Un service qui signe un jeton contenant le nombre 2.0 au moyen de la bibliothèque Node, dont le mode canonique applique la réduction numérique façon dCBOR et émet 02, combiné à un vérificateur qui réencode la valeur avec la bibliothèque Python ou Go et obtient f94000, hacheront des chaînes d'octets différentes. La signature ne sera pas vérifiée, et l'échec passera pour un mystérieux bug d'interopérabilité intermittent plutôt que pour ce qu'il est réellement : deux bibliothèques qui s'estiment chacune canoniques, mais qui n'appliquent pas la même canonicité.
Le cas des clés dupliquées est pire sous un autre angle. Face à la map {1:1, 1:2} (entrée a201010102), Go et la référence dCBOR la rejettent, Python et Node la réduisent silencieusement à une map à une seule entrée {1:2}, et l'encodeur Rust par défaut laisse le doublon intact. Cinq bibliothèques, trois comportements distincts sur le plan de la sécurité : rejeter, abandonner des données en silence ou préserver une structure ambiguë. N'importe lequel de ces décalages entre un signataire et un vérificateur offre à un attaquant la possibilité de choisir quelle partie voit quelle valeur.
Deux canons, et un taux de rejet révélateur
Si ce problème est structurel et ne relève pas d'une série de bugs isolés, c'est parce qu'il existe plusieurs canons. L'encodage déterministe standard de la RFC 8949 constitue une première cible. Le profil plus strict dCBOR, documenté dans draft-mcnally-deterministic-cbor, en est une autre, et il va délibérément plus loin : il impose la réduction numérique pour que 2.0 devienne 2, canonicalise chaque NaN sous une forme unique et rejette catégoriquement les clés dupliquées. D'autres propositions sont encore en cours d'élaboration, notamment les travaux de l'IETF sur le draft-ietf-cbor-cde Common Deterministic Encoding, qui existent précisément parce que l'écosystème n'a pas convergé. Adam Langley de Google a recensé au moins trois ordonnancements de clés de map contradictoires dès 2022, et ces divergences subsistent en production : de réels problèmes d'interopérabilité restent ouverts concernant la bibliothèque CBOR de .NET sur l'ordonnancement de la RFC 7049 versus celui de la RFC 8949.
Nos propres chiffres illustrent cette fracture en deux canons par une donnée sans équivoque. La bibliothèque dCBOR stricte a rejeté 1,221 des 3,061 valeurs (40%) comme n'étant pas du dCBOR valide, alors même que les autres bibliothèques les ont acceptées et encodées de manière canonique selon les règles standard de la RFC 8949. Sur les 1,840 valeurs que dCBOR a acceptées, elle s'est alignée avec les autres plus de 99.9% du temps. En d'autres termes, dCBOR et le CBOR déterministe de base ne forment pas un duo plus strict mais compatible ; ce sont deux dialectes distincts qui se chevauchent sur un sous-ensemble. Choisissez l'un pour le signataire et l'autre pour le vérificateur, et 40% de vos valeurs tomberont dans l'intervalle.
Les taux de concordance par paire confirment le même constat dans l'autre sens :
- cbor2 (Python) et fxamacker/cbor (Go) se sont accordés sur 99.93% des valeurs. Deux implémentations indépendantes, dans des langages différents, qui convergent réellement sur l'encodage déterministe de base de la RFC 8949. C'est donc réalisable.
- cbor (Node.js) et ciborium (Rust) ne se sont accordés que sur 73.7%. La paire la moins similaire, séparée sur plus d'un quart des valeurs, car l'une applique la réduction numérique tandis que l'autre ne canonicalise absolument rien.
- L'encodeur Rust par défaut n'a jamais trié les maps ni raccourci les flottants. Il ne s'agit pas d'un bug ; ciborium ne propose tout simplement aucun mode canonique dédié, ce qui constitue précisément le piège. Un développeur qui adopte une bibliothèque CBOR et ne trouve pas d'option canonique signera sans hésiter des octets non canoniques sans jamais s'en apercevoir.
Notre méthodologie de mesure et ses limites objectives
Le jeu de données nous appartient, construit à partir de valeurs que nous avons conçues, et ses résultats sont présentés de manière agrégée. Nous n'avons sondé aucun système externe et n'avons qualifié aucune bibliothèque de vulnérable ; un écart de compatibilité n'est pas une vulnérabilité, c'est un écart de compatibilité. Mentionner les versions sert la reproductibilité, non l'incrimination.
- Le corpus. 61 vecteurs conçus manuellement ciblant dix points d'arbitrage (minimalité des entiers, ordonnancement des maps, clés dupliquées, flottant le plus court, réduction numérique, NaN, zéro négatif, longueur indéfinie, octets superflus, grands entiers), complétés par 3,000 valeurs aléatoires initialisées avec une graine fixe pour garantir une exécution déterministe et reproductible.
- Le verdict. Pour chaque valeur et bibliothèque, nous avons consigné le réencodage canonique en hexadécimal et indiqué si la bibliothèque traitait l'entrée comme canonique valide, non canonique ou rejetée. La divergence est calculée sur les bibliothèques ayant renvoyé un encodage, afin qu'une bibliothèque rejetant une valeur ne soit pas comptabilisée à tort comme en produisant une différente.
- Des modes spécifiques, non des configurations par défaut lorsqu'un mode canonique existe. Chaque bibliothèque a été exécutée dans son mode déterministe ou canonique documenté, à l'exception de ciborium qui n'en possède aucun ; nous avons inclus son encodeur par défaut précisément pour montrer ce qu'un développeur obtient lorsqu'aucun mode canonique n'est proposé.
- Les limites. Cinq bibliothèques ne représentent pas l'ensemble de l'écosystème, et chacune expose plusieurs paramètres de rigueur ; modifier ces réglages pourrait déplacer les pourcentages. Il s'agit également de comportements de bibliothèques, non de la preuve qu'un produit déployé effectue des signatures à travers une telle divergence. Le constat est que le désaccord est réel, fréquent et se produit sur les points d'arbitrage précis qui brisent les signatures. C'est une mise en garde concernant une hypothèse, non une accusation portée contre un produit.
- À distinguer d'un bug de sécurité dans le parseur. Les décodeurs CBOR ont leur propre historique de durcissement, à l'image des correctifs de mémoire et de déni de service documentés dans les avis de sécurité de cbor2. Il s'agit de problèmes de robustesse de décodeur, une classe distincte. La confusion de canonicalisation n'est pas un crash ; ce sont deux implémentations rigoureuses qui s'opposent silencieusement sur la vérité des données.
Que faire si vous signez du CBOR
Les mesures défensives à adopter sont pragmatiques, ce qui confirme leur pertinence.
- Signez et vérifiez avec la même bibliothèque et la même version aux deux extrémités dans la mesure du possible. Les signatures entre stacks hétérogènes constituent précisément la source des 26% d'échecs.
- Fixez le profil de manière explicite. Décidez si vous exigez le profil déterministe de base standard de la RFC 8949 ou le dCBOR strict, formalisez-le et imposez-le à chaque intervenant. Ils ne sont pas interchangeables.
- Ne vous fiez jamais aux comportements par défaut. Si une bibliothèque ne dispose d'aucun mode canonique, sa sortie par défaut n'est presque certainement pas canonique, et vous ne recevrez aucun avertissement.
- Testez par rapport à des vecteurs de test fixes, y compris les cas complexes : clés dupliquées,
2.0, zéro négatif, NaN et maps dont les clés ont des longueurs encodées différentes. Si votre signataire et votre vérificateur produisent des octets différents pour l'un d'entre eux, vous aurez identifié votre bug d'interopérabilité avant qu'un attaquant ne l'exploite.
Le CBOR déterministe est un concept pertinent qui fonctionne la plupart du temps, et deux de nos cinq bibliothèques ont prouvé qu'il est possible de converger à l'octet près. Mais la plupart du temps ne constitue pas la garantie qu'implique le mot déterministe, et les signatures ne s'accommodent pas de l'approximatif. L'écart concerne un quart des valeurs ordinaires, et il fragilise des formats dont dépend une part majeure de la sécurité.
Foire aux questions
Qu'est-ce que le CBOR déterministe et en quoi diffère-t-il du CBOR canonique ?
Le CBOR déterministe est un ensemble de règles additionnelles appliquées au CBOR standard (RFC 8949) qui imposent à une valeur donnée d'avoir exactement un seul encodage en octets. C'est ce que les documents plus anciens appellent CBOR canonique ; la norme actuelle utilise le terme déterministe, et les deux ont la même signification. La section 4.2 de la RFC 8949 énonce les règles fondamentales : entiers et longueurs sous la forme la plus courte, longueurs définies exclusivement, flottants sous leur forme la plus compacte et clés de map triées. L'objectif est que deux encodeurs indépendants émettent les mêmes octets pour une même valeur, condition indispensable au fonctionnement des signatures et du hachage.
Quelles sont les exigences de la section 4.2 de la RFC 8949 pour l'encodage déterministe ?
Quatre exigences. La sérialisation préférentielle, afin que chaque entier, longueur et argument de tag utilise le moins d'octets possible. L'usage exclusif de longueurs définies, excluant ainsi les chaînes, tableaux ou maps à longueur indéfinie. Le tri des clés de map par comparaison lexicographique octet par octet de leur forme encodée, selon l'ordonnancement direct (one-step). Et le flottant le plus court, afin qu'une valeur utilise la plus petite représentation parmi la demi-précision, la simple ou la double précision qui la restitue exactement. La section 4.2.3 documente également un ancien ordonnancement privilégiant la longueur en premier, maintenu pour la compatibilité avec la RFC 7049, ce qui constitue une source directe de désaccord entre bibliothèques.
Comment les clés de map CBOR sont-elles ordonnées en encodage déterministe ?
Selon la RFC 8949, les clés sont triées en comparant leurs chaînes d'octets entièrement encodées de manière lexicographique, octet par octet. La RFC 7049, la version précédente, triait d'abord une clé encodée plus courte avant une plus longue. Les deux règles divergent dès lors que les clés ont des longueurs encodées différentes, par exemple une clé entière d'un octet côtoyant une clé de deux octets, et les bibliothèques conçues d'après des versions distinctes trient par conséquent la même map différemment tout en qualifiant chacune leur résultat de canonique.
Qu'est-ce que dCBOR et en quoi diffère-t-il du CBOR déterministe de la RFC 8949 ?
dCBOR est un profil plus strict défini dans le draft draft-mcnally-deterministic-cbor. Par rapport à la RFC 8949, il ajoute la réduction numérique, imposant qu'un flottant sans partie fractionnaire soit encodé sous forme d'entier lorsque cela est possible, faisant ainsi passer 2.0 à 2. Il canonicalise également chaque NaN sous une forme unique en demi-précision et rejette les maps contenant des clés dupliquées comme des erreurs de décodage. Parce qu'il réduit 2.0 en 2, une map valide sous le CBOR déterministe standard peut devenir une map dCBOR invalide lorsque deux clés se réduisent à la même valeur.
Pourquoi l'encodage déterministe est-il crucial pour les signatures COSE et CWT ?
COSE (RFC 9052) et CWT (RFC 8392) calculent une signature sur les octets CBOR encodés, et non sur une valeur abstraite. COSE construit une structure Sig_structure, l'encode en CBOR et signe ces octets. Si le signataire canonicalise une valeur d'une certaine façon et que le vérificateur la réencode d'une autre, ce dernier hachera des octets différents et la signature échouera, ou une valeur conçue pour exploiter les cas limites sera validée d'un côté tout en signifiant autre chose de l'autre. L'encodage déterministe est l'hypothèse fondamentale qui sécurise la signature d'une valeur structurée.
Les différentes bibliothèques CBOR produisent-elles les mêmes octets canoniques ?
Pas systématiquement. Lors de notre test portant sur cinq bibliothèques courantes en mode canonique, 26.3% des 3,061 valeurs ont produit plus d'un encodage canonique distinct, et 40% ont généré plus d'un verdict de validité. Les divergences se concentrent sur les clés dupliquées, la réduction des flottants, l'ordonnancement des maps et la sélection du flottant le plus court. Deux bibliothèques se sont accordées sur plus de 99.9% des valeurs alors que la paire la moins concordante n'a atteint que moins de 74%, ce qui montre que la cohérence dépend fortement des implémentations associées.
La valeur 2.0 s'encode-t-elle de la même façon que 2 en CBOR ?
Cela dépend de la bibliothèque et du profil. Dans le CBOR déterministe standard de la RFC 8949, le flottant 2.0 reste un flottant et s'encode différemment de l'entier 2. Sous dCBOR, la réduction numérique impose d'encoder 2.0 sous forme de l'entier 2. Lors de nos tests, une bibliothèque a réécrit 2.0 en 2 dans un mode nommé encodeCanonical, trois l'ont conservé comme flottant et la référence dCBOR a rejeté la forme flottante ; la même valeur canonicalisée sur deux stacks distinctes peut donc produire des octets signés divergents.
Comment encoder du CBOR de manière déterministe ?
Activez le mode déterministe ou canonique explicite de la bibliothèque au lieu de vous fier aux comportements par défaut, qui ne trient pas les maps et ne raccourcissent pas les flottants. Fixez le profil exact, RFC 8949 standard ou dCBOR strict, et veillez à ce que le signataire et le vérificateur utilisent le même. Effectuez des tests avec des cas limites, notamment des clés dupliquées, des flottants sans partie fractionnaire, le zéro négatif, NaN et des clés de map de longueurs hétérogènes. Si vous signez du CBOR, la configuration la plus sûre consiste à utiliser une bibliothèque et une version identiques aux deux extrémités, ou à confronter les octets à des vecteurs de test fixes.
Lectures complémentaires
- FIPS désactive-t-il le TLS post-quantique ? La même méthode différentielle, appliquant un jeu d'entrées unique à plusieurs bibliothèques, transposée au handshake TLS plutôt qu'à un format de sérialisation.
- Transparence des certificats post-quantique : 43% des logs static-CT signent déjà avec ML-DSA-44. Un autre domaine où les signatures sont calculées sur un encodage d'octets précis, et où l'analyse directe des octets révèle la réalité du terrain.
- Ce que prouvent les certificats. Vérifier une garantie cryptographique directement sur le réseau par construction plutôt que de faire confiance aux affirmations, selon la même logique d'analyse rigoureuse des octets appliquée ici.
La cryptographie sur laquelle vous comptez est-elle réellement effective ?
Notre audit à $100 évalue votre posture externe réelle en matière de cryptographie et de protocoles telle qu'un attaquant la cartographie, sur un périmètre dont vous avez validé la propriété et autorisé l'analyse par écrit, avec un intervenant senior lors de la restitution. Les hypothèses sur lesquelles reposent silencieusement vos signatures et vos jetons font partie intégrante de cette surface.
Réserver un audit à $100