Il CBOR deterministico non è deterministico tra le diverse librerie
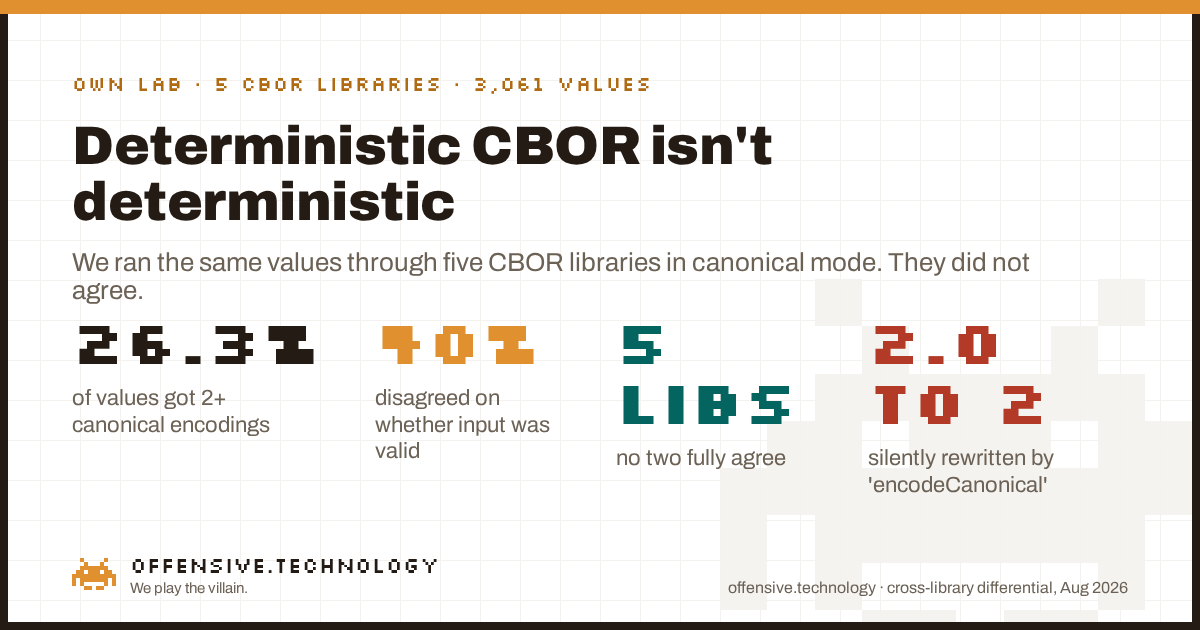
Il CBOR deterministico dovrebbe garantire che un singolo valore abbia esattamente una codifica in byte. Abbiamo sottoposto gli stessi 3,061 valori a cinque librerie CBOR ampiamente utilizzate nella loro modalità deterministica o canonica, e il 26.3% ha prodotto più di una codifica canonica distinta. Sul 40% dei valori le librerie non sono riuscite nemmeno a concordare se l'input fosse già in forma canonica valida. Questo è rilevante perché le firme COSE e CWT vengono calcolate sui byte codificati, quindi quando un valore viene firmato come canonico su una libreria e ricodificato come canonico su un'altra, le due possono trovarsi in disaccordo sui byte e la verifica della firma fallisce. Il caso più evidente: una libreria, all'interno di una funzione letteralmente chiamata encodeCanonical, riscrive silenziosamente il valore a virgola mobile 2.0 nell'intero 2, modificando i byte di cui il verificatore calcolerà l'hash.
Cosa dovrebbe fare il CBOR deterministico
CBOR, la Concise Binary Object Representation definita in RFC 8949, è il cugino binario compatto di JSON alla base di COSE, CWT, WebAuthn/FIDO2 e di una quantità crescente di formati IoT e supply-chain. Il CBOR base consente di scrivere lo stesso valore in molti modi: un intero può essere esteso con più byte del necessario, le chiavi di una mappa possono comparire in qualsiasi ordine, un float può essere memorizzato con precisione half, single o double. Questa flessibilità va bene finché non è necessario calcolare l'hash o firmare un valore, perché una firma è calcolata sui byte, e se i byte possono variare, la firma è priva di significato.
La codifica deterministica, descritta in RFC 8949 Section 4.2, è la soluzione: un insieme di regole che riconducono ogni valore a una e una sola codifica. Documenti più datati la chiamano CBOR canonico; il termine attuale è deterministico, ed entrambi indicano la stessa cosa. Il profilo principale richiede quattro elementi: interi e lunghezze nella forma più breve, solo lunghezze definite, float nella forma più breve e chiavi delle mappe ordinate per byte della loro forma codificata. Rispettando tutti e quattro i requisiti, in linea di principio, due codificatori qualsiasi emettono byte identici per valori identici. L'intero valore dello schema risiede in quella parola: identici. Quindi lo abbiamo testato.
Cosa abbiamo misurato e perché uno scettico dovrebbe fidarsi
Abbiamo costruito un oracolo differenziale: un unico set condiviso di valori di test, passato attraverso diverse librerie CBOR indipendenti nella loro modalità deterministica o canonica, confrontando l'output generato da ciascuna. È lo stesso metodo che abbiamo usato per analizzare il comportamento TLS tra diverse librerie sotto FIPS. Non richiede terze parti e non tocca l'infrastruttura di nessuno; è codice nostro, nel nostro laboratorio isolato, che codifica numeri generati da noi. Le librerie compaiono solo in una tabella di compatibilità neutrale, esattamente come una matrice di compatibilità dei browser elenca i vari browser.
Le cinque implementazioni, scelte per coprire diversi linguaggi e includere una baseline dCBOR rigorosa:
| Libreria | Versione | Modalità utilizzata |
|---|---|---|
| cbor2 (Python) | 6.1.4 | dumps(canonical=True) |
| cbor (Node.js) | 10.0.12 | encodeCanonical |
| fxamacker/cbor (Go) | v2.9.3 | Core Deterministic, duplicate-key enforced |
| ciborium (Rust) | 0.2.2 | encoder predefinito (nessuna modalità canonica dedicata) |
| bc-dcbor (Rust) | 0.15.2 | profilo dCBOR rigoroso |
Il corpus era composto da 3,061 valori: 61 vettori limite creati manualmente per coprire dieci punti decisionali noti, oltre a 3,000 valori tipizzati correttamente e generati casualmente a partire da un seed fisso, in modo che l'esecuzione sia esattamente riproducibile. Per ogni valore e ogni libreria abbiamo registrato due elementi: la ricodifica canonica in esadecimale e un verdetto, ovvero se la libreria ha accettato l'input come canonico già valido, lo ha decodificato come non canonico o lo ha rifiutato direttamente. Poi abbiamo calcolato le differenze. Il metodo è deliberatamente semplice, ed è questa la sua forza: non giudica chi ha ragione, conta solo dove implementazioni indipendenti, tutte dichiarate canoniche, si trovano in disaccordo.
Il risultato: 26% dei valori, più di una codifica canonica
Su 3,061 valori, 806 (26.3%) hanno prodotto più di una codifica canonica distinta tra le cinque librerie, e 1,223 (40.0%) hanno prodotto più di un verdetto di accettazione o rifiuto. Il solo corpus casuale, composto da valori ordinari che una reale applicazione potrebbe serializzare, si è diviso sulla codifica nel 26.2% dei casi. Non si tratta di un fenomeno limitato ai casi limite; un quarto dei valori comuni viene codificato in modo diverso a seconda del canonicalizzatore a cui viene affidato.
I vettori creati manualmente mostrano dove si concentra il disaccordo. Ogni riga seguente rappresenta un punto decisionale noto della codifica deterministica, e le percentuali indicano la frequenza con cui le cinque librerie si sono divise sulla codifica e sul verdetto di validità.
| Punto decisionale | Divergenza di codifica | Divergenza di verdetto |
|---|---|---|
| Chiavi di mappa duplicate | 100% | 100% |
| Riduzione numerica (da 2.0 a 2) | 83% | 83% |
| Ordinamento delle chiavi di mappa | 67% | 67% |
| Shortest float | 50% | 70% |
| Zero negativo | 33% | 100% |
| NaN non canonico | 25% | 63% |
| Minimalità degli interi | 0% | 60% |
| Lunghezze indefinite | 0% | 80% |
| Byte finali residui | 0% | 75% |
Osserva attentamente le ultime tre righe, perché sono le più sottili. Sulla minimalità degli interi, sulle lunghezze indefinite e sui byte spuri finali, le librerie che generano una codifica producono tutte la stessa codifica, quindi la colonna della divergenza di codifica è pari allo 0%. Tuttavia, sono in forte disaccordo sul fatto che l'input fosse accettabile all'origine: divergenze di verdetto dal 60% all'80%. Una libreria lascia correre e ricodifica un intero non minimale; un'altra lo segnala; una terza lo rifiuta. Per una pipeline di firma, un disaccordo tra accettazione e rifiuto è pericoloso quanto un disaccordo sui byte, perché stabilisce se un messaggio viene elaborato o meno.
L'impatto: una firma che risulta valida su uno stack e fallisce su un altro
Ecco perché questo esce dall'ambito dei dettagli marginali. COSE (RFC 9052) e CWT (RFC 8392) non firmano un valore astratto. COSE costruisce una Sig_structure, un array CBOR contenente il contesto, gli header protetti, i dati esterni e il payload, codifica tale array in CBOR e la firma viene calcolata su quei byte. Il verificatore ricostruisce la stessa struttura, la codifica e confronta la firma con i propri byte. L'intero schema presuppone che entrambe le parti producano gli stessi byte per lo stesso valore. La codifica deterministica è questo presupposto.
Ora osserva dove si rompe. Il singolo caso più chiaro nei nostri dati è il valore a virgola mobile 2.0, CBOR f94000:
| Libreria | Output canonico | Comportamento |
|---|---|---|
| cbor (Node.js) | 02 | ha ridotto il float all'intero 2 |
| cbor2 (Python) | f94000 | lo ha mantenuto come float |
| fxamacker/cbor (Go) | f94000 | lo ha mantenuto come float |
| ciborium (Rust) | f94000 | lo ha mantenuto come float |
| bc-dcbor (Rust) | reject | ha rifiutato la forma float |
Tre esiti distinti per un singolo numero banale, gestito da funzioni tutte pubblicizzate come canoniche o deterministiche. Un servizio che firma un token contenente il numero 2.0 utilizzando la libreria Node, la cui modalità canonica applica la riduzione numerica in stile dCBOR ed emette 02, e un verificatore che ricodifica il valore con la libreria Python o Go ottenendo f94000, calcoleranno l'hash di stringhe di byte differenti. La firma non risulterà valida, e l'errore sembrerà un misterioso bug intermittente di interoperabilità invece di ciò che è realmente: due librerie che presumono entrambe di essere canoniche, ma non adottano la stessa canonicalizzazione.
Il caso delle chiavi duplicate è peggiore sotto un altro aspetto. Data la mappa {1:1, 1:2} (input a201010102), Go e la baseline dCBOR la rifiutano, Python e Node la comprimono silenziosamente in una mappa a voce singola {1:2}, e l'encoder predefinito di Rust trasmette il duplicato inalterato. Cinque librerie, tre comportamenti rilevanti per la sicurezza: rifiutare, scartare silenziosamente i dati o preservare una struttura ambigua. Ognuna di queste discrepanze tra firmatario e verificatore rappresenta un punto in cui un attaccante può scegliere quale parte visualizza quale valore.
Due canoni e un tasso di rifiuto eloquente
Il motivo per cui questo è un problema strutturale e non una serie di bug isolati è che esiste più di un canone. La normale codifica deterministica di RFC 8949 è un obiettivo. Il profilo più rigoroso dCBOR, draft-mcnally-deterministic-cbor, è un altro, e fa deliberatamente di più: impone la riduzione numerica in modo che 2.0 diventi 2, canonicalizza ogni NaN in un'unica forma e rifiuta categoricamente le chiavi duplicate. Ci sono ulteriori proposte in corso, tra cui il lavoro IETF draft-ietf-cbor-cde Common Deterministic Encoding, che esiste proprio perché l'ecosistema non ha trovato convergenza. Adam Langley di Google ha catalogato almeno tre ordinamenti contrastanti delle chiavi di mappa già nel 2022, e la divergenza è ancora presente nel software distribuito: problemi reali di interoperabilità sono aperti contro la libreria CBOR di .NET riguardo all'ordinamento RFC 7049 rispetto a RFC 8949.
I nostri dati mostrano la scissione tra i due canoni in un'unica cifra evidente. La libreria dCBOR rigorosa ha rifiutato 1,221 dei 3,061 valori (40%) in quanto dCBOR non valido, anche se le altre librerie li hanno accettati e codificati canonicamente senza problemi secondo le regole standard di RFC 8949. Sui 1,840 valori che dCBOR ha accettato, ha concordato con le altre oltre il 99.9% delle volte. In altre parole, dCBOR e il CBOR deterministico di base non sono una coppia 'più rigorosa ma compatibile'; sono due linguaggi diversi che si sovrappongono solo su un sottoinsieme. Scegline uno sul firmatario e l'altro sul verificatore, e il 40% dei tuoi valori cadrà nella discrepanza.
I dati di concordanza a coppie dimostrano la stessa cosa dalla prospettiva opposta:
- cbor2 (Python) e fxamacker/cbor (Go) hanno concordato sul 99.93% dei valori. Due implementazioni indipendenti, in linguaggi differenti, che convergono realmente sulla codifica deterministica di base di RFC 8949. È un traguardo raggiungibile.
- cbor (Node.js) e ciborium (Rust) hanno concordato solo sul 73.7%. La coppia meno affine, distante per oltre un quarto dei valori, perché una applica la riduzione numerica e l'altra non canonicalizza affatto.
- L'encoder Rust predefinito non ha mai ordinato le mappe né ridotto i float. Non è un bug; ciborium semplicemente non dispone di una modalità canonica dedicata, ed è proprio questo il tranello. Uno sviluppatore che integra una libreria CBOR e non trova un'opzione per la modalità canonica firmerà tranquillamente byte non canonici senza mai accorgersene.
Come lo abbiamo misurato e i limiti oggettivi
Il dataset è nostro, generato da valori definiti da noi, e riportato in forma aggregata. Non abbiamo analizzato alcun sistema esterno e non abbiamo etichettato alcuna libreria come vulnerabile; una differenza di compatibilità non è una vulnerabilità, è una differenza di compatibilità. Lo scopo di specificare le versioni è la riproducibilità, non l'attribuzione di colpe.
- Il corpus. 61 vettori creati manualmente mirati su dieci punti decisionali (minimalità degli interi, ordinamento delle mappe, chiavi duplicate, shortest float, riduzione numerica, NaN, zero negativo, lunghezza indefinita, byte finali, interi di grandi dimensioni), oltre a 3,000 valori casuali con seed in modo che l'intera esecuzione sia deterministica e ripetibile.
- Il verdetto. Per ogni valore e libreria abbiamo registrato la ricodifica canonica in esadecimale e se la libreria ha trattato l'input come canonico valido, non canonico o rifiutato. La divergenza è calcolata sulle librerie che hanno restituito una codifica, quindi una libreria che rifiuta un valore non viene conteggiata erroneamente come produttrice di un valore differente.
- Modalità, non configurazioni predefinite dove esiste una modalità canonica. Ogni libreria è stata eseguita nella sua modalità deterministica o canonica documentata, ad eccezione di ciborium, che non ne ha una; abbiamo incluso il suo encoder predefinito proprio per mostrare cosa ottiene uno sviluppatore quando non viene offerta alcuna modalità canonica.
- I limiti. Cinque librerie non rappresentano l'intero ecosistema, e ciascuna libreria espone diversi parametri di rigore; un parametro diverso potrebbe modificare un valore numerico. Si tratta inoltre di comportamenti delle librerie, non della prova che un prodotto in produzione firmi attraverso una discrepanza. Il risultato dimostra che il disaccordo è reale, comune e ricade esattamente sui punti decisionali che compromettono le firme. È un avviso su un presupposto, non un'accusa contro un prodotto.
- Non è un bug di sicurezza del parser. I decoder CBOR hanno una propria cronologia di interventi di hardening, ad esempio le correzioni per la memoria e il denial of service negli avvisi di sicurezza di cbor2. Si tratta di problemi di robustezza del decoder, una classe separata. La confusione di canonicalizzazione non è un crash; sono due implementazioni affidabili che dissentono silenziosamente su quale sia il dato corretto.
Cosa fare se firmi dati in CBOR
Le indicazioni difensive sono ordinarie, ed è proprio per questo che sono corrette.
- Firma e verifica con la stessa libreria e la stessa versione su entrambe le estremità ovunque sia possibile. La firma tra stack differenti è esattamente il punto in cui quel 26% causa problemi.
- Definisci il profilo in modo esplicito. Stabilisci se richiedi il profilo deterministico di base di RFC 8949 o il profilo rigoroso dCBOR, documentalo e fai in modo che ogni partecipante utilizzi quello specifico. Non sono intercambiabili.
- Non affidarti mai alle impostazioni predefinite. Se una libreria non ha una modalità canonica, il suo output predefinito quasi certamente non è canonico, e non riceverai alcun avviso.
- Esegui test con vettori fissi, inclusi i casi più insidiosi: chiavi duplicate,
2.0, zero negativo, NaN e mappe le cui chiavi hanno lunghezze di codifica differenti. Se il tuo firmatario e il tuo verificatore producono byte diversi per uno qualsiasi di questi, hai individuato il tuo problema di interoperabilità prima che lo faccia un attaccante.
Il CBOR deterministico è un'ottima idea che funziona per la maggior parte dei casi, e due delle nostre cinque librerie hanno dimostrato che è possibile convergere al singolo byte. Tuttavia, 'per la maggior parte' non è la garanzia che la parola deterministico implica, e le firme digitali non tollerano approssimazioni. La discrepanza interessa un quarto dei valori ordinari, e si colloca alla base di formati da cui dipende gran parte della sicurezza.
Domande frequenti
Che cos'è il CBOR deterministico e in cosa differisce dal CBOR canonico?
Il CBOR deterministico è un insieme di regole aggiuntive rispetto al normale CBOR (RFC 8949) che impongono che un valore abbia esattamente una codifica in byte. È ciò che i documenti più datati chiamano CBOR canonico; lo standard attuale usa il termine deterministico, ed entrambi indicano la stessa cosa. RFC 8949 Section 4.2 fornisce le regole di base: interi e lunghezze nella forma più breve, solo lunghezze definite, float nella forma più breve e chiavi delle mappe ordinate. L'obiettivo è che due codificatori indipendenti emettano gli stessi byte per lo stesso valore, che è ciò su cui si basano la firma e l'hashing.
Cosa richiede RFC 8949 Section 4.2 per la codifica deterministica?
Quattro elementi. Serializzazione preferita, in modo che ogni intero, lunghezza e argomento di tag utilizzi il minor numero di byte possibile. Solo lunghezze definite, quindi niente stringhe, array o mappe a lunghezza indefinita. Ordinamento delle chiavi di mappa tramite confronto lessicografico per byte delle chiavi codificate, il cosiddetto ordinamento one-step. E shortest float, per cui un valore usa la dimensione minore tra half, single o double che lo rappresenti esattamente. La Sezione 4.2.3 documenta inoltre un ordinamento legacy basato prima sulla lunghezza mantenuto per compatibilità con RFC 7049, che è una fonte diretta di disaccordo tra le librerie.
Come vengono ordinate le chiavi delle mappe CBOR nella codifica deterministica?
In base a RFC 8949 le chiavi vengono ordinate confrontando le loro stringhe di byte completamente codificate in modo lessicografico, byte per byte. RFC 7049, la versione precedente, ordinava prima una chiave codificata più corta rispetto a una più lunga. Le due regole divergono ogni volta che le chiavi hanno lunghezze di codifica diverse, ad esempio una chiave intera da un byte accanto a una da due byte, e le librerie sviluppate in base a versioni diverse ordinano quindi la stessa mappa in modo differente pur definendo entrambe il risultato come canonico.
Cos'è dCBOR e come differisce dal CBOR deterministico di RFC 8949?
dCBOR è un profilo più rigoroso definito nella bozza draft-mcnally-deterministic-cbor. Rispetto a RFC 8949 aggiunge la riduzione numerica, per cui un float privo di parte frazionaria deve essere codificato come intero dove possibile e 2.0 deve diventare 2. Canonicalizza inoltre ogni NaN in una singola forma half-width e rifiuta le mappe con chiavi duplicate come errore di decodifica. Poiché riduce 2.0 a 2, una mappa valida sotto il normale CBOR deterministico può diventare una mappa dCBOR non valida quando due chiavi collassano sullo stesso valore ridotto.
Perché la codifica deterministica è importante per le firme COSE e CWT?
COSE (RFC 9052) e CWT (RFC 8392) calcolano una firma sui byte CBOR codificati, non su un valore astratto. COSE costruisce una Sig_structure, la codifica in CBOR e firma quei byte. Se chi firma canonicalizza un valore in un modo e chi verifica lo ricodifica in un altro, il verificatore calcola l'hash di byte differenti e la firma fallisce, oppure un valore costruito ad hoc supera una parte e assume un significato diverso sull'altra. La codifica deterministica è il presupposto che rende sicura la firma di un valore strutturato.
Le diverse librerie CBOR producono gli stessi byte canonici?
Non sempre. Nel nostro test su cinque librerie ampiamente utilizzate in modalità canonica, il 26.3% di 3,061 valori ha prodotto più di una codifica canonica distinta, e il 40% ha prodotto più di un verdetto di validità. I disaccordi si concentrano su chiavi duplicate, riduzione dei float, ordinamento delle mappe e shortest-float. Due librerie hanno concordato su oltre il 99.9% dei valori, mentre la coppia meno affine ha coinciso su meno del 74%, quindi la concordanza dipende fortemente da quali implementazioni vengono abbinate.
Il valore 2.0 viene codificato come 2 in CBOR?
Dipende dalla libreria e dal profilo. Nel normale CBOR deterministico RFC 8949 il float 2.0 rimane un float e viene codificato diversamente dall'intero 2. Sotto dCBOR, la riduzione numerica impone che 2.0 sia codificato come l'intero 2. Nel nostro test una libreria ha riscritto 2.0 in 2 sotto una modalità denominata encodeCanonical, tre lo hanno mantenuto come float e la baseline dCBOR ha rifiutato la forma float, quindi lo stesso valore canonicalizzato su due stack differenti può produrre byte firmati diversi.
Come si codifica CBOR in modo deterministico?
Attiva la modalità esplicita deterministica o canonica della libreria anziché affidarti alle impostazioni predefinite, che non ordinano le mappe né riducono i float. Fissa il profilo esatto, RFC 8949 standard o dCBOR rigoroso, e assicurati che firmatario e verificatore usino lo stesso. Esegui test con casi limite, in particolare chiavi duplicate, float senza parte frazionaria, zero negativo, NaN e chiavi di mappa a lunghezza mista. Se firmi dati in CBOR, l'architettura più sicura prevede l'uso della stessa identica libreria e versione su entrambe le estremità, oppure il confronto dei byte rispetto a vettori di test fissi.
Letture correlate
- FIPS disabilita il TLS post-quantum? Lo stesso metodo differenziale, un set di input attraverso molte librerie, applicato all'handshake TLS anziché a un formato di serializzazione.
- Certificate Transparency post-quantum: il 43% dei log static-CT firma già con ML-DSA-44. Un altro contesto in cui le firme vengono calcolate su una codifica in byte precisa, e dove l'analisi diretta dei byte rivela il comportamento effettivo.
- Cosa dimostrano i certificati. Verificare una garanzia crittografica direttamente dal traffico per costruzione invece di fidarsi delle definizioni nominali, lo stesso principio alla base del conteggio dei byte adottato qui.
La crittografia su cui fai affidamento è realmente presente?
La nostra verifica da $100 analizza la tua reale postura crittografica e di protocollo esterna esattamente come la mapperebbe un attaccante, su un perimetro di cui hai confermato la proprietà e autorizzato per iscritto, con un operatore senior per l'esposizione dei risultati. I presupposti su cui fanno silenziosamente affidamento le tue firme e i tuoi token fanno parte di quella superficie.
Prenota una verifica da $100