Verifica delle firme JCS: sei librerie RFC 8785 su sette concordano sulla forma canonica, una no
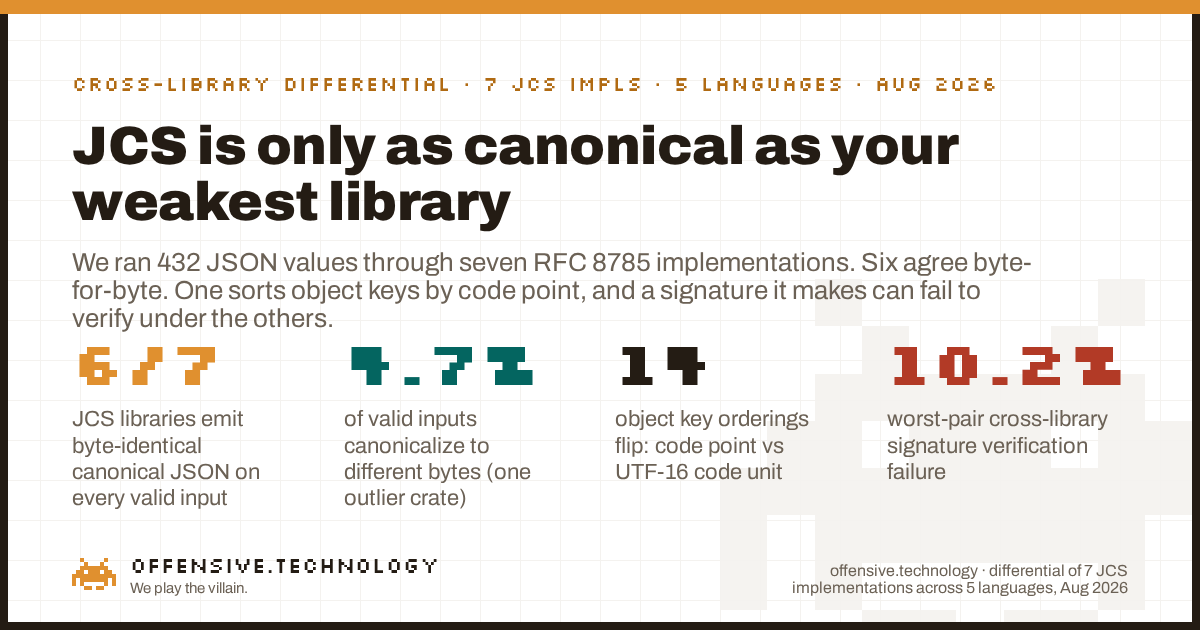
Sei delle sette librerie di canonicalizzazione JSON RFC 8785 che abbiamo testato producono output identici a livello di byte su ogni input valido; la settima no, e questo singolo disaccordo genera una discrepanza nella verifica delle firme. Abbiamo processato 432 valori JSON validi attraverso sette implementazioni indipendenti di JCS in cinque linguaggi. Tutte e sette corrispondono all'esempio pratico nell'Appendice B di RFC 8785, quindi tutte e sette sono autenticamente JCS. Ma una di esse, il crate Rust serde_jcs, ordina le chiavi degli oggetti per code point Unicode invece che per code unit UTF-16 come richiesto dalla specifica. Sul 4.7% dei nostri input validi emette byte diversi rispetto alle altre sei. Se si trova da un lato di una firma e una qualsiasi delle altre librerie si trova dall'altro, un oggetto JSON firmato da una può fallire la verifica con l'altra. Quando lo abbiamo simulato direttamente con HMAC, l'abbinamento peggiore tra librerie non è riuscito a verificare il 10.2% dei messaggi che avrebbe dovuto accettare.
Perché un byte di disaccordo è un bug di sicurezza
Il JSON semplice offre troppa libertà. Lo stesso oggetto logico può essere scritto con le chiavi in qualsiasi ordine, con qualsiasi quantità di spazi bianchi e con numeri rappresentati in molti modi equivalenti. Questa flessibilità va bene finché non si vuole firmare l'oggetto, perché una firma viene calcolata sui byte, non sul significato. Se il firmatario e il verificatore serializzano l'oggetto in modo diverso, il verificatore calcola l'hash di byte diversi e la firma non risulta valida. Peggio ancora, se un attaccante riesce a trovare due stringhe di byte che una parte tratta come uguali e l'altra come diverse, si ottiene un attacco di canonicalizzazione: un messaggio appositamente creato che viene verificato come una cosa pur avendone un'altra come significato. Un'indagine del 2026 cataloga i fallimenti di canonicalizzazione come una classe di vulnerabilità ricorrente esattamente in questi sistemi.
RFC 8785, il JSON Canonicalization Scheme, è la soluzione. Elimina ogni grado di libertà: i nomi dei membri degli oggetti vengono ordinati, i numeri vengono serializzati con l'algoritmo Number.prototype.toString di ECMAScript, le stringhe ricevono l'escape minimo consentito e gli spazi bianchi non significativi vengono rimossi. Passando lo stesso valore JSON a qualsiasi implementazione conforme si ottengono gli stessi byte, quindi entrambe le parti di una firma concordano su ciò che è stato firmato. Lo schema è ora fondamentale. Il protocollo Agent-to-Agent firma una agent card come JWS sui contenuti della scheda canonicalizzati con JCS, e consiglia ai client di verificare almeno una firma prima di ritenere attendibile la scheda. Le verifiable credential e i flussi JWS detached fanno lo stesso. I byte canonici costituiscono il perimetro di attendibilità.
La domanda interessante non è quindi se la specifica sia solida. È se le librerie effettivamente distribuite concordino tra loro. Lo abbiamo misurato.
Cosa abbiamo testato
Abbiamo raccolto sette implementazioni indipendenti di JCS in cinque linguaggi, scelte perché sono quelle che uno sviluppatore probabilmente scaricherebbe da un registro di pacchetti:
canonicalize4.0.0 per JavaScript (npm), il modulo di derivazione erdtman ampiamente utilizzato.- L'implementazione di riferimento
cyberphone/json-canonicalizationin Python, il codice di riferimento dell'autore stesso. - Il pacchetto PyPI
jcs, versione 0.2.1, un'implementazione Python separata. gowebpki/jcsv1.0.1 per Go.- L'implementazione di riferimento
cyberphone/json-canonicalizationin Go. serde_jcs0.1.0 per Rust.java-json-canonicalization1.1 per Java (l'artefatto Maven di erdtman).
Ciascuna è stata eseguita in un proprio container con immagine ufficiale, in modo che il risultato sia riproducibile e nessuna libreria potesse influenzarne un'altra. Abbiamo costruito un corpus di 440 input predisposti, 432 dei quali JSON validi, etichettati per categoria: formattazione numerica vicino ai limiti IEEE-754 ed ECMAScript, zero negativo, casi di ordinamento delle chiavi con caratteri ordinati diversamente in UTF-16 rispetto al code point, escaping e normalizzazione Unicode, chiavi duplicate, surrogati isolati e casi limite strutturali. Abbiamo fornito byte identici a ciascuna libreria e catturato il rispettivo output canonico, preservando i byte in modo esatto affinché nessuna divergenza potesse dipendere dai nostri strumenti.
Due oracoli sono stati eseguiti sugli output. Il primo è un puro differenziale: per ogni input, le librerie che hanno avuto successo producono gli stessi byte? Il secondo è l'attacco stesso: presa una chiave HMAC-SHA256 fissa, si fa canonicalizzare un input a una libreria firmataria per applicarvi il tag, quindi si fa canonicalizzare lo stesso input a una libreria verificatrice per controllare il tag. Ogni coppia ordinata di librerie, ogni input. Un errore in questo caso corrisponde a una firma cross-library che dovrebbe verificare e non lo fa.
Prima di dare credito a qualsiasi dato, abbiamo verificato la correttezza di base. Tutte e sette le implementazioni riproducono l'output canonico dell'Appendice B di RFC 8785 byte per byte, compresi i numeri volutamente complessi e la stringa con escape. Sono tutte autenticamente JCS. È questo che rende significativo il disaccordo di seguito: non si tratta di una libreria difettosa contro una corretta, si tratta di sette librerie apparentemente corrette, una delle quali sbaglia silenziosamente su un caso limite.
Il risultato: il 4.7% degli input validi diverge, e sempre nello stesso modo
Sui 426 input validi e non ambigui che ogni libreria ha accettato, sei su sette erano identiche a livello di byte su ciascuno di essi. Non simili: identiche, su ogni singolo valore. La settima, serde_jcs, era in disaccordo su 20 di quei 426 input, pari al 4.7%, ed è rimasta l'unica minoranza ogni volta. Quando le librerie JCS non sono d'accordo, nel nostro corpus, si tratta di una libreria contro tutte le altre.
| Categoria | Input | Divergenti | Causa |
|---|---|---|---|
| Ordinamento delle chiavi | 80 | 14 | ordine per code point vs UTF-16 |
| Formattazione dei numeri | 194 | 6 | interi superiori a 253 |
| Zero negativo | 18 | 0 | tutte concordano (-0 su 0) |
| Escaping Unicode | 76 | 0 | tutte concordano |
| Normalizzazione Unicode | 27 | 0 | tutte concordano (nessun NFC/NFD implicito) |
| Strutturali | 30 | 0 | tutte concordano |
Due categorie racchiudono l'intera divergenza, e la prima è quella rilevante.
La discrepanza nell'ordinamento delle chiavi: code point contro code unit UTF-16
RFC 8785 specifica chiaramente che i nomi dei membri degli oggetti sono ordinati in base alla loro codifica UTF-16, confrontando le code unit. Questo dettaglio esiste perché JCS eredita l'ordinamento delle stringhe di ECMAScript, e le stringhe ECMAScript sono sequenze di code unit UTF-16. Per i caratteri nel Basic Multilingual Plane, l'ordine per code unit e l'ordine per code point coincidono, quindi quasi nessuno se ne accorge. Divergono solo per i caratteri del piano supplementare, quelli oltre U+FFFF che sono codificati come coppia di surrogati. Un'emoji come U+1F600 ha il code point 0x1F600, che è maggiore di un carattere del Basic Multilingual Plane come U+E000. Ma la sua codifica UTF-16 inizia con la code unit del surrogato alto 0xD83D, che è minore di 0xE000. Pertanto, secondo le due regole, le due chiavi vengono ordinate in ordine opposto.
Quattordici dei nostri input di ordinamento delle chiavi hanno toccato esattamente questo punto critico, e serde_jcs ordina per code point dove le altre sei ordinano per code unit UTF-16. Ecco il caso più piccolo, un oggetto con due chiavi:
input:      {"😀": 1, "\uE000": 2}

six libs:   {"😀":1,"\uE000":2}     😀 first  (0xD83D < 0xE000)
serde_jcs:  {"\uE000":2,"😀":1}     😀 last   (0x1F600 > 0xE000)
Il carattere per uso privato U+E000 viene mostrato qui con escape per leggibilità; JCS in realtà lo emette come byte letterale, e su questo punto entrambe le librerie concordano. Ciò su cui non concordano è l'ordine dei due membri, e questo basta. Firmando l'oggetto a sinistra con HMAC o JWS e passandolo a un verificatore che esegue serde_jcs, il verificatore canonicalizza l'oggetto a destra, calcola un tag diverso e rifiuta una firma che era perfettamente valida. Invertendo i ruoli accade la stessa cosa nella direzione opposta. Le due librerie presentano un disaccordo costante e silenzioso su quale sia la forma canonica di questo oggetto.
Questa non è una nuova ed esotica scoperta sullo schema. È la classica trappola di conformità di JCS, segnalata nell'RFC stesso e in precedenti analisi sulla canonicalizzazione. Ciò che la nostra misurazione aggiunge è il tasso di base: su sette librerie distribuite e installabili che superano tutte il test vector dell'RFC, una continua a sbagliare su questo aspetto oggi. La conformità all'esempio principale non implica la conformità sui casi limite.
La discrepanza sui numeri, e perché la riportiamo separatamente
Gli altri sei input divergenti sono interi superiori a 253, come 9007199254740993. JCS specifica che i numeri sono serializzati tramite l'algoritmo number-to-string di ECMAScript, che fa uso di un double IEEE-754. Al di sopra di 253 un double non può più rappresentare ogni intero, quindi 9007199254740993 arrotonda a 9007199254740992. Sei librerie fanno esattamente questo. serde_jcs preserva invece l'intero in modo esatto. Segnaliamo questo dato con trasparenza come un riscontro più debole rispetto alla discrepanza sull'ordinamento delle chiavi: RFC 8785 è definito solo su numeri nell'intervallo double di IEEE-754, quindi un intero superiore a 253 è plausibilmente un input fuori specifica che un chiamante non dovrebbe mai passare. Tuttavia è pur sempre JSON sintatticamente valido, produce comunque una divergenza a livello di byte tra librerie reali, e un sistema che accetta identificatori numerici più grandi di un safe integer JavaScript può incorrervi. Lo manteniamo nel differenziale e fuori dal titolo principale.
Tutto il resto ha retto. Lo zero negativo è stato canonicalizzato a 0 ovunque. Nessuna libreria ha applicato silenziosamente la normalizzazione Unicode, quindi una stringa in NFC e la stessa stringa in NFD sono rimaste distinte su tutte e sette, il che è corretto: JCS non normalizza. L'escaping delle stringhe è stato uniforme. I disaccordi sono circoscritti e specifici, ed è questo che li rende pericolosi anziché evidenti.
Trasformare la divergenza in un fallimento della firma
Una divergenza nei byte canonici è interessante solo se rompe qualcosa. Quindi abbiamo fatto sì che rompesse qualcosa. Utilizzando una chiave fissa HMAC-SHA256, abbiamo fatto agire ciascuna libreria come firmatario e ciascuna libreria come verificatore, su ogni input valido in cui entrambe hanno prodotto byte: 42 coppie ordinate, 11,754 verifiche totali. Un controllo fallisce quando i byte canonici del firmatario e i byte canonici del verificatore differiscono, poiché in tal caso i tag differiscono.
Su tutte le coppie, l'1.87% delle verifiche è fallito. Quel dato è diluito dalle sei librerie che non sono mai in disaccordo tra loro, quindi il modo corretto di leggerlo è per coppia. Ogni coppia che non include serde_jcs ha verificato al 100%. Ogni coppia che unisce serde_jcs a una libreria conforme è fallita sugli input divergenti. L'abbinamento peggiore, con il riferimento Go cyberphone come firmatario e serde_jcs come verificatore, ha fallito 15 verifiche su 147, un tasso di fallimento nella verifica delle firme del 10.2% tra due librerie che superano entrambe il test vector dell'RFC. In una distribuzione che mescola linguaggi diversi attraverso un perimetro di attendibilità, e i sistemi agent-to-agent fanno esattamente questo, questo è il fallimento che si osserverebbe nella realtà.
L'altro asse: alcune librerie rifiutano ciò che altre accettano
Accanto alle divergenze a livello di byte, abbiamo riscontrato un'ampia superficie di discrepanza accettazione/rifiuto: 288 input per i quali almeno una libreria ha restituito un output e un'altra ha restituito un errore. Non si tratta di un disaccordo sulla forma canonica, ma costituisce comunque un problema di interoperabilità a sé stante, che divide le librerie in blocchi distinti.
- Scalari di primo livello. I due parser di derivazione di riferimento,
cyberphonein Go eerdtmanin Java, rifiutano un semplice0o"x"come input di primo livello; gli altri lo canonicalizzano. Se il proprio protocollo si trova a firmare uno scalare JSON isolato, metà di queste librerie non lo elaborerà affatto. - Chiavi duplicate. Dato
{"a":1,"a":2}, tutti e tre i parser Go e Java rifiutano l'oggetto direttamente, mentre le implementazioni JavaScript, Python e Rust mantengono silenziosamente l'ultimo valore. La gestione delle chiavi duplicate è così poco specificata che un firmatario e un verificatore possono non concordare nemmeno sul fatto che il messaggio sia valido. - Surrogati isolati. Un surrogato non accoppiato in una stringa non è un JSON valido, e le librerie si comportano in modi disparati: una emette il carattere di sostituzione U+FFFD, una inoltra direttamente i byte non-UTF-8 grezzi e le altre rifiutano. Ognuno di questi comportamenti da un lato e uno diverso dall'altro rappresenta una divergenza garantita.
Teniamo questo dato fuori dal dato principale perché si tratta di una questione di accettazione contro rifiuto, non di byte contro byte, ma l'insegnamento è lo stesso: la garanzia risiede nell'implementazione, non nell'acronimo di tre lettere.
L'immagine speculare del nostro risultato su CBOR
Abbiamo eseguito lo stesso esperimento su un'altra codifica, il CBOR binario, ottenendo un quadro opposto. Lì, il CBOR deterministico non era deterministico tra librerie diverse: il 26% dei valori produceva più di una codifica canonica, e il disaccordo era diffuso sull'intero insieme delle librerie. JCS è il gemello ordinato. Le sue regole sono più stringenti e le sue librerie per lo più concordano, quindi la divergenza si riduce a una singola eccezione e a una manciata di input limite anziché a un quarto di tutto. Questo contrasto è la conclusione pratica. La sicurezza di uno schema di canonicalizzazione non è una proprietà dello schema da solo; è il prodotto della precisione dello schema e della conformità delle librerie specifiche utilizzate. JCS offre uno schema migliore. Ma non esime dal verificare le proprie librerie.
Testa la tua libreria in dieci secondi
Non serve il nostro ambiente di test per scoprire da quale parte di questa discrepanza ci si trovi. Canonicalizza questo oggetto con la libreria JCS utilizzata nella tua applicazione:
{ "😀": 1, "\uE000": 2 }Se l'output posiziona prima la chiave con l'emoji, la tua libreria ordina per code unit UTF-16 ed è conforme all'RFC e alla maggioranza. Se posiziona prima la chiave per uso privato, la tua libreria ordina per code point e sarà in disaccordo con una controparte conforme su qualsiasi oggetto le cui chiavi mescolano caratteri del piano supplementare e del Basic Multilingual Plane. Esegui la stessa verifica su entrambi i lati di ogni perimetro di attendibilità che firma JSON, in particolare dove le due parti usano linguaggi diversi, e soprattutto se le chiavi possono contenere caratteri Unicode manipolabili da un attaccante.
Come lo abbiamo misurato, affinché chi è scettico possa fidarsi dei numeri
Il dataset è interamente nostro e sintetico. Non abbiamo toccato servizi di terze parti, non abbiamo scansionato nulla né raccolto dati reali; ogni input è un valore JSON che abbiamo scritto per verificare un limite specifico. Le librerie sono pacchetti open source pubblici, testati nelle loro versioni pubblicate, e nominati perché descrivere il comportamento di un'implementazione di una specifica è l'intero scopo di un test di conformità, non un'accusa verso nessuno.
- Isolamento. Ciascuna implementazione è stata eseguita in un proprio container con immagine ufficiale, leggendo il medesimo corpus e scrivendo il proprio output canonico preservando esattamente i byte, in modo che un'eventuale divergenza sia imputabile alla libreria e non alla nostra pipeline.
- Ground truth. Tutte e sette riproducono l'output canonico dell'Appendice B di RFC 8785 byte per byte, ed è così che sappiamo che si tratta di autentico JCS anziché di serializzatori approssimativi.
- Due oracoli indipendenti. Un differenziale a livello di byte e una verifica live sign-then-verify HMAC su tutte le 42 coppie ordinate di librerie. I fallimenti di firma sono il differenziale reso concreto, non un'affermazione isolata.
- Suddivisione trasparente. Separiamo le divergenze a livello di byte su input validi (il dato principale) dai comportamenti di accettazione/rifiuto e dagli input plausibilmente fuori specifica, in modo che nessun numero abbia un peso superiore a quanto dovuto.
L'ambiente di test, il generatore del corpus e i runner per ciascuna libreria sono conservati in modo che il metodo sia riproducibile; solo i dati aggregati sono riportati qui.
Perché questo è importante, e i limiti oggettivi
La canonicalizzazione sta tornando silenziosamente a essere fondamentale. La spinta verso l'assegnazione di identità verificabili agli agenti autonomi, attraverso agent card firmate e verifiable credential, fa passare le decisioni di attendibilità attraverso una pipeline JCS-then-sign, spesso con firmatario e verificatore scritti in linguaggi diversi da team diversi. Questa è l'esatta condizione in cui un divario di conformità di una sola libreria si trasforma in una discrepanza di verifica. La buona notizia emersa da questa analisi è che JCS garantisce un'ottima interoperabilità: scegliendo due librerie conformi, queste risultano indistinguibili. La cattiva notizia è che la conformità non è garantita dall'etichetta, e l'unico aspetto in cui una libreria distribuita sbaglia ancora, l'ordinamento delle chiavi per i caratteri del piano supplementare, è sia raggiungibile da un attaccante sia facile da non notare.
Un risultato senza i suoi limiti è solo marketing, quindi ecco i confini dell'analisi.
- Sette librerie, non l'intero ecosistema. Queste sono implementazioni comuni e installabili, ma ne esistono altre, e un'implementazione C o C-sharp non testata potrebbe trovarsi da entrambi i lati della discrepanza. Il metodo è generalizzabile; i conteggi esatti sono specifici di questo set a queste versioni.
- Bassa probabilità nei payload tipici. La discrepanza sull'ordinamento delle chiavi incide solo quando le chiavi dell'oggetto contengono caratteri del piano supplementare, che sono rari nelle normali agent card o nelle credenziali con nomi di campo ASCII. Il rischio è reale ma condizionato, e un attaccante che controlla una chiave è colui che rende tale condizione vera intenzionalmente.
- Le versioni evolvono. Le librerie vengono corrette. Un crate che oggi ordina per code point potrebbe essere conforme domani, motivo per cui il consiglio duraturo è quello di testare la versione specifica distribuita anziché fidarsi o meno di un nome.
- La discrepanza numerica riguarda input limite. Gli interi superiori a 253 ricadono al di fuori dell'intervallo per cui JCS è definito, pertanto trattiamo tale divergenza come un riscontro secondario e più debole, escludendolo dal dato principale.
Domande frequenti
Cos'è il JSON Canonicalization Scheme (JCS)?
JCS, definito in RFC 8785, è un insieme di regole che trasforma un valore JSON in una stringa di byte deterministica. Ordina i nomi dei membri degli oggetti, serializza i numeri con l'algoritmo number-to-string di ECMAScript, applica l'escaping minimo delle stringhe ed elimina gli spazi bianchi non significativi. Due parti che partono dallo stesso valore JSON producono gli stessi byte, potendo così calcolarne l'hash o firmare quei byte ottenendo una corrispondenza esatta. JCS è ciò che consente di firmare un documento JSON senza dover concordare preventivamente la sua esatta rappresentazione testuale.
Perché la verifica delle firme JCS fallisce tra linguaggi diversi?
Fallisce quando la libreria del firmatario e quella del verificatore non concordano sui byte canonici per lo stesso valore. Nel nostro test, sei implementazioni su sette hanno concordato byte per byte, ma un crate Rust ha ordinato le chiavi degli oggetti per code point Unicode anziché per code unit UTF-16 come richiesto da RFC 8785. Per un oggetto le cui chiavi contengono un'emoji o un altro carattere del piano supplementare, le due librerie emettono le chiavi in un ordine diverso, quindi il tag calcolato sull'oggetto differisce e la verifica fallisce.
Le implementazioni di JCS producono lo stesso output canonico?
Per la maggior parte sì. Su 426 input validi e non ambigui forniti a sette implementazioni in cinque linguaggi, sei sono risultate identiche a livello di byte su ciascun input e tutte e sette sono risultate conformi all'Appendice B di RFC 8785. Una ha evidenziato divergenze sul 4.7% degli input, e ogni divergenza riguardava o una chiave d'oggetto nel piano supplementare o un intero superiore a 2 alla 53esima potenza. JCS offre un'ottima interoperabilità sui dati ordinari e si divide solo su casi limite specifici.
In che modo JCS previene il bypass della firma?
Elimina la libertà concessa dal JSON semplice, ovvero l'ordine delle chiavi, gli spazi bianchi e le molteplici rappresentazioni di un numero, garantendo che un valore corrisponda a una sola stringa di byte e non possa essere ricodificato in un equivalente dall'aspetto diverso. Questa garanzia è valida solo se entrambe le parti utilizzano un'implementazione conforme. Un'implementazione non conforme reintroduce l'ambiguità che JCS doveva rimuovere, motivo per cui la conformità dell'implementazione, non il semplice utilizzo di JCS, è la proprietà determinante.
In che modo A2A utilizza JCS per firmare le agent card?
Nel protocollo Agent-to-Agent un'agent card è un documento JSON che descrive l'identità e le funzionalità di un agente. La sua firma è un JWS applicato al contenuto della scheda dopo che questo è stato canonicalizzato con JCS, e ai client viene consigliato di verificare almeno una firma prima di ritenere attendibile una scheda. Poiché i byte firmati sono l'output di JCS, un client la cui libreria JCS esegue la canonicalizzazione in modo diverso rispetto a quella del firmatario calcolerà un input differente per la verifica.
Che cos'è un attacco di confusione nella canonicalizzazione?
Sfrutta una discrepanza tra il modo in cui un firmatario e un verificatore riducono un messaggio alla forma canonica. Se i due producono byte diversi per lo stesso valore logico, un attaccante può predisporre un input che viene verificato come una cosa pur significandone un'altra, oppure provocare il fallimento di una firma legittima. La canonicalizzazione è una classe di vulnerabilità ricorrente nei sistemi che firmano dati strutturati, poiché la sicurezza si basa sul fatto che ogni parte calcoli l'identica forma canonica.
RFC 8785 è uno standard IETF ufficiale?
RFC 8785 è una Informational RFC dell'IETF pubblicata a giugno 2020. È una specifica stabile e di riferimento per il JSON Canonicalization Scheme, citata da lavori successivi su JSON firmato, verifiable credential e sicurezza agent-to-agent. Lo status Informational significa che non si tratta di uno Standard Internet obbligatorio, ma rappresenta la definizione a cui le implementazioni fanno riferimento.
Letture correlate
- Il CBOR deterministico non è deterministico tra le librerie. Lo stesso differenziale applicato a un'altra codifica, il CBOR binario, dove il 26% dei valori ha ottenuto più di una forma canonica.
- Sicurezza dei server MCP remoti: cosa mostra un censimento di 19,321 server. La superficie di tooling degli agenti che queste schede firmate intendono proteggere, misurata su scala di popolazione.
- Cosa dimostrano i certificati. Leggere le garanzie crittografiche direttamente dai byte invece di fidarsi dell'etichetta, lo stesso metodo applicato ai certificati.