Deterministische CBOR is niet deterministisch tussen libraries
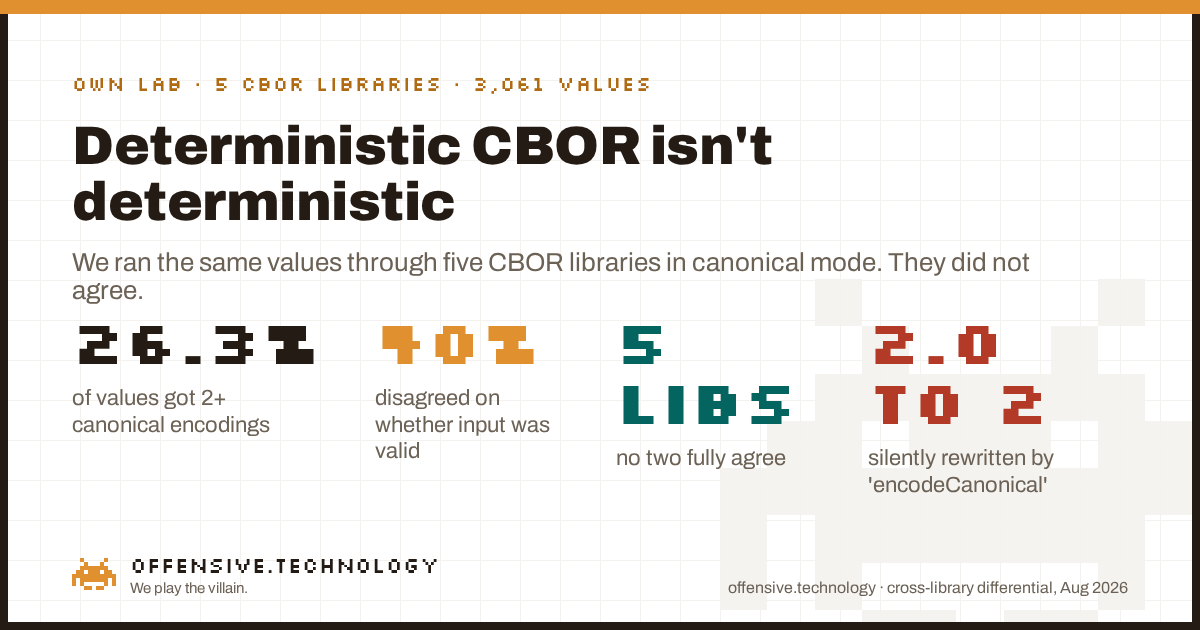
Deterministische CBOR hoort te garanderen dat één waarde exact één byte-encoding heeft. We hebben dezelfde 3,061 waarden door vijf veelgebruikte CBOR-libraries gehaald in hun deterministische of canonieke modus, en bij 26.3% resulteerde dit in meer dan één verschillende canonieke encoding. Bij 40% van de waarden waren de libraries het er niet eens over eens of de invoer al een geldige canonieke vorm had. Dat maakt uit, omdat COSE- en CWT-signatures worden berekend over de geëncodeerde bytes. Wanneer een waarde op de ene library als canoniek wordt ondertekend en op een andere opnieuw als canoniek wordt geëncodeerd, kunnen beide van mening verschillen over de bytes waardoor de signature-verificatie mislukt. Het meest uitgesproken geval: één library, onder een functie die letterlijk encodeCanonical heet, herschrijft stilletjes de floating-pointwaarde 2.0 naar de integer 2, waardoor de bytes veranderen die een verifier hasht.
Wat deterministische CBOR hoort te doen
CBOR, de Concise Binary Object Representation gedefinieerd in RFC 8949, is het compacte binaire neefje van JSON dat de basis vormt voor COSE, CWT, WebAuthn/FIDO2 en een groeiende reeks IoT- en supply-chain-formaten. Bij standaard CBOR kan dezelfde waarde op meerdere manieren worden geschreven: een integer kan worden opgevuld met meer bytes dan nodig, de keys van een map kunnen in willekeurige volgorde staan, en een float kan worden opgeslagen in half-, single- of double-precisie. Die flexibiliteit is prima totdat je een waarde moet hashen of ondertekenen, want een signature geldt voor bytes, en als de bytes kunnen variëren, is de signature waardeloos.
Deterministische encoding, beschreven in RFC 8949 Section 4.2, is de oplossing: een set regels die elke waarde reduceert tot één en slechts één encoding. Oudere documentatie noemt dit canonieke CBOR; de huidige term is deterministisch, en beide betekenen hetzelfde. Het kernprofiel vereist vier zaken: de kortste vorm voor integers en lengtes, uitsluitend vaste lengtes, de kortste vorm voor floats, en map-keys gesorteerd op bytewise volgorde van hun geëncodeerde vorm. Als je al deze vier goed toepast, leveren twee willekeurige encoders in theorie identieke bytes op voor identieke waarden. De volledige waarde van dit schema zit in dat woord identiek. Dus hebben we het getest.
Wat we hebben gemeten, en waarom een scepticus het kan vertrouwen
We hebben een differentieel orakel gebouwd: één gedeelde set testwaarden, ingevoerd in verschillende onafhankelijke CBOR-libraries in hun deterministische of canonieke modus, waarbij de uitvoer van elk werd vergeleken. Dit is dezelfde methode die we hebben gebruikt om cross-library TLS-gedrag onder FIPS in kaart te brengen. Er is geen externe partij voor nodig en het raakt niemands infrastructuur; het is onze eigen code, in ons eigen tijdelijke lab, waarmee we zelfbedachte getallen encoderen. De libraries verschijnen uitsluitend in een neutrale compatibiliteitstabel, net zoals een compatibiliteitstabel van browsers namen van browsers toont.
De vijf implementaties, gekozen om meerdere talen te dekken en een strikte dCBOR-baseline op te nemen:
| Library | Versie | Gebruikte modus |
|---|---|---|
| cbor2 (Python) | 6.1.4 | dumps(canonical=True) |
| cbor (Node.js) | 10.0.12 | encodeCanonical |
| fxamacker/cbor (Go) | v2.9.3 | Core Deterministic, duplicate-key afgedwongen |
| ciborium (Rust) | 0.2.2 | standaard encoder (geen specifieke canonieke modus) |
| bc-dcbor (Rust) | 0.15.2 | strikt dCBOR-profiel |
Het corpus bestond uit 3,061 waarden: 61 handmatig samengestelde edge-vectoren die tien bekende beslispunten dekken, plus 3,000 willekeurig gegenereerde, goedgevormde waarden vanuit een vaste seed zodat de testrun exact reproduceerbaar is. Voor elke waarde en elke library hebben we twee zaken vastgelegd: de canonieke her-encoding als hex, en een oordeel, namelijk of de library de invoer accepteerde als reeds geldige canonieke vorm, deze decodeerde als niet-canoniek, of direct afwees. Vervolgens hebben we de verschillen bepaald. De methode is bewust eenvoudig, wat meteen de kracht is: het oordeelt niet over wie gelijk heeft, het telt alleen waar onafhankelijke implementaties, die allemaal beweren canoniek te zijn, van mening verschillen.
Het resultaat: 26% van de waarden heeft meer dan één canonieke encoding
Over de 3,061 waarden heen leverden 806 (26.3%) meer dan één verschillende canonieke encoding op onder de vijf libraries, en 1,223 (40.0%) leverden meer dan één acceptatie- of afwijzingsoordeel op. Het willekeurige corpus alleen al, gewone waarden die een echte applicatie zou serialiseren, splitste in 26.2% van de gevallen op encoding. Dit is geen fenomeen dat zich beperkt tot randgevallen; een kwart van de alledaagse waarden wordt anders geëncodeerd, afhankelijk van welke canonicalizer je gebruikt.
De handmatig samengestelde vectoren laten zien waar de verschillen zich concentreren. Elke rij hieronder is een bekend beslispunt bij deterministische encoding, en de percentages geven aan hoe vaak de vijf libraries uiteenliepen op de encoding en op het geldigheidsoordeel.
| Beslispunt | Encoding-verschil | Oordeel-verschil |
|---|---|---|
| Dubbele map-keys | 100% | 100% |
| Numerieke reductie (2.0 naar 2) | 83% | 83% |
| Map-key-volgorde | 67% | 67% |
| Kortste float | 50% | 70% |
| Negatieve nul | 33% | 100% |
| Niet-canonieke NaN | 25% | 63% |
| Minimale integer-omvang | 0% | 60% |
| Onbepaalde lengtes | 0% | 80% |
| Overtollige bytes | 0% | 75% |
Lees de laatste drie rijen aandachtig, want dat zijn de subtiele gevallen. Bij minimale integer-omvang, onbepaalde lengtes en overtollige data produceren de libraries die een encoding afleveren allemaal dezelfde encoding, waardoor de kolom met encoding-verschillen op 0% staat. Maar ze verschillen sterk van mening over de vraag of de invoer überhaupt acceptabel was: 60% tot 80% oordeel-verschillen. De ene library accepteert het schouderophalend en her-encodeert een niet-minimale integer; een andere markeert het; een derde wijst het af. Voor een signing-pipeline is een verschil tussen accepteren en weigeren net zo gevaarlijk als een verschil in bytes, omdat het bepaalt of een bericht überhaupt wordt verwerkt.
De consequentie: een signature die valideert op de ene stack en faalt op de andere
Dit is waarom dit verder gaat dan futiliteiten. COSE (RFC 9052) en CWT (RFC 8392) ondertekenen geen abstracte waarde. COSE bouwt een Sig_structure, een CBOR-array met de context, de protected headers, externe data en de payload, encodeert die array als CBOR, en de signature wordt berekend over die bytes. De verifier reconstrueert dezelfde structuur, encodeert deze, en controleert de signature tegen zijn eigen bytes. Het volledige schema gaat ervan uit dat beide kanten dezelfde bytes produceren voor dezelfde waarde. Deterministische encoding is die aanname.
Zie nu hoe dit misgaat. Het duidelijkste afzonderlijke geval in onze data is de floating-pointwaarde 2.0, CBOR f94000:
| Library | Canonieke uitvoer | Wat er gebeurde |
|---|---|---|
| cbor (Node.js) | 02 | reduceerde de float naar de integer 2 |
| cbor2 (Python) | f94000 | behield het als een float |
| fxamacker/cbor (Go) | f94000 | behield het als een float |
| ciborium (Rust) | f94000 | behield het als een float |
| bc-dcbor (Rust) | reject | weigerde de float-vorm |
Drie verschillende uitkomsten voor één triviaal getal, onder functies die allemaal worden aangeprezen als canoniek of deterministisch. Een service die een token ondertekent met het getal 2.0 met behulp van de Node-library, waarvan de canonieke modus numerieke reductie in dCBOR-stijl toepast en 02 uitvoert, en een verifier die de waarde opnieuw encodeert met de Python- of Go-library en f94000 verkrijgt, zullen verschillende bytestrings hashen. De signature zal niet valideren, en de fout zal lijken op een mysterieuze, intermitterende interoperabiliteitsbug in plaats van wat het werkelijk is: twee libraries die beide denken dat ze canoniek zijn, maar niet dezelfde canonieke standaard hanteren.
Het geval met dubbele keys is op een andere manier nog erger. Gegeven de map {1:1, 1:2} (invoer a201010102), weigeren Go en de dCBOR-baseline deze, vouwen Python en Node deze stilletjes samen tot een map met één entry {1:2}, en laat de standaard Rust-encoder het duplicaat onaangeroerd door. Vijf libraries, drie security-relevante gedragingen: weigeren, stilletjes data laten vallen, of een ambigue structuur behouden. Elk van deze mismatches tussen een signer en een verifier biedt een aanvaller de kans om te bepalen welke kant welke waarde ziet.
Twee canons, en een afwijzingspercentage dat boekdelen spreekt
De reden dat dit een structureel probleem is en geen verzameling geïsoleerde bugs, is dat er meer dan één canon bestaat. Standaard RFC 8949 deterministische encoding is het ene doel. Het striktere dCBOR-profiel, draft-mcnally-deterministic-cbor, is een ander, en doet bewust meer: het verplicht numerieke reductie zodat 2.0 verandert in 2, canonicaliseert elke NaN naar één enkele vorm, en wijst dubbele keys resoluut af. Er zijn nog meer voorstellen in omloop, waaronder het IETF draft-ietf-cbor-cde Common Deterministic Encoding-werk, dat juist bestaat omdat het ecosysteem nog niet convergeert. Adam Langley van Google bracht al in 2022 minstens drie conflicterende map-key-volgordes in kaart, en het verschil wordt nog steeds uitgeleverd: er staan reële interoperabiliteitsproblemen open tegen .NET's CBOR-library over de volgorde volgens RFC 7049 versus RFC 8949.
Onze eigen cijfers tonen de splitsing tussen de twee canons als één enkel hard cijfer. De strikte dCBOR-library wees 1,221 van de 3,061 waarden (40%) af als geen geldige dCBOR, hoewel de andere libraries ze probleemloos accepteerden en canoniek encodeerden volgens de standaardregels van RFC 8949. Bij de 1,840 waarden die dCBOR wel accepteerde, was het in meer dan 99.9% van de gevallen eens met de andere. Met andere woorden, dCBOR en core deterministische CBOR vormen geen strikter-maar-compatibel paar; het zijn twee verschillende talen die overlappen op een subset. Kies de ene op de signer en de andere op de verifier, en 40% van je waarden valt in het gat.
De paarsgewijze overeenstemmingscijfers maken hetzelfde punt vanuit de andere richting:
- cbor2 (Python) en fxamacker/cbor (Go) waren het eens over 99.93% van de waarden. Twee onafhankelijke implementaties, in verschillende talen, die daadwerkelijk convergeren op RFC 8949 core deterministische encoding. Het is haalbaar.
- cbor (Node.js) en ciborium (Rust) waren het slechts eens over 73.7%. Het minst vergelijkbare paar, met een verschil bij meer dan een kwart van de waarden, omdat de ene numerieke reductie toepast en de andere helemaal niet canonicaliseert.
- De standaard Rust-encoder sorteerde maps nooit en maakte floats nooit korter. Dat is geen bug; ciborium heeft simpelweg geen speciale canonieke modus, en dat is precies de valkuil. Een ontwikkelaar die naar een CBOR-library grijpt en geen canonieke optie vindt, zal zonder argwaan niet-canonieke bytes ondertekenen zonder het ooit te merken.
Hoe we het hebben gemeten, en de eerlijke beperkingen
De dataset is van onszelf, opgebouwd uit door ons bedachte waarden, en gerapporteerd op geaggregeerd niveau. We hebben geen extern systeem benaderd en geen enkele library als kwetsbaar aangemerkt; een compatibiliteitsverschil is geen kwetsbaarheid, het is een compatibiliteitsverschil. Het vermelden van versies dient uitsluitend de reproduceerbaarheid.
- Het corpus. 61 handgemaakte vectoren gericht op tien beslispunten (minimale integer-omvang, map-volgorde, dubbele keys, kortste float, numerieke reductie, NaN, negatieve nul, onbepaalde lengte, overtollige bytes, grote integers), plus 3,000 gezaaide willekeurige waarden zodat de gehele run deterministisch en herhaalbaar is.
- Het oordeel. Voor elke waarde en library hebben we de canonieke her-encoding in hex vastgelegd en genoteerd of de library de invoer behandelde als geldig-canoniek, niet-canoniek, of afwees. Afwijkingen worden geteld over de libraries die een encoding teruggaven, zodat een library die een waarde weigert niet onterecht wordt meegeteld als het produceren van een afwijkende encoding.
- Modi, geen standaarden waar een canonieke modus bestaat. Elke library werd uitgevoerd in de gedocumenteerde deterministische of canonieke modus, behalve ciborium, dat er geen heeft; we hebben de standaard encoder juist meegenomen om te laten zien wat een ontwikkelaar krijgt wanneer er geen canonieke modus wordt aangeboden.
- De beperkingen. Vijf libraries vormen niet het hele ecosysteem, en elke library biedt verschillende instellingen voor striktheid; een andere instelling kan een percentage verschuiven. Dit betreft ook library-gedrag, geen bewijs dat een operationeel product daadwerkelijk tekent over een mismatch heen. De bevinding is dat het verschil reëel en gangbaar is, en exact landt op de beslispunten die signatures breken. Het is een waarschuwing over een aanname, geen beschuldiging aan het adres van een product.
- Niet hetzelfde als een parser-veiligheidsbug. CBOR-decoders hebben hun eigen geschiedenis qua hardening, zoals de geheugen- en denial-of-service-fixes in cbor2's advisories. Dat zijn kwesties rond decoder-robuustheid, een aparte categorie. Canonicalisatie-verwarring is geen crash; het zijn twee integere implementaties die in stilte van mening verschillen over de waarheid.
Wat te doen als je CBOR ondertekent
De defensieve adviezen zijn saai, en juist daaraan herken je dat ze kloppen.
- Onderteken en verifieer met dezelfde library en versie aan beide kanten waar mogelijk. Cross-stack signing is precies waar die 26% opspeelt.
- Leg het profiel expliciet vast. Bepaal of je standaard RFC 8949 core deterministic of strikt dCBOR vereist, leg dat vast en zorg dat elke deelnemer exact die variant gebruikt. Ze zijn niet uitwisselbaar.
- Vertrouw nooit op standaardinstellingen. Als een library geen canonieke modus heeft, is de standaarduitvoer vrijwel zeker niet canoniek, en je krijgt geen waarschuwing.
- Test tegen vaste vectoren, inclusief de lastige gevallen: dubbele keys,
2.0, negatieve nul, NaN, en maps waarvan de keys verschillende geëncodeerde lengtes hebben. Als je signer en verifier verschillende bytes produceren voor een van deze gevallen, heb je je interoperabiliteitsbug gevonden voordat een aanvaller dat doet.
Deterministische CBOR is een goed idee dat meestal werkt, en twee van onze vijf libraries bewezen dat je tot op de byte nauwkeurig kunt convergeren. Maar meestal is niet de garantie die het woord deterministisch inhoudt, en signatures verdragen geen meestal. De kloof is een kwart van alle alledaagse waarden breed, en bevindt zich onder formaten waar veel security van afhangt.
Veelgestelde vragen
Wat is deterministische CBOR, en hoe verschilt het van canonieke CBOR?
Deterministische CBOR is een set aanvullende regels bovenop standaard CBOR (RFC 8949) die afdwingen dat één waarde exact één byte-encoding heeft. Het is wat oudere documenten canonieke CBOR noemen; de huidige standaard gebruikt het woord deterministisch, en beide betekenen hetzelfde. RFC 8949 Section 4.2 geeft de kernregels: kortste-vorm-integers en -lengtes, uitsluitend vaste lengtes, kortste-vorm-floats, en gesorteerde map-keys. Het doel is dat twee onafhankelijke encoders dezelfde bytes produceren voor dezelfde waarde, wat essentieel is voor signing en hashing.
Wat vereist RFC 8949 Section 4.2 voor deterministische encoding?
Vier dingen. Preferred serialization, zodat elke integer, lengte en tag-argument zo min mogelijk bytes gebruikt. Uitsluitend vaste lengtes, dus geen strings, arrays of maps met onbepaalde lengte. Map-key-ordening via lexicografische vergelijking byte voor byte van de geëncodeerde keys, de one-step ordering. En shortest-float, zodat een waarde de kleinste van half-, single- of double-precisie gebruikt die deze exact representeert. Section 4.2.3 documenteert ook een oudere length-first key-volgorde die behouden is voor RFC 7049-compatibiliteit, wat een directe bron is van meningsverschillen tussen libraries.
Hoe worden CBOR-map-keys geordend bij deterministische encoding?
Onder RFC 8949 worden keys gesorteerd door hun volledig geëncodeerde bytestrings lexicografisch te vergelijken, byte voor byte. RFC 7049, de vorige versie, sorteerde een kortere geëncodeerde key altijd vóór een langere. De twee regels botsen zodra keys verschillende geëncodeerde lengtes hebben, bijvoorbeeld een 1-byte integer-key naast een 2-byte integer-key, waardoor libraries gebaseerd op verschillende versies dezelfde map verschillend sorteren terwijl beide het resultaat canoniek noemen.
Wat is dCBOR en hoe verschilt het van RFC 8949 deterministische CBOR?
dCBOR is een strikter profiel gedefinieerd in de draft draft-mcnally-deterministic-cbor. Bovenop RFC 8949 voegt het numerieke reductie toe, wat betekent dat een float zonder fractioneel deel moet worden geëncodeerd als een integer waar dat past, waardoor 2.0 verandert in 2. Het canonicaliseert ook elke NaN naar één half-width vorm en wijst maps met dubbele keys af als een decodeerfout. Omdat het 2.0 reduceert naar 2, kan een map die geldig is onder standaard deterministische CBOR ongeldig worden onder dCBOR wanneer twee keys samenvallen op dezelfde gereduceerde waarde.
Waarom maakt deterministische encoding uit voor COSE- en CWT-signatures?
COSE (RFC 9052) en CWT (RFC 8392) berekenen een signature over geëncodeerde CBOR-bytes, niet over een abstracte waarde. COSE bouwt een Sig_structure, encodeert deze als CBOR en ondertekent die bytes. Als de signer een waarde op de ene manier canonicaliseert en de verifier deze op een andere manier her-encodeert, hasht de verifier andere bytes en faalt de signature, of een specifiek gemanipuleerde randwaarde wordt aan de ene kant geaccepteerd en betekent aan de andere kant iets anders. Deterministische encoding is de aanname die het ondertekenen van een gestructureerde waarde veilig maakt.
Produceren verschillende CBOR-libraries dezelfde canonieke bytes?
Niet altijd. In onze test van vijf veelgebruikte libraries in canonieke modus produceerde 26.3% van de 3,061 waarden meer dan één verschillende canonieke encoding, en 40% leverde meer dan één geldigheidsoordeel op. De verschillen concentreren zich rond dubbele keys, float-reductie, map-volgorde en shortest-float. Twee libraries waren het over meer dan 99.9% van de waarden eens, terwijl het minst vergelijkbare paar op minder dan 74% overeenkwam. Overeenstemming hangt dus sterk af van welke implementaties je combineert.
Wordt 2.0 hetzelfde geëncodeerd als 2 in CBOR?
Dat hangt af van de library en het profiel. In standaard RFC 8949 deterministische CBOR blijft de float 2.0 een float en wordt deze anders geëncodeerd dan de integer 2. Onder dCBOR vereist numerieke reductie dat 2.0 wordt geëncodeerd als de integer 2. In onze test herschreef één library 2.0 naar 2 onder een modus genaamd encodeCanonical, drie behielden het als een float, en de dCBOR-baseline wees de float-vorm af. Dezelfde waarde kan, gecanonicaliseerd op twee verschillende stacks, dus verschillende ondertekende bytes opleveren.
Hoe encodeer je CBOR deterministisch?
Schakel de expliciete deterministische of canonieke modus van de library in in plaats van te vertrouwen op standaardwaarden, die maps niet sorteren en floats niet verkorten. Leg het exacte profiel vast, standaard RFC 8949 of strikt dCBOR, en zorg dat signer en verifier hetzelfde profiel hanteren. Test met randgevallen, met name dubbele keys, floats zonder fractioneel deel, negatieve nul, NaN, en map-keys van verschillende lengtes. Als je CBOR ondertekent, is het veiligste ontwerp om aan beide kanten identieke libraries en versies te gebruiken, of bytes te verifiëren tegen vaste testvectoren.
Gerelateerde artikelen
- Schakelt FIPS post-quantum TLS uit? Dezelfde differentiële methode, één set inputs over meerdere libraries, toegepast op de TLS-handshake in plaats van een serialisatieformaat.
- Certificate transparency post-quantum: 43% van de static-CT-logs ondertekent al met ML-DSA-44. Een ander domein waar signatures worden berekend over een exacte byte-encoding, en waar het inspecteren van de bytes het echte verhaal vertelt.
- Wat de certificaten bewijzen. Een cryptografische garantie direct aflezen uit het netwerkverkeer in plaats van blind te vertrouwen op het label, dezelfde insteek als het tellen van bytes hier.
Is de crypto waar je op vertrouwt daadwerkelijk aanwezig?
Onze $100-check analyseert je reële externe cryptografische en protocol-posture zoals een aanvaller die in kaart brengt, binnen een scope waarvan je schriftelijk hebt bevestigd en geautoriseerd dat deze van jou is, met een senior operator bij de toelichting. De aannames waar je signatures en tokens stilzwijgend op leunen, vormen een direct onderdeel van dat aanvalsoppervlak.
Boek een $100-check