JCS-handtekeningverificatie: zes van de zeven RFC 8785-libraries zijn het eens over de canonieke vorm, één niet
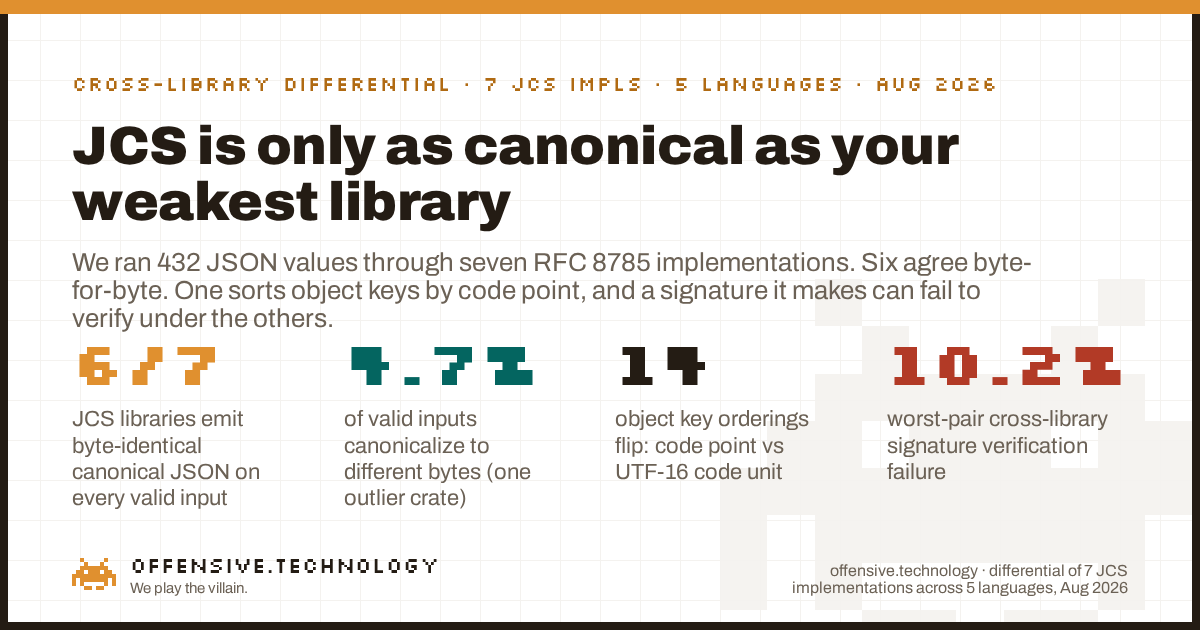
Zes van de zeven RFC 8785 JSON-canonicalisatielibraries die we hebben getest, produceren byte-identieke output op elke geldige invoer; de zevende doet dat niet, en dat ene verschil leidt tot een split in handtekeningverificatie. We hebben 432 geldige JSON-waarden door zeven onafhankelijke JCS-implementaties in vijf talen gehaald. Alle zeven komen overeen met het uitgewerkte voorbeeld in RFC 8785 Appendix B, dus alle zeven zijn daadwerkelijk JCS. Maar één ervan, de Rust-crate serde_jcs, sorteert object keys op Unicode code point in plaats van op UTF-16 code unit zoals de specificatie vereist. Op 4,7% van onze geldige invoerwaarden levert dit andere bytes op dan bij de overige zes. Als deze library aan de ene kant van een handtekening staat en een van de andere libraries aan de andere kant, kan verificatie van een JSON-object dat door de een is ondertekend, mislukken bij de ander. Toen we dat direct simuleerden met HMAC, faalde de slechtste library-combinatie bij het verifiëren van 10,2% van de berichten die geaccepteerd hadden moeten worden.
Waarom één byte verschil een security bug is
Standaard JSON geeft je te veel vrijheid. Hetzelfde logische object kan worden geschreven met de keys in elke willekeurige volgorde, met willekeurige witruimte, en met getallen die op veel equivalente manieren worden genoteerd. Die flexibiliteit is prima totdat je het object wilt ondertekenen, omdat een handtekening wordt berekend over bytes, niet over betekenis. Als de ondertekenaar en de verifieerder het object anders serialiseren, hasht de verifieerder andere bytes en klopt de handtekening niet. Erger nog, als een aanvaller twee byte strings kan vinden die de ene kant als gelijk behandelt en de andere als verschillend, krijg je een canonicalization-aanval: een gemanipuleerd bericht dat als het ene verifieert terwijl het iets anders betekent. Een onderzoek uit 2026 catalogiseert canonicalisatiefouten als een terugkerende kwetsbaarheidsklasse in precies dit soort systemen.
RFC 8785, het JSON Canonicalization Scheme, is de oplossing. Het legt elke vrijheidsgraad vast: object member names worden gesorteerd, getallen worden geserialiseerd met het ECMAScript-Number.prototype.toStringalgoritme, strings krijgen de minimaal toegestane escaping, en niet-significante witruimte wordt weggelaten. Voer dezelfde JSON-waarde in bij elke conforme implementatie en je krijgt dezelfde bytes, zodat beide kanten van een handtekening het eens zijn over wat er is ondertekend. Het schema is inmiddels dragend geworden. Het Agent-to-Agent-protocol ondertekent een agent card als een JWS over de inhoud van de card gecanonicaliseerd met JCS, en adviseert clients om ten minste één handtekening te verifiëren voordat de card wordt vertrouwd. Verifiable credentials en detached JWS-flows doen hetzelfde. De canonieke bytes vormen de trust boundary.
De interessante vraag is dus niet of de specificatie deugt. Het is of de libraries die mensen daadwerkelijk in productie nemen met elkaar overeenkomen. We hebben het gemeten.
Wat we hebben getest
We hebben zeven onafhankelijke JCS-implementaties verzameld in vijf programmeertalen, gekozen omdat het de implementaties zijn die een ontwikkelaar waarschijnlijk uit een package registry haalt:
canonicalize4.0.0 voor JavaScript (npm), de veelgebruikte module uit de erdtman-lijn.- De
cyberphone/json-canonicalization-referentie-implementatie in Python, de eigen referentiecode van de auteur. - Het PyPI-pakket
jcs, versie 0.2.1, een afzonderlijke Python-implementatie. gowebpki/jcsv1.0.1 voor Go.- De
cyberphone/json-canonicalization-referentie-implementatie in Go. serde_jcs0.1.0 voor Rust.java-json-canonicalization1.1 voor Java (het erdtman Maven-artefact).
Elk draaide in zijn eigen container op basis van de officiële image, zodat het resultaat reproduceerbaar is en geen enkele library een andere kon beïnvloeden. We hebben een corpus opgebouwd van 440 speciaal samengestelde invoerwaarden, waarvan 432 geldige JSON, gelabeld per categorie: getalopmaak rond de grenzen van IEEE-754 en ECMAScript, negatieve nul, key-sorteercases met tekens die onder UTF-16 anders ordenen dan onder code point, Unicode-escaping en normalisatie, dubbele keys, losse surrogates, en structurele edge cases. We hebben identieke bytes aan elke library gevoed en de canonieke output vastgelegd, waarbij de bytes exact bewaard bleven zodat geen enkel verschil een artefact van onze eigen tooling kon zijn.
Twee orakels evalueerden de output. De eerste is een directe differentiële controle: produceren de libraries die slaagden voor elke invoer dezelfde bytes? De tweede is de aanval zelf: neem een vaste HMAC-SHA256-sleutel, laat een signer-library een invoer canonicaliseren en taggen, en laat vervolgens een verifier-library dezelfde invoer canonicaliseren en de tag controleren. Elk geordend paar libraries, elke invoer. Een fout hierbij is een cross-library-handtekening die zou moeten verifiëren maar dat niet doet.
Voordat we hierop vertrouwden, hebben we de ground truth gecontroleerd. Alle zeven implementaties reproduceren de canonieke output in RFC 8785 Appendix B byte voor byte, inclusief de opzettelijk lastige getallen en de geëscapete string. Het zijn allemaal echte JCS-implementaties. Dat is wat het onderstaande verschil betekenisvol maakt: het is geen kapotte library versus een correcte, het zijn zeven ogenschijnlijk correcte libraries waarvan er één stilletjes faalt bij een edge case.
Het resultaat: 4,7% van de geldige invoerwaarden splitst, en altijd op dezelfde manier
Op de 426 geldige, eenduidige invoerwaarden die elke library accepteerde, waren zes van de zeven byte-identiek op alle waarden. Niet bij benadering: identiek, op elke afzonderlijke waarde. De zevende, serde_jcs, verschilde bij 20 van die 426 invoerwaarden, wat 4,7% is, en het was telkens de enige uitzondering. Wanneer JCS-libraries van mening verschillen in ons corpus, is het één library tegen de rest.
| Categorie | Invoerwaarden | Divergerend | Oorzaak |
|---|---|---|---|
| Key-sortering | 80 | 14 | code point- vs UTF-16-volgorde |
| Getalopmaak | 194 | 6 | integers boven 253 |
| Negatieve nul | 18 | 0 | allemaal gelijk (-0 naar 0) |
| Unicode-escaping | 76 | 0 | allemaal gelijk |
| Unicode-normalisatie | 27 | 0 | allemaal gelijk (geen stilzwijgende NFC/NFD) |
| Structureel | 30 | 0 | allemaal gelijk |
Twee categorieën zijn verantwoordelijk voor de volledige divergentie, en de eerste is degene die ertoe doet.
De key-sort-split: code point versus UTF-16 code unit
RFC 8785 is er expliciet over dat object member names worden gesorteerd op hun UTF-16-codering, waarbij code units worden vergeleken. Dit detail bestaat omdat JCS de stringordening van ECMAScript erft, en ECMAScript-strings reeksen van UTF-16 code units zijn. Voor tekens in het Basic Multilingual Plane zijn de code-unit-volgorde en code-point-volgorde gelijk, waardoor bijna niemand het merkt. Ze lopen pas uiteen bij tekens in supplementary planes, de tekens boven U+FFFF die als surrogate pair zijn gecodeerd. Een emoji zoals U+1F600 heeft code point 0x1F600, wat groter is dan een teken uit het Basic Multilingual Plane zoals U+E000. Maar de UTF-16-codering ervan begint met de high-surrogate code unit 0xD83D, wat kleiner is dan 0xE000. Onder de twee regels sorteren de twee keys dus in tegengestelde volgorde.
Veertien van onze key-sorting-invoerwaarden raakten precies deze breuklijn, en serde_jcs sorteert op code point waar de andere zes sorteren op UTF-16 code unit. Hier is het kleinste geval, een object met twee keys:
input:      {"😀": 1, "\uE000": 2}

six libs:   {"😀":1,"\uE000":2}     😀 first  (0xD83D < 0xE000)
serde_jcs:  {"\uE000":2,"😀":1}     😀 last   (0x1F600 > 0xE000)
Het private-use-teken U+E000 wordt hier voor de leesbaarheid weergegeven als escape; JCS voert dit daadwerkelijk uit als een lineaire byte, en beide libraries zijn het over dat deel eens. Waar ze het niet over eens zijn, is de volgorde van de twee members, en dat is voldoende. Onderteken het object aan de linkerkant met HMAC of JWS, overhandig het aan een verifier die draait op serde_jcs, en de verifier canonicaliseert naar het object aan de rechterkant, berekent een andere tag en wijst een volkomen geldige handtekening af. Draai de rollen om en hetzelfde gebeurt in de andere richting. De twee libraries hebben een stabiel, stilzwijgend meningsverschil over wat de canonieke vorm van dit object is.
Dit is geen exotische nieuwe ontdekking over het schema. Het is de klassieke JCS-conformiteitsvalkuil, die al wordt genoemd in het RFC zelf en in eerdere artikelen over canonicalisatie. Wat onze meting toevoegt is de base rate: van de zeven uitgebrachte, installeerbare libraries die allemaal slagen voor de testvector van het RFC zelf, doet één het vandaag de dag nog steeds verkeerd. Conformiteit met het hoofdvoorbeeld impliceert geen conformiteit bij de edge cases.
De getallensplit, en waarom we deze apart rapporteren
De andere zes afwijkende invoerwaarden zijn integers groter dan 253, zoals 9007199254740993. JCS specificeert dat getallen worden geserialiseerd via het ECMAScript number-to-string-algoritme, dat verloopt via een IEEE-754 double. Boven 253 kan een double niet langer elk geheel getal representeren, dus 9007199254740993 rondt af naar 9007199254740992. Zes libraries doen precies dat. serde_jcs behoudt in plaats daarvan de exacte integer. We merken dit eerlijkheidshalve aan als een minder sterke bevinding dan de key-sort-split: RFC 8785 is alleen gedefinieerd voor getallen binnen het bereik van een IEEE-754 double, dus een integer boven 253 is aantoonbaar out-of-spec invoer die een caller nooit zou moeten doorgeven. Maar het is nog steeds syntactisch geldige JSON, het veroorzaakt nog steeds een split op byteniveau tussen echte libraries, en een systeem dat numerieke identifiers accepteert die groter zijn dan een JavaScript safe integer kan hier nog steeds tegenaan lopen. We houden dit in de differentiële analyse en buiten de kop.
Al het andere hield stand. Negatieve nul werd gecanonicaliseerd naar 0 overal. Geen enkele library paste stilzwijgend Unicode-normalisatie toe, dus een string in NFC en dezelfde string in NFD bleven verschillend bij alle zeven, wat correct is: JCS normaliseert niet. String-escaping was uniform. De verschillen zijn specifiek en beperkt van omvang, wat ze gevaarlijk maakt in plaats van voor de hand liggend.
Van de split naar een gefaalde handtekening
Een verschil in canonieke bytes is pas interessant als het iets breekt. Dus hebben we gezorgd dat het iets brak. Met één vaste HMAC-SHA256-sleutel lieten we elke library optreden als signer en elke library als verifier, over elke geldige invoer waarbij beide bytes produceerden: 42 geordende paren, 11.754 verificatiecontroles in totaal. Een controle faalt wanneer de canonieke bytes van de signer en de canonieke bytes van de verifier verschillen, omdat de tags dan verschillen.
Over alle paren faalde 1,87% van de verificaties. Dat getal wordt verdund door de zes libraries die het nooit met elkaar oneens zijn, dus de eerlijke manier om het te interpreteren is per paar. Elk paar dat niet gebruikmaakt van serde_jcs verifieerde voor 100%. Elk paar dat serde_jcs combineert met een conforme library faalde op de gesplitste invoerwaarden. De slechtste combinatie, de cyberphone-Go-referentie als signer en serde_jcs als verifier, faalde bij 15 van de 147 controles, een foutpercentage van 10,2% bij handtekeningverificatie tussen twee libraries die beide slagen voor de RFC-testvector. In een deployment die talen mengt over een trust boundary heen, en agent-to-agent-systemen doen precies dat, is dit het probleem dat je daadwerkelijk zou zien.
De andere as: sommige libraries weigeren wat andere accepteren
Naast de splits op byteniveau vonden we een aanzienlijk accept-versus-reject-oppervlak: 288 invoerwaarden waarbij ten minste één library output retourneerde en een andere een foutmelding gaf. Dit is geen meningsverschil over de canonieke vorm, maar het is op zichzelf een interoperabiliteitsrisico dat de libraries in verschillende kampen verdeelt.
- Top-level scalars. De twee parsers uit de referentielijn,
cyberphonein Go enerdtmanin Java, weigeren een losse0of"x"als top-level invoer; de andere canonicaliseren dit wel. Als je protocol ooit een losse JSON-scalar ondertekent, zal de helft van deze libraries dit überhaupt niet verwerken. - Dubbele keys. Gegeven
{"a":1,"a":2}, weigeren alle drie de Go- en Java-parsers het object direct, terwijl de JavaScript-, Python- en Rust-implementaties stilzwijgend de laatste waarde behouden. De afhandeling van duplicate keys is dermate ongespecificeerd dat een signer en verifier van mening kunnen verschillen over de vraag of het bericht überhaupt geldig is. - Losse surrogates. Een ongepaarde surrogate in een string is ongeldige JSON, en de libraries lopen uiteen: één stuurt het vervangingsteken U+FFFD uit, één geeft de ruwe niet-UTF-8-bytes direct door, en de rest weigert. Elk van deze gedragingen aan de ene kant en een ander gedrag aan de andere kant is een gegarandeerde divergentie.
We laten dit buiten het hoofdcijfer omdat het accept-versus-reject betreft en niet byte-versus-byte, maar de les blijft hetzelfde: de garantie zit in de implementatie, niet in het drieletterige acroniem.
Het spiegelbeeld van ons CBOR-resultaat
We hebben hetzelfde experiment uitgevoerd op een andere codering, binair CBOR, en zagen het tegenovergestelde patroon. Daar was deterministisch CBOR niet deterministisch tussen libraries: 26% van de waarden leverde meer dan één canonieke codering op, en het meningsverschil was verspreid over het hele veld van libraries. JCS is het nette broertje. De regels zijn strakker en de libraries zijn het meestal eens, waardoor de divergentie beperkt blijft tot één uitschieter en een handjevol randgevallen in plaats van een kwart van alles. Dat contrast is de praktische les. De veiligheid van een canonicalisatieschema is niet alleen een eigenschap van het schema zelf; het is het product van de striktheid van het schema en de conformiteit van de specifieke libraries in je pad. JCS biedt een beter schema. Het ontslaat je er niet van om je libraries te controleren.
Test je eigen library in tien seconden
Je hebt onze testomgeving niet nodig om erachter te komen aan welke kant van deze split je staat. Canonicaliseer dit object met de JCS-library die je gebruikt:
{ "😀": 1, "\uE000": 2 }Als de output de emoji-key vooraan zet, sorteert je library op UTF-16 code unit en komt deze overeen met het RFC en de meerderheid. Als de private-use-key vooraan staat, sorteert je library op code point en zal deze afwijken van een conforme peer bij elk object waarvan de keys tekens uit het supplementary plane en het Basic Multilingual Plane combineren. Voer dezelfde controle uit aan beide zijden van elke trust boundary die JSON ondertekent, vooral wanneer de twee zijden verschillende programmeertalen gebruiken, en met name als keys door een aanvaller beïnvloede Unicode kunnen bevatten.
Hoe we het gemeten hebben, zodat een scepticus de cijfers kan vertrouwen
De dataset is volledig van onszelf en synthetisch. We hebben geen externe diensten benaderd, niets gescand en geen productiegegevens verzameld; elke invoer is een JSON-waarde die we zelf hebben geschreven om een specifieke edge case te testen. De libraries zijn openbare opensourcepakketten, getest op hun gepubliceerde versies, en bij naam genoemd omdat het benoemen van het gedrag van een specificatie-implementatie de essentie is van een conformiteitstest, geen beschuldiging aan het adres van wie dan ook.
- Isolatie. Elke implementatie draaide in een eigen container op basis van de officiële image, las hetzelfde corpus en schreef haar canonieke output met exact behoud van de bytes, zodat een afwijking aan de library ligt en niet aan onze pipeline.
- Ground truth. Alle zeven implementaties reproduceren de canonieke output van RFC 8785 Appendix B byte voor byte, waardoor we weten dat het daadwerkelijk JCS betreft en geen benaderende serializers.
- Twee onafhankelijke orakels. Een differentiële controle op byteniveau en een live HMAC sign-then-verify over alle 42 geordende library-paren. De handtekeningfouten maken de differentiële analyse concreet en vormen geen afzonderlijke claim.
- Eerlijke rubricering. We scheiden splits op byteniveau bij geldige invoer (de headline) van accept-versus-reject-gedrag en van discutabele out-of-spec invoerwaarden, zodat geen enkel getal meer gewicht krijgt dan het verdient.
Het testframework, de corpusgenerator en de runners per library worden bewaard zodat de methode reproduceerbaar is; hier rapporteren we uitsluitend het totaalbeeld.
Waarom dit belangrijk is, en de eerlijke beperkingen
Canonicalisatie wordt stilletjes opnieuw dragend voor de security. Het initiatief om autonome agents verifieerbare identiteiten te geven via ondertekende agent cards en verifiable credentials, laat de vertrouwensbeslissing verlopen via een JCS-then-sign-pipeline, vaak waarbij signer en verifier door verschillende teams in verschillende talen zijn geschreven. Dat is precies de situatie waarin een conformiteitskloof in één library verandert in een verificatiesplit. Het goede nieuws uit deze inventarisatie is dat JCS goed interopereert: kies twee conforme libraries en ze zijn niet van elkaar te onderscheiden. Het slechte nieuws is dat conformiteit niet gegarandeerd wordt door het label, en de enige plek waar een uitgebrachte library het nog steeds fout doet, de sleutelvolgorde voor supplementary-plane-tekens, is zowel bereikbaar voor aanvallers als makkelijk over het hoofd te zien.
Een resultaat zonder de beperkingen te noemen is marketing, dus hier zijn de kaders.
- Zeven libraries, niet het hele ecosysteem. Dit zijn gangbare, installeerbare implementaties, maar er zijn er meer, en een C- of C#-implementatie die we niet hebben getest kan aan weerszijden van de split vallen. De methode is algemeen toepasbaar; de exacte aantallen zijn specifiek voor deze set en deze versies.
- Lage waarschijnlijkheid in typische payloads. De key-sort-split slaat pas toe wanneer object keys supplementary-plane-tekens bevatten, wat zeldzaam is in reguliere agent cards of credentials met ASCII-veldnamen. Het risico is reëel maar voorwaardelijk, en een aanvaller die controle heeft over een key is degene die opzettelijk aan die voorwaarde voldoet.
- Versies veranderen. Libraries worden gepatcht. Een crate die vandaag op code point sorteert, kan morgen conform zijn, en dat is precies waarom het blijvende advies is om de specifieke versie die je deployt te testen in plaats van blind te varen op een naam.
- De getallensplit betreft edge cases. Integers boven 253 vallen buiten het bereik waarvoor JCS is gedefinieerd, dus beschouwen we die afwijking als een minder zware, secundaire bevinding en houden we deze buiten de kop.
Veelgestelde vragen
Wat is het JSON Canonicalization Scheme (JCS)?
JCS, gedefinieerd in RFC 8785, is een set regels die een JSON-waarde omzet in één deterministische bytereeks. Het sorteert object member names, serialiseert getallen met het ECMAScript number-to-string-algoritme, past minimale string-escaping toe en verwijdert niet-significante witruimte. Twee partijen die van dezelfde JSON-waarde uitgaan, produceren dezelfde bytes, zodat ze die bytes kunnen hashen of ondertekenen met een overeenkomend resultaat. JCS stelt je in staat om JSON te ondertekenen zonder van tevoren afspraken te maken over de exacte notatie.
Waarom faalt JCS-handtekeningverificatie tussen verschillende talen?
Het faalt wanneer de library van de signer en de library van de verifier van mening verschillen over de canonieke bytes voor dezelfde waarde. In onze test kwamen zes van de zeven implementaties byte voor byte overeen, maar één Rust-crate sorteerde object keys op Unicode code point in plaats van op UTF-16 code unit zoals RFC 8785 vereist. Bij een object waarvan de keys een emoji of een ander supplementary-plane-teken bevatten, leveren de twee libraries de keys in een andere volgorde op, waardoor de berekende tag over het object verschilt en de verificatie faalt.
Produceren JCS-implementaties dezelfde canonieke output?
Grotendeels wel. Bij 426 geldige, eenduidige invoerwaarden die zijn voorgelegd aan zeven implementaties in vijf talen, waren er zes byte-identiek op elke invoer en voldeden alle zeven aan RFC 8785 Appendix B. Eén implementatie week af bij 4,7% van de invoerwaarden, en elke afwijking had betrekking op een supplementary-plane object key of een integer groter dan 2 tot de 53e macht. JCS interopereert goed op reguliere data en splitst alleen bij specifieke edge cases.
Hoe voorkomt JCS het omzeilen van handtekeningen?
Het neemt de vrijheden weg die standaard JSON biedt, zoals sleutelvolgorde, witruimte en de vele manieren om een getal te noteren, zodat één waarde naar één bytereeks vertaalt en niet opnieuw gecodeerd kan worden naar een anders uitziend equivalent. Die garantie geldt alleen als beide partijen een conforme implementatie gebruiken. Een niet-conforme implementatie introduceert precies de ambiguïteit opnieuw die JCS moest wegnemen, en daarom is conformiteit van de implementatie, en niet louter het gebruik van JCS, de eigenschap die ertoe doet.
Hoe gebruikt A2A JCS om agent cards te ondertekenen?
In het Agent-to-Agent-protocol is een agent card een JSON-document dat de identiteit en mogelijkheden van een agent beschrijft. De handtekening is een JWS over de inhoud van de card nadat die inhoud met JCS is gecanonicaliseerd, en clients wordt geadviseerd om ten minste één handtekening te verifiëren voordat een card wordt vertrouwd. Omdat de ondertekende bytes de output van JCS zijn, berekent een client waarvan de JCS-library anders canonicaliseert dan die van de signer een andere invoer voor de verificatie.
Wat is een canonicalization confusion-aanval?
Het maakt misbruik van een verschil tussen hoe een signer en een verifier een bericht reduceren tot canonieke vorm. Als beide partijen verschillende bytes produceren voor dezelfde logische waarde, kan een aanvaller invoer construeren die verifieert als het ene terwijl het iets anders betekent, of een legitieme handtekening laten falen. Canonicalisatie is een terugkerende kwetsbaarheidsklasse in systemen die gestructureerde data ondertekenen, omdat de veiligheid ervan afhangt dat elke partij exact dezelfde canonieke vorm berekent.
Is RFC 8785 een officiële IETF-standaard?
RFC 8785 is een IETF Informational RFC gepubliceerd in juni 2020. Het is een stabiele, te refereren specificatie van het JSON Canonicalization Scheme, aangehaald in later werk rond ondertekende JSON, verifiable credentials en agent-to-agent-beveiliging. De status Informational betekent dat het geen verplichte Internet Standard is, maar wel de definitie waar implementaties naar verwijzen.
Gerelateerde artikelen
- Deterministisch CBOR is niet deterministisch tussen libraries. Dezelfde differentiële test op een andere codering, binair CBOR, waarbij 26% van de waarden meer dan één canonieke vorm kreeg.
- Beveiliging van remote MCP-servers: wat een inventarisatie van 19.321 servers aantoont. Het agent-tooling-aanvalsoppervlak dat deze ondertekende cards moeten beschermen, gemeten op populatieschaal.
- Wat de certificaten bewijzen. Cryptografische garanties direct uit de bytes afleiden in plaats van blind varen op het label, dezelfde methode toegepast op certificaten.