Deterministyczny CBOR nie jest deterministyczny pomiędzy bibliotekami
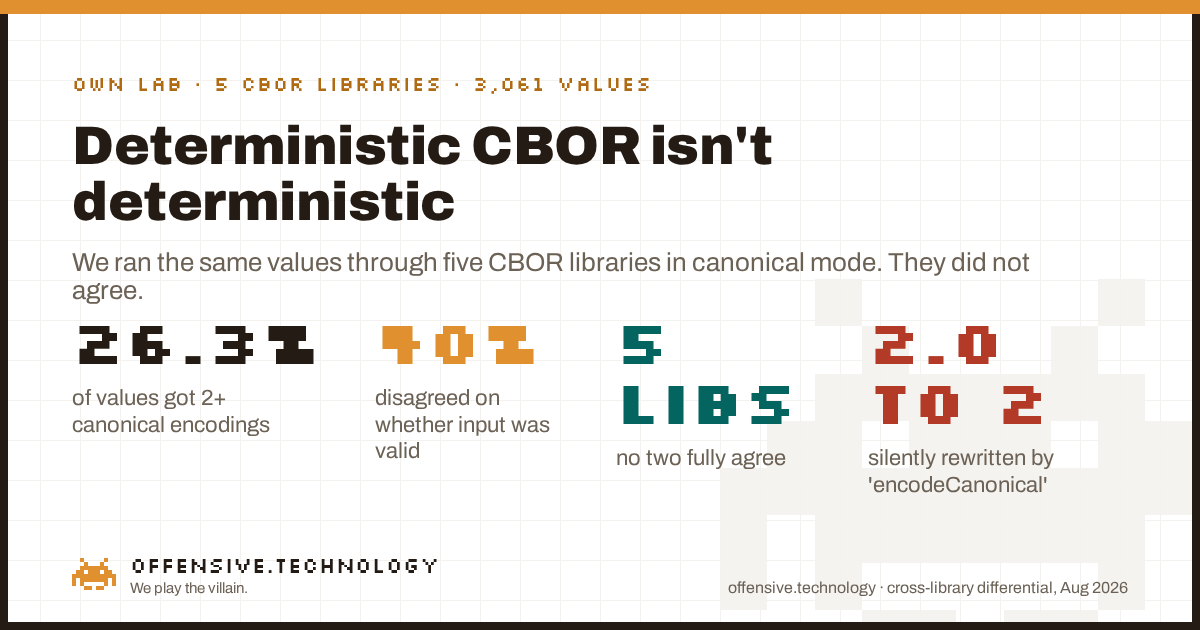
Deterministyczny CBOR ma gwarantować, że jedna wartość posiada dokładnie jedno kodowanie bajtowe. Przepuściliśmy te same 3,061 wartości przez pięć powszechnie używanych bibliotek CBOR w ich trybie deterministycznym lub kanonicznym, a 26.3% z nich dało więcej niż jedno odrębne kodowanie kanoniczne. W przypadku 40% wartości biblioteki nie potrafiły nawet uzgodnić, czy dane wejściowe miały już prawidłową formę kanoniczną. Ma to znaczenie, ponieważ podpisy COSE i CWT są obliczane na zakodowanych bajtach, więc gdy wartość zostanie podpisana jako kanoniczna w jednej bibliotece i ponownie zakodowana jako kanoniczna w innej, obie mogą różnić się w bajtach, a weryfikacja podpisu się nie powiedzie. Najbardziej jaskrawy przypadek: jedna biblioteka, w funkcji dosłownie nazwanej encodeCanonical, po cichu przepisuje wartość zmiennoprzecinkową 2.0 na liczbę całkowitą 2, zmieniając bajty, które weryfikator będzie haszować.
Co powinien robić deterministyczny CBOR
CBOR, czyli Concise Binary Object Representation zdefiniowany w RFC 8949, to kompaktowy binarny kuzyn JSON, który stanowi podstawę dla COSE, CWT, WebAuthn/FIDO2 oraz rosnącej liczby formatów IoT i łańcucha dostaw. Zwykły CBOR pozwala na zapisanie tej samej wartości na wiele sposobów: liczba całkowita może być dopełniona do większej liczby bajtów niż potrzebuje, klucze mapy mogą pojawiać się w dowolnej kolejności, a liczba zmiennoprzecinkowa może być przechowywana w precyzji half, single lub double. Ta elastyczność jest w porządku, dopóki nie trzeba haszować lub podpisać wartości, ponieważ podpis dotyczy bajtów, a jeśli bajty mogą się różnić, podpis traci znaczenie.
Kodowanie deterministyczne, opisane w RFC 8949 Section 4.2, jest rozwiązaniem: zestawem reguł sprowadzających każdą wartość do jednego i tylko jednego kodowania. Starsze materiały nazywają to kanonicznym CBOR, obecnym określeniem jest deterministyczny, i oba oznaczają to samo. Profil podstawowy wymaga czterech rzeczy: liczb całkowitych i długości w najkrótszej formie, wyłącznie określonych długości (definite lengths), liczb zmiennoprzecinkowych w najkrótszej formie oraz kluczy map posortowanych bajtowo według ich zakodowanej postaci. Spełnij wszystkie cztery i w teorii dowolne dwa kodery wygenerują identyczne bajty dla identycznych wartości. Cała wartość tego schematu tkwi w słowie identyczne. Postanowiliśmy to przetestować.
Co zmierzyliśmy i dlaczego sceptyk powinien temu zaufać
Zbudowaliśmy wyrocznię różnicową: jeden wspólny zestaw wartości testowych, przekazany do kilku niezależnych bibliotek CBOR w ich trybie deterministycznym lub kanonicznym, porównując wyniki wygenerowane przez każdą z nich. To ta sama metoda, której użyliśmy do zestawienia zachowania TLS pomiędzy bibliotekami w trybie FIPS. Nie wymaga to udziału stron trzecich i nie dotyka niczyjej infrastruktury. To nasz własny kod, w naszym własnym środowisku testowym, kodujący wymyślone przez nas liczby. Biblioteki pojawiają się jedynie w neutralnej tabeli kompatybilności, tak jak w zestawieniach zgodności przeglądarek.
Pięć implementacji, dobranych tak, aby objąć różne języki i uwzględnić rygorystyczny punkt odniesienia w postaci dCBOR:
| Biblioteka | Wersja | Użyty tryb |
|---|---|---|
| cbor2 (Python) | 6.1.4 | dumps(canonical=True) |
| cbor (Node.js) | 10.0.12 | encodeCanonical |
| fxamacker/cbor (Go) | v2.9.3 | Core Deterministic, duplicate-key enforced |
| ciborium (Rust) | 0.2.2 | domyślny koder (brak dedykowanego trybu kanonicznego) |
| bc-dcbor (Rust) | 0.15.2 | ścisły profil dCBOR |
Korpus obejmował 3,061 wartości: 61 ręcznie spreparowanych wektorów brzegowych pokrywających dziesięć znanych punktów decyzyjnych oraz 3,000 losowo wygenerowanych, poprawnie typowanych wartości ze stałego ziarna (seed), dzięki czemu przebieg jest w pełni powtarzalny. Dla każdej wartości i każdej biblioteki zarejestrowaliśmy dwie rzeczy: kanoniczne ponowne zakodowanie w formacie szesnastkowym oraz werdykt, czy biblioteka zaakceptowała dane wejściowe jako już poprawny format kanoniczny, zdekodowała je jako niekanoniczne, czy odrzuciła całkowicie. Następnie porównaliśmy wyniki. Metoda jest celowo prosta, co stanowi jej siłę: nie ocenia, kto ma rację, jedynie zlicza miejsca, w których niezależne implementacje, z których każda twierdzi, że jest kanoniczna, różnią się między sobą.
Wynik: 26% wartości, więcej niż jedno kodowanie kanoniczne
Spośród 3,061 wartości, 806 (26.3%) wygenerowało więcej niż jedno odrębne kodowanie kanoniczne w pięciu bibliotekach, a 1,223 (40.0%) wygenerowało więcej niż jeden werdykt akceptacji lub odrzucenia. Sam losowy korpus, zwykłe wartości, które rzeczywista aplikacja mogłaby serializować, różnił się w kodowaniu w 26.2% przypadków. Nie jest to zjawisko dotyczące wyłącznie przypadków brzegowych. Jedna czwarta codziennych wartości koduje się inaczej w zależności od tego, któremu modułowi kanonizującemu je przekażesz.
Ręcznie spreparowane wektory pokazują, gdzie koncentrują się rozbieżności. Każdy wiersz poniżej to znany punkt decyzyjny kodowania deterministycznego, a wartości procentowe pokazują, jak często pięć bibliotek różniło się w kodowaniu oraz w ocenie poprawności.
| Punkt decyzyjny | Rozbieżność kodowania | Rozbieżność werdyktów |
|---|---|---|
| Zduplikowane klucze mapy | 100% | 100% |
| Redukcja liczbowa (2.0 do 2) | 83% | 83% |
| Kolejność kluczy mapy | 67% | 67% |
| Najkrótsza reprezentacja float | 50% | 70% |
| Ujemne zero | 33% | 100% |
| Niekanoniczne NaN | 25% | 63% |
| Minimalność liczb całkowitych | 0% | 60% |
| Długości nieokreślone (indefinite lengths) | 0% | 80% |
| Nadmiarowe bajty końcowe | 0% | 75% |
Przeczytaj uważnie ostatnie trzy wiersze, ponieważ są one najbardziej subtelne. W przypadku minimalności liczb całkowitych, nieokreślonych długości i nadmiarowych bajtów końcowych, biblioteki, które generują kodowanie, tworzą to samo kodowanie, więc kolumna rozbieżności kodowania wynosi 0%. Różnią się jednak diametralnie w kwestii tego, czy dane wejściowe były w ogóle dopuszczalne: od 60% do 80% rozbieżności werdyktów. Jedna biblioteka bez problemu ponownie koduje nieminimalną liczbę całkowitą, inna oznacza to jako ostrzeżenie, a trzecia całkowicie odrzuca. W potoku składania podpisów rozbieżność w akceptacji lub odrzuceniu jest tak samo niebezpieczna jak rozbieżność w bajtach, ponieważ decyduje o tym, czy komunikat zostanie w ogóle przetworzony.
Konsekwencje: podpis, który weryfikuje się na jednym stosie, a zawodzi na innym
Oto dlaczego przestaje to być kwestią czysto akademicką. COSE (RFC 9052) oraz CWT (RFC 8392) nie podpisują wartości abstrakcyjnej. COSE tworzy Sig_structure, tablicę CBOR zawierającą kontekst, chronione nagłówki, dane zewnętrzne i ładunek, koduje tę tablicę jako CBOR, a podpis jest obliczany na podstawie tych bajtów. Weryfikator odtwarza tę samą strukturę, koduje ją i sprawdza podpis względem jej bajtów. Cały schemat zakłada, że obie strony generują te same bajty dla tej samej wartości. Kodowanie deterministyczne jest właśnie tym założeniem.
Zobaczmy teraz, jak to założenie upada. Najbardziej wyrazistym przypadkiem w naszych danych jest wartość zmiennoprzecinkowa 2.0, CBOR f94000:
| Biblioteka | Wynik kanoniczny | Co zrobiła biblioteka |
|---|---|---|
| cbor (Node.js) | 02 | zredukowała liczbę zmiennoprzecinkową do liczby całkowitej 2 |
| cbor2 (Python) | f94000 | zachowała postać zmiennoprzecinkową |
| fxamacker/cbor (Go) | f94000 | zachowała postać zmiennoprzecinkową |
| ciborium (Rust) | f94000 | zachowała postać zmiennoprzecinkową |
| bc-dcbor (Rust) | reject | odrzuciła postać zmiennoprzecinkową |
Trzy różne wyniki dla jednej prostej liczby, uzyskane przy użyciu funkcji deklarowanych jako kanoniczne lub deterministyczne. Usługa, która podpisuje token zawierający liczbę 2.0, używając biblioteki dla Node, której tryb kanoniczny stosuje redukcję liczbową w stylu dCBOR i generuje 02, oraz weryfikator, który ponownie koduje wartość za pomocą biblioteki w Pythonie lub Go i uzyskuje f94000, zahaszują różne ciągi bajtów. Podpis nie zostanie zweryfikowany, a błąd będzie wyglądał jak tajemniczy, sporadyczny problem z interoperacyjnością, a nie to, czym jest w rzeczywistości: dwie biblioteki, z których każda uważa się za kanoniczną, stosują inną kanonizację.
Przypadek zduplikowanych kluczy jest jeszcze gorszy pod innym względem. Mając mapę {1:1, 1:2} (wejście a201010102), Go oraz punkt odniesienia dCBOR ją odrzucają, Python i Node po cichu zwijają ją do jednoelementowej mapy {1:2}, a domyślny koder w Rust przepuszcza duplikat bez zmian. Pięć bibliotek, trzy istotne dla bezpieczeństwa zachowania: odrzucenie, ciche porzucenie danych lub zachowanie niejednoznacznej struktury. Każda taka rozbieżność między podpisującym a weryfikatorem to miejsce, w którym atakujący może zdecydować, która strona zobaczy jaką wartość.
Dwa kanony i wskaźnik odrzuceń, który mówi sam za siebie
Powodem, dla którego jest to problem strukturalny, a nie zestaw odosobnionych błędów, jest istnienie więcej niż jednego kanonu. Zwykłe kodowanie deterministyczne RFC 8949 to jeden cel. Bardziej rygorystyczny profil dCBOR, draft-mcnally-deterministic-cbor, to kolejny, i celowo idzie dalej: wymusza redukcję liczbową, więc 2.0 staje się 2, kanonizuje każde NaN do pojedynczej postaci i bezwzględnie odrzuca zduplikowane klucze. W opracowaniu są kolejne propozycje, w tym prace IETF nad draft-ietf-cbor-cde Common Deterministic Encoding, które powstają właśnie dlatego, że ekosystem nie osiągnął spójności. Adam Langley z Google skatalogował co najmniej trzy sprzeczne porządki sortowania kluczy map już w 2022 roku, a rozbieżności nadal trafiają do środowisk produkcyjnych: rzeczywiste zgłoszenia dotyczące problemów z interoperacyjnością dotyczą biblioteki CBOR w .NET w kwestii kolejności sortowania między RFC 7049 a RFC 8949.
Nasze własne dane pokazują podział na dwa kanony w jednej wymownej liczbie. Rygorystyczna biblioteka dCBOR odrzuciła 1,221 z 3,061 wartości (40%) jako nieprawidłowy dCBOR, mimo że pozostałe biblioteki bez problemu je zaakceptowały i kanonicznie zakodowały zgodnie ze zwykłymi regułami RFC 8949. W przypadku 1,840 wartości, które dCBOR zaakceptował, zgadzał się z pozostałymi w ponad 99.9% przypadków. Innymi słowy, dCBOR i podstawowy deterministyczny CBOR nie są parą ściślejszą, ale kompatybilną. To dwa różne języki, które pokrywają się tylko w pewnym podzbiorze. Wybierz jeden po stronie podpisującego, a drugi po stronie weryfikatora, a 40% Twoich wartości wpadnie w tę lukę.
Liczby dotyczące zgodności parami potwierdzają to z drugiej strony:
- cbor2 (Python) i fxamacker/cbor (Go) były zgodne w przypadku 99.93% wartości. Dwie niezależne implementacje, w różnych językach, które rzeczywiście osiągają spójność w podstawowym kodowaniu deterministycznym RFC 8949. Jest to osiągalne.
- cbor (Node.js) i ciborium (Rust) były zgodne tylko w 73.7%. Najmniej zbliżona para, różniąca się w ponad jednej czwartej wartości, ponieważ jedna stosuje redukcję liczbową, a druga w ogóle nie przeprowadza kanonizacji.
- Domyślny koder w Rust nigdy nie sortował map ani nie skracał liczb zmiennoprzecinkowych. To nie błąd. ciborium po prostu nie posiada dedykowanego trybu kanonicznego, co stanowi dokładną pułapkę. Programista sięgający po bibliotekę CBOR, który nie znajdzie przełącznika trybu kanonicznego, bez przeszkód podpisze niekanoniczne bajty, nawet o tym nie wiedząc.
Jak to zmierzyliśmy i jakie są obiektywne ograniczenia
Zestaw danych jest nasz, zbudowany z wymyślonych przez nas wartości i przedstawiony zbiorczo. Nie sondowaliśmy żadnego zewnętrznego systemu ani nie wskazaliśmy żadnej biblioteki jako podatnej. Różnica w kompatybilności to nie podatność, to różnica w kompatybilności. Celem podania wersji jest powtarzalność wyników, a nie obwinianie autorów.
- Korpus. 61 ręcznie spreparowanych wektorów ukierunkowanych na dziesięć punktów decyzyjnych (minimalność liczb całkowitych, kolejność map, zduplikowane klucze, najkrótsza reprezentacja float, redukcja liczbowa, NaN, ujemne zero, nieokreślona długość, nadmiarowe bajty końcowe, duże liczby całkowite) oraz 3,000 pseudolosowych wartości ze stałego ziarna, dzięki czemu cały przebieg jest deterministyczny i powtarzalny.
- Werdykt. Dla każdej wartości i biblioteki zarejestrowaliśmy kanoniczne ponowne zakodowanie w formacie szesnastkowym oraz to, czy biblioteka potraktowała dane wejściowe jako poprawnie kanoniczne, niekanoniczne, czy je odrzuciła. Rozbieżność liczona jest dla bibliotek, które zwróciły kodowanie, więc biblioteka odrzucająca wartość nie jest błędnie zliczana jako generująca inne kodowanie.
- Tryby, a nie wartości domyślne, tam gdzie tryb kanoniczny istnieje. Każda biblioteka została uruchomiona w udokumentowanym trybie deterministycznym lub kanonicznym, z wyjątkiem ciborium, która go nie posiada. Dołączyliśmy jej domyślny koder właśnie po to, aby pokazać, co otrzymuje programista, gdy żaden tryb kanoniczny nie jest oferowany.
- Ograniczenia. Pięć bibliotek nie stanowi całego ekosystemu, a każda biblioteka udostępnia różne parametry rygorystyczności. Inne ustawienie mogłoby zmienić wynik. Są to również zachowania samych bibliotek, a nie dowód, że jakiekolwiek wdrożone rozwiązanie produkcyjne podpisuje dane przy takich rozbieżnościach. Wnioskiem jest to, że niezgodność jest realna, powszechna i dotyczy dokładnie tych punktów decyzyjnych, które unieważniają podpisy. To ostrzeżenie przed błędnym założeniem, a nie zarzut pod adresem konkretnego produktu.
- To nie to samo co błąd bezpieczeństwa parsera. Dekodery CBOR mają własną historię poprawek bezpieczeństwa, na przykład łatki dotyczące pamięci i odmowy usługi w biuletynach bezpieczeństwa cbor2. Są to kwestie odporności dekodera, zupełnie inna kategoria. Niejednoznaczność kanonizacji to nie awaria programu (crash). To dwie poprawne implementacje, które po cichu różnią się co do interpretacji stanu faktycznego.
Co zrobić, jeśli podpisujesz CBOR
Wnioski w zakresie obrony są mało spektakularne, co tylko potwierdza ich słuszność.
- Podpisuj i weryfikuj przy użyciu tej samej biblioteki i wersji po obu stronach wszędzie tam, gdzie to możliwe. Podpisywanie między różnymi stosami technologicznymi to dokładnie to miejsce, w którym uderza wspomniane 26%.
- Określ profil w sposób jednoznaczny. Zdecyduj, czy wymagasz podstawowego deterministycznego RFC 8949, czy ścisłego dCBOR, udokumentuj to i wymuś stosowanie wybranego wariantu przez każdego uczestnika komunikacji. Nie są one wymienne.
- Nigdy nie polegaj na wartościach domyślnych. Jeśli biblioteka nie posiada trybu kanonicznego, jej domyślny wynik prawie na pewno nie jest kanoniczny, a Ty nie otrzymasz żadnego ostrzeżenia.
- Testuj względem stałych wektorów testowych, w tym tych problematycznych: zduplikowanych kluczy,
2.0, ujemnego zera, NaN oraz map, których klucze mają różne długości po zakodowaniu. Jeśli komponent podpisujący i weryfikator wygenerują różne bajty dla któregokolwiek z nich, znalazłeś błąd interoperacyjności, zanim zrobi to atakujący.
Deterministyczny CBOR to dobry pomysł, który w większości przypadków działa, a dwie z pięciu naszych bibliotek udowodniły, że da się osiągnąć pełną zgodność co do bajta. Jednak «w większości przypadków» to nie gwarancja, jaką niesie słowo deterministyczny, a podpisy cyfrowe nie tolerują przybliżeń. Rozbieżność dotyczy jednej czwartej zwykłych wartości i leży u podstaw formatów, od których zależy bezpieczeństwo wielu systemów.
Często zadawane pytania
Czym jest deterministyczny CBOR i czym różni się od kanonicznego CBOR?
Deterministyczny CBOR to zestaw dodatkowych reguł nałożonych na zwykły CBOR (RFC 8949), które wymuszają, aby jedna wartość miała dokładnie jedno kodowanie bajtowe. Jest to to, co starsze dokumenty nazywają kanonicznym CBOR. Obecny standard używa słowa deterministyczny i oba te pojęcia oznaczają to samo. RFC 8949 Section 4.2 podaje podstawowe zasady: liczby całkowite i długości w najkrótszej formie, wyłącznie określone długości (definite lengths), liczby zmiennoprzecinkowe w najkrótszej formie oraz posortowane klucze map. Celem jest, aby dwa niezależne kodery wygenerowały te same bajty dla tej samej wartości, od czego zależy podpisywanie i haszowanie.
Czego wymaga RFC 8949 Section 4.2 w zakresie kodowania deterministycznego?
Czterech rzeczy. Preferowanej serializacji, czyli każda liczba całkowita, długość i argument znacznika (tag) używa najmniejszej możliwej liczby bajtów. Wyłącznie określonych długości, czyli brak ciągów, tablic lub map o nieokreślonej długości (indefinite-length). Kolejności kluczy map według leksykograficznego porównania zakodowanych kluczy bajt po bajcie, tzw. one-step ordering. Oraz najkrótszej reprezentacji liczb zmiennoprzecinkowych, aby wartość używała najmniejszego formatu spośród half, single lub double, który dokładnie ją reprezentuje. Section 4.2.3 dokumentuje także starszy porządek kluczy typu length-first, zachowany dla kompatybilności z RFC 7049, co stanowi jedno z bezpośrednich źródeł rozbieżności między bibliotekami.
Jak porządkowane są klucze mapy CBOR w kodowaniu deterministycznym?
Zgodnie z RFC 8949 klucze są sortowane przez leksykograficzne porównanie ich w pełni zakodowanych ciągów bajtów, bajt po bajcie. RFC 7049, poprzednia wersja, w pierwszej kolejności umieszczała krótszy zakodowany klucz przed dłuższym. Obie te reguły są sprzeczne zawsze, gdy klucze mają różne długości po zakodowaniu, na przykład jednobajtowy klucz całkowity obok dwubajtowego, przez co biblioteki zbudowane w oparciu o różne wersje specyfikacji sortują tę samą mapę inaczej, nazywając swój wynik kanonicznym.
Czym jest dCBOR i czym różni się od deterministycznego CBOR w RFC 8949?
dCBOR to bardziej rygorystyczny profil zdefiniowany w szkicu draft-mcnally-deterministic-cbor. W stosunku do RFC 8949 dodaje redukcję liczbową, co oznacza, że liczba zmiennoprzecinkowa bez części ułamkowej musi być zakodowana jako liczba całkowita, jeśli się w niej mieści, a 2.0 musi stać się 2. Ponadto kanonizuje każde NaN do jednej postaci half-width i odrzuca mapy ze zduplikowanymi kluczami jako błąd dekodowania. Ponieważ redukuje 2.0 do 2, mapa poprawna w zwykłym deterministycznym CBOR może stać się niepoprawną mapą dCBOR, gdy dwa klucze zredukują się do tej samej wartości.
Dlaczego kodowanie deterministyczne ma znaczenie dla podpisów COSE i CWT?
COSE (RFC 9052) i CWT (RFC 8392) obliczają podpis na podstawie zakodowanych bajtów CBOR, a nie wartości abstrakcyjnej. COSE buduje strukturę Sig_structure, koduje ją jako CBOR i podpisuje te bajty. Jeśli strona podpisująca kanonizuje wartość w jeden sposób, a weryfikator ponownie zakoduje ją w inny, weryfikator zahaszuje inne bajty i podpis nie zostanie zweryfikowany, albo spreparowana wartość brzegowa zostanie zaakceptowana przez jedną stronę, oznaczając coś innego dla drugiej. Kodowanie deterministyczne to założenie, które zapewnia bezpieczeństwo podpisywania ustrukturyzowanych wartości.
Czy różne biblioteki CBOR generują te same bajty kanoniczne?
Nie zawsze. W naszym teście pięciu powszechnie używanych bibliotek w trybie kanonicznym 26.3% z 3,061 wartości wygenerowało więcej niż jedno odrębne kodowanie kanoniczne, a 40% wygenerowało więcej niż jeden werdykt poprawności. Rozbieżności skupiają się wokół zduplikowanych kluczy, redukcji liczb zmiennoprzecinkowych, kolejności map oraz najkrótszej reprezentacji float. Dwie biblioteki były zgodne w ponad 99.9% wartości, podczas gdy najmniej zgodna para osiągnęła poniżej 74%, więc zgodność w ogromnym stopniu zależy od dobranych implementacji.
Czy 2.0 jest kodowane w CBOR tak samo jak 2?
To zależy od biblioteki i profilu. W zwykłym deterministycznym CBOR według RFC 8949 liczba zmiennoprzecinkowa 2.0 pozostaje floatem i jest kodowana inaczej niż liczba całkowita 2. W dCBOR redukcja liczbowa wymaga zakodowania 2.0 jako liczby całkowitej 2. W naszym teście jedna biblioteka przepisała 2.0 na 2 w trybie o nazwie encodeCanonical, trzy zachowały postać zmiennoprzecinkową, a wzorcowa biblioteka dCBOR całkowicie odrzuciła postać float, więc ta sama wartość kanonizowana na dwóch różnych stosach może wygenerować różne podpisane bajty.
Jak deterministycznie kodować CBOR?
Włącz jawny tryb deterministyczny lub kanoniczny biblioteki, zamiast ufać ustawieniom domyślnym, które nie sortują map ani nie skracają liczb zmiennoprzecinkowych. Zdefiniuj dokładny profil, zwykły RFC 8949 lub ścisły dCBOR, i upewnij się, że podpisujący i weryfikator używają tego samego. Testuj przypadki brzegowe, zwłaszcza zduplikowane klucze, liczby zmiennoprzecinkowe bez części ułamkowej, ujemne zero, NaN oraz klucze map o zróżnicowanej długości. Jeśli podpisujesz CBOR, najbezpieczniejszym podejściem jest użycie identycznej biblioteki i wersji po obu stronach lub weryfikowanie bajtów względem stałych wektorów testowych.
Warto przeczytać
- Czy FIPS wyłącza postkwantowy TLS? Ta sama metoda różnicowa, jeden zestaw danych wejściowych w wielu bibliotekach, zastosowana do uzgadniania połączenia TLS zamiast formatu serializacji.
- Certificate transparency post-quantum: 43% of static-CT logs already sign with ML-DSA-44. Kolejne miejsce, w którym podpisy są obliczane na podstawie precyzyjnego kodowania bajtowego i gdzie analiza samych bajtów ujawnia rzeczywisty stan rzeczy.
- Co udowadniają certyfikaty. Odczytywanie gwarancji kryptograficznych bezpośrednio z transmisji sieciowej zamiast polegania na deklaracjach, dokładnie ten sam zamysł, co przy analizie bajtów w tym badaniu.
Czy kryptografia, na której polegasz, rzeczywiście działa?
Nasz audyt za $100 sprawdza rzeczywistą zewnętrzną konfigurację kryptografii i protokołów tak, jak mapuje ją atakujący, w zweryfikowanym i pisemnie autoryzowanym przez Ciebie zakresie, z omówieniem wyników przez doświadczonego inżyniera bezpieczeństwa. Założenia, na których po cichu polegają Twoje podpisy i tokeny, są częścią tej powierzchni ataku.
Zamów audyt za $100