Weryfikacja podpisu JCS: sześć z siedmiu bibliotek RFC 8785 jest zgodnych co do formy kanonicznej, jedna nie
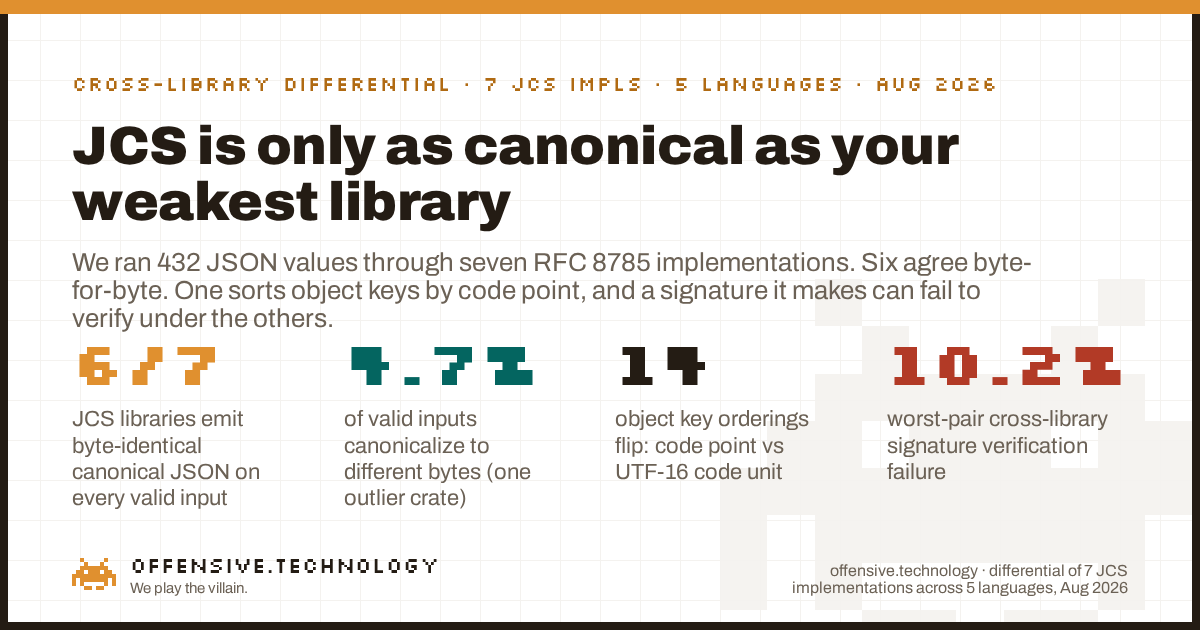
Sześć z siedmiu przetestowanych przez nas bibliotek kanonikalizacji JSON według RFC 8785 generuje bajtowo identyczne dane wyjściowe dla każdego prawidłowego wejścia. Siódma tego nie robi, a ta pojedyncza rozbieżność powoduje błąd weryfikacji podpisu. Przepuściliśmy 432 prawidłowe wartości JSON przez siedem niezależnych implementacji JCS w pięciu językach. Wszystkie siedem jest zgodnych z przykładem z RFC 8785 Appendix B, więc wszystkie siedem to rzeczywiście JCS. Jednak jedna z nich, crate w języku Rust serde_jcs, sortuje klucze obiektów według punktu kodowego Unicode zamiast według jednostki kodowej UTF-16, jak wymaga tego specyfikacja. Na 4.7% naszych prawidłowych wejść generuje inne bajty niż pozostałe sześć. Jeśli znajduje się po jednej stronie podpisu, a dowolna z pozostałych bibliotek po drugiej, obiekt JSON podpisany przez jedną z nich może nie przejść weryfikacji w drugiej. Kiedy zasymulowaliśmy to bezpośrednio z HMAC, najgorsza para bibliotek nie zweryfikowała 10.2% wiadomości, które powinna zaakceptować.
Dlaczego rozbieżność o jeden bajt to błąd bezpieczeństwa
Zwykły JSON daje zbyt dużą swobodę. Ten sam logiczny obiekt można zapisać z kluczami w dowolnej kolejności, z dowolną liczbą białych znaków i z liczbami zapisanymi na wiele równoważnych sposobów. Ta elastyczność jest w porządku, dopóki nie chcesz podpisać obiektu, ponieważ podpis jest obliczany na bajtach, a nie na znaczeniu. Jeśli strona podpisująca i weryfikująca serializują obiekt inaczej, weryfikator haszuje inne bajty i podpis się nie zgadza. Co gorsza, jeśli atakujący znajdzie dwa ciągi bajtów, które jedna strona traktuje jako równe, a druga jako różne, dochodzi do ataku na kanonikalizację: spreparowanej wiadomości, która weryfikuje się jako jedno, a oznacza co innego. Badanie z 2026 roku klasyfikuje błędy kanonikalizacji jako powracającą klasę podatności dokładnie w tego typu systemach.
RFC 8785, czyli JSON Canonicalization Scheme, rozwiązuje ten problem. Eliminuje każdy stopień swobody: nazwy pól obiektów są sortowane, liczby są serializowane za pomocą algorytmu ECMAScript Number.prototype.toString, ciągi znaków otrzymują minimalne dozwolone sekwencje ucieczki, a nieistotne białe znaki są usuwane. Podaj tę samą wartość JSON do dowolnej zgodnej ze specyfikacją implementacji, a otrzymasz te same bajty, dzięki czemu obie strony podpisu zgadzają się co do tego, co zostało podpisane. Schemat ten pełni obecnie kluczową rolę. Protokół Agent-to-Agent podpisuje kartę agenta jako JWS na zawartości karty skanonikalizowanej za pomocą JCS, i zaleca klientom zweryfikowanie przynajmniej jednego podpisu przed zaufaniem karcie. Verifiable credentials i przepływy detached JWS robią to samo. Kanoniczne bajty stanowią granicę zaufania.
Ciekawe pytanie nie brzmi więc, czy specyfikacja jest poprawna. Chodzi o to, czy biblioteki wdrażane w rzeczywistych systemach są ze sobą zgodne. Zmierzyliśmy to.
Co przetestowaliśmy
Zestawiliśmy siedem niezależnych implementacji JCS w pięciu językach, wybranych dlatego, że to po nie programista najprawdopodobniej sięgnie w rejestrze pakietów:
canonicalize4.0.0 dla JavaScript (npm), szeroko stosowany moduł wywodzący się od erdtmana.- Implementacja referencyjna
cyberphone/json-canonicalizationw Pythonie, własny kod referencyjny autora. - Pakiet PyPI
jcs, wersja 0.2.1, osobna implementacja w Pythonie. gowebpki/jcsv1.0.1 dla Go.- Implementacja referencyjna
cyberphone/json-canonicalizationw Go. serde_jcs0.1.0 dla Rusta.java-json-canonicalization1.1 dla Javy (artefakt Mavena od erdtmana).
Każda działała we własnym kontenerze z oficjalnym obrazem, dzięki czemu wynik jest powtarzalny i żadna biblioteka nie mogła wpłynąć na inną. Zbudowaliśmy korpus 440 spreparowanych wejść, z czego 432 stanowiły poprawny JSON, oznaczonych według kategorii: formatowanie liczb w pobliżu granic IEEE-754 i ECMAScript, ujemne zero, przypadki sortowania kluczy ze znakami układającymi się inaczej w UTF-16 niż według punktu kodowego, sekwencje ucieczki i normalizacja Unicode, zduplikowane klucze, samotne surogaty oraz strukturalne przypadki brzegowe. Podaliśmy identyczne bajty do każdej biblioteki i przechwyciliśmy jej kanoniczne wyjście, zachowując bajty dokładnie w taki sposób, aby żadna rozbieżność nie była artefaktem naszych własnych narzędzi.
Na wynikach działały dwie wyrocznie. Pierwsza to proste porównanie różnicowe: czy dla każdego wejścia biblioteki, które zakończyły działanie sukcesem, generują te same bajty? Druga to sam atak: weź stały klucz HMAC-SHA256, niech biblioteka podpisująca skanonikalizuje wejście i wygeneruje znacznik, a następnie niech biblioteka weryfikująca skanonikalizuje to samo wejście i sprawdzi znacznik. Każda uporządkowana para bibliotek, każde wejście. Niepowodzenie w tym teście oznacza podpis między bibliotekami, który powinien zostać zweryfikowany, a nie został.
Zanim uznaliśmy jakiekolwiek wyniki, sprawdziliśmy stan faktyczny. Wszystkie siedem implementacji odtwarza bajt w bajt kanoniczne wyjście z RFC 8785 Appendix B, łącznie z celowo kłopotliwymi liczbami i ciągiem znaków z sekwencjami ucieczki. Wszystkie są prawdziwym JCS. To właśnie sprawia, że poniższa rozbieżność ma znaczenie: to nie jest zepsuta biblioteka zestawiona z poprawną, lecz siedem pozornie poprawnych bibliotek, z których jedna po cichu myli się w przypadku brzegowym.
Wynik: 4.7% poprawnych wejść prowadzi do rozbieżności, i to zawsze w ten sam sposób
W przypadku 426 poprawnych, jednoznacznych wejść zaakceptowanych przez każdą bibliotekę, sześć z siedmiu dało bajtowo identyczne wyniki we wszystkich przypadkach. Nie zbliżone: identyczne, dla każdej pojedynczej wartości. Siódma, serde_jcs, różniła się w 20 z tych 426 wejść, co stanowi 4.7%, i za każdym razem była w odosobnieniu. W naszym korpusie, gdy biblioteki JCS się nie zgadzają, jest to jedna biblioteka przeciwko całej reszcie.
| Kategoria | Wejścia | Rozbieżne | Przyczyna |
|---|---|---|---|
| Sortowanie kluczy | 80 | 14 | punkt kodowy a kolejność UTF-16 |
| Formatowanie liczb | 194 | 6 | liczby całkowite powyżej 253 |
| Ujemne zero | 18 | 0 | wszystkie zgodne (-0 do 0) |
| Sekwencje ucieczki Unicode | 76 | 0 | wszystkie zgodne |
| Normalizacja Unicode | 27 | 0 | wszystkie zgodne (brak cichej konwersji NFC/NFD) |
| Strukturalne | 30 | 0 | wszystkie zgodne |
Dwie kategorie odpowiadają za całą rozbieżność, a ta pierwsza jest kluczowa.
Rozbieżność w sortowaniu kluczy: punkt kodowy a jednostka kodowa UTF-16
RFC 8785 wprost określa, że nazwy pól obiektów są sortowane według ich kodowania UTF-16 poprzez porównywanie jednostek kodowych. Ten szczegół wynika z faktu, że JCS dziedziczy porządek ciągów znaków z ECMAScript, a ciągi w ECMAScript są sekwencjami jednostek kodowych UTF-16. W przypadku znaków z Basic Multilingual Plane kolejność jednostek kodowych i punktów kodowych jest taka sama, więc prawie nikt tego nie zauważa. Rozbieżność pojawia się tylko w przypadku znaków z płaszczyzn dodatkowych, czyli powyżej U+FFFF, które są kodowane jako para surogatów. Emoji takie jak U+1F600 ma punkt kodowy 0x1F600, który jest większy niż znak z Basic Multilingual Plane, taki jak U+E000. Jednak jego kodowanie UTF-16 zaczyna się od jednostki kodowej starszego surogatu 0xD83D, która jest mniejsza niż 0xE000. Zatem przy zastosowaniu tych dwóch reguł oba klucze sortują się w odwrotnej kolejności.
Czternaście naszych wejść testujących sortowanie kluczy trafiło dokładnie w ten punkt zapalny, a serde_jcs sortuje według punktów kodowych tam, gdzie pozostałe sześć sortuje według jednostek kodowych UTF-16. Oto najmniejszy przypadek, obiekt z dwoma kluczami:
input:      {"😀": 1, "\uE000": 2}

six libs:   {"😀":1,"\uE000":2}     😀 first  (0xD83D < 0xE000)
serde_jcs:  {"\uE000":2,"😀":1}     😀 last   (0x1F600 > 0xE000)
Znak do użytku prywatnego U+E000 pokazano tutaj jako sekwencję ucieczki dla czytelności. JCS w rzeczywistości emituje go jako dosłowny bajt i w tej kwestii obie biblioteki są zgodne. Nie zgadzają się natomiast co do kolejności tych dwóch pól, i to wystarczy. Podpisz obiekt po lewej stronie za pomocą HMAC lub JWS, przekaż go weryfikatorowi korzystającemu z serde_jcs, a weryfikator skanonikalizuje go do obiektu po prawej stronie, obliczy inny znacznik i odrzuci podpis, który był całkowicie poprawny. Odwróć role, a to samo stanie się w drugą stronę. Obie biblioteki mają trwałą, cichą rozbieżność co do tego, czym jest forma kanoniczna tego obiektu.
To nie jest żadne egzotyczne odkrycie na temat tego schematu. To klasyczna pułapka zgodności w JCS, wskazana w samym RFC oraz we wcześniejszych publikacjach na temat kanonikalizacji. Nasze badanie wnosi informację o skali zjawiska: spośród siedmiu dystrybuowanych, gotowych do instalacji bibliotek, które przechodzą wektor testowy samego RFC, jedna nadal robi to źle. Zgodność z głównym przykładem nie oznacza zgodności w przypadkach brzegowych.
Rozbieżność w liczbach i dlaczego opisujemy ją osobno
Pozostałe sześć rozbieżnych wejść to liczby całkowite większe niż 253, takie jak 9007199254740993. JCS precyzuje, że liczby są serializowane przy użyciu algorytmu number-to-string z ECMAScript, który opiera się na typie double z IEEE-754. Powyżej 253 typ double nie może już reprezentować każdej liczby całkowitej, więc 9007199254740993 zaokrągla do 9007199254740992. Sześć bibliotek robi dokładnie to. serde_jcs zamiast tego zachowuje liczbę całkowitą w dokładnej postaci. Uczciwie zaznaczamy, że jest to słabsze spostrzeżenie niż rozbieżność przy sortowaniu kluczy: RFC 8785 jest zdefiniowane wyłącznie dla liczb w zakresie IEEE-754 double, więc liczba całkowita powyżej 253 jest prawdopodobnie wejściem wykraczającym poza specyfikację, którego wywołujący nigdy nie powinien przekazywać. Nadal jest to jednak składniowo poprawny JSON, nadal powoduje rozbieżność na poziomie bajtów między rzeczywistymi bibliotekami, a system akceptujący identyfikatory numeryczne większe niż bezpieczna liczba całkowita w JavaScript nadal może na to natrafić. Uwzględniamy to w zestawieniu różnicowym, ale nie w tytule.
Cała reszta zachowała zgodność. Ujemne zero kanonikalizowało się do 0 wszędzie. Żadna biblioteka nie zastosowała po cichu normalizacji Unicode, więc ciąg w NFC i ten sam ciąg w NFD pozostały odrębne we wszystkich siedmiu, co jest prawidłowe: JCS nie normalizuje. Sekwencje ucieczki w ciągach znaków były jednolite. Rozbieżności są wąskie i specyficzne, co czyni je niebezpiecznymi, a nie oczywistymi.
Przekształcenie rozbieżności w błąd podpisu
Rozbieżność w bajtach kanonicznych jest interesująca tylko wtedy, gdy coś psuje. Sprawiliśmy więc, że coś popsuła. Używając jednego stałego klucza HMAC-SHA256, użyliśmy każdej biblioteki jako strony podpisującej i każdej biblioteki jako weryfikującej dla każdego poprawnego wejścia, dla którego obie wygenerowały bajty: 42 uporządkowane pary, łącznie 11 754 testy weryfikacji. Test kończy się niepowodzeniem, gdy kanoniczne bajty podpisującego różnią się od kanonicznych bajtów weryfikatora, ponieważ wtedy różnią się znaczniki.
We wszystkich parach 1.87% weryfikacji zakończyło się niepowodzeniem. Liczba ta jest rozmyta przez sześć bibliotek, które nigdy nie różnią się między sobą, więc uczciwym sposobem jej interpretacji jest analiza w parach. Każda para, która nie obejmuje serde_jcs dała 100% poprawnych weryfikacji. Każda para, która łączy serde_jcs ze zgodną biblioteką, zawiodła na rozbieżnych wejściach. Najgorsza para, czyli implementacja referencyjna w Go od cyberphone jako strona podpisująca oraz serde_jcs jako weryfikator, zakończyła się niepowodzeniem w 15 z 147 testów, co daje 10.2% wskaźnika niepowodzeń weryfikacji podpisu między dwiema bibliotekami, z których obie przechodzą wektor testowy RFC. We wdrożeniu łączącym różne języki ponad granicą zaufania, a systemy agent-to-agent robią dokładnie to, byłby to błąd obserwowany w praktyce.
Druga oś: niektóre biblioteki odrzucają to, co inne akceptują
Oprócz rozbieżności na poziomie bajtów odkryliśmy dużą przestrzeń rozbieżności w akceptowaniu i odrzucaniu danych: 288 wejść, na których co najmniej jedna biblioteka zwróciła wynik, a inna zgłosiła błąd. Nie jest to niezgodność formy kanonicznej, ale stanowi odrębne zagrożenie dla interoperacyjności i dzieli biblioteki na obozy.
- Skalary na najwyższym poziomie. Dwa parsery z linii referencyjnej,
cyberphonew Go orazerdtmanw Javie, odrzucają samo0lub"x"jako wejście najwyższego poziomu. Pozostałe dokonują kanonikalizacji. Jeśli twój protokół kiedykolwiek podpisuje pojedynczy skalar JSON, połowa tych bibliotek w ogóle go nie przetworzy. - Zduplikowane klucze. Dla
{"a":1,"a":2}, wszystkie trzy parsery w Go i Javie całkowicie odrzucają obiekt, podczas gdy implementacje w JavaScript, Pythonie i Rust po cichu zachowują ostatnią wartość. Obsługa zduplikowanych kluczy jest na tyle niedookreślona, że podpisujący i weryfikator mogą nie zgadzać się co do tego, czy wiadomość jest w ogóle poprawna. - Samotne surogaty. Niesparowany surogat w ciągu znaków to niepoprawny JSON, a zachowanie bibliotek jest zróżnicowane: jedna emituje znak zastępczy U+FFFD, jedna przepuszcza surowe bajty niezgodne z UTF-8 bez zmian, a pozostałe odrzucają wejście. Którekolwiek z tych zachowań po jednej stronie i inne po drugiej to gotowy przepis na rozbieżność.
Nie wliczamy tego do głównej statystyki, ponieważ jest to kwestia akceptacji kontra odrzucenia, a nie różnic bajt w bajt, jednak wniosek jest ten sam: gwarancja tkwi w implementacji, a nie w trzyliterowym akronimie.
Lustrzane odbicie naszych wyników dla CBOR
Przeprowadziliśmy ten sam eksperyment na sąsiednim kodowaniu, binarnym CBOR, i uzyskaliśmy odwrotny obraz. Tam deterministyczny CBOR nie był deterministyczny pomiędzy bibliotekami: 26% wartości uzyskało więcej niż jedno kodowanie kanoniczne, a rozbieżności były rozproszone po wszystkich bibliotekach. JCS to ten bardziej uporządkowany krewniak. Jego reguły są bardziej rygorystyczne, a biblioteki w większości zgodne, więc rozbieżność sprowadza się do jednej odstającej biblioteki i garści skrajnych przypadków wejściowych zamiast jednej czwartej całości. Ten kontrast stanowi praktyczną lekcję. Bezpieczeństwo schematu kanonikalizacji nie wynika z samego schematu. Jest wypadkową rygorystyczności schematu i zgodności konkretnych bibliotek na twojej ścieżce. JCS zapewnia lepszy schemat, ale nie zwalnia z obowiązku sprawdzenia używanych bibliotek.
Przetestuj własną bibliotekę w dziesięć sekund
Nie potrzebujesz naszego środowiska testowego, aby sprawdzić, po której stronie rozbieżności się znajdujesz. Skanonikalizuj ten obiekt za pomocą dowolnej używanej biblioteki JCS:
{ "😀": 1, "\uE000": 2 }Jeśli wynik umieszcza klucz z emoji na początku, twoja biblioteka sortuje według jednostek kodowych UTF-16 i jest zgodna z RFC oraz większością implementacji. Jeśli na pierwszym miejscu znajduje się klucz do użytku prywatnego, twoja biblioteka sortuje według punktów kodowych i nie będzie zgodna ze standardowym odpowiednikiem dla żadnego obiektu, którego klucze łączą znaki z płaszczyzn dodatkowych i Basic Multilingual Plane. Wykonaj ten sam test po obu stronach każdej granicy zaufania podpisującej JSON, zwłaszcza gdy po obu stronach używane są różne języki, a w szczególności, jeśli którekolwiek z twoich kluczy mogą zawierać znaki Unicode kontrolowane przez atakującego.
Jak to zmierzyliśmy, aby sceptyk mógł zaufać liczbom
Zbiór danych jest całkowicie nasz i ma charakter syntetyczny. Nie odpytywaliśmy żadnych zewnętrznych usług, niczego nie skanowaliśmy ani nie zbieraliśmy danych ze świata rzeczywistego. Każde wejście to wartość JSON przygotowana przez nas do zbadania konkretnego przypadku brzegowego. Biblioteki to publiczne pakiety open source przetestowane w opublikowanych wersjach i wymienione z nazwy, ponieważ wskazywanie zachowania implementacji specyfikacji jest celem testu zgodności, a nie zarzutem wobec kogokolwiek.
- Izolacja. Każda implementacja działała we własnym kontenerze z oficjalnym obrazem, odczytując identyczny korpus i zapisując kanoniczne wyjście z dokładnym zachowaniem bajtów, więc rozbieżność leży po stronie biblioteki, a nie naszego potoku.
- Stan faktyczny. Wszystkie siedem implementacji odtwarza bajt w bajt kanoniczne wyjście z RFC 8785 Appendix B, dzięki czemu wiemy, że są prawdziwym JCS, a nie przybliżonymi serializatorami.
- Dwie niezależne wyrocznie. Porównanie różnicowe na poziomie bajtów oraz rzeczywisty test HMAC sign-then-verify na wszystkich 42 uporządkowanych parach bibliotek. Błędy podpisu to urzeczywistnienie różnic w bajtach, a nie osobne twierdzenie.
- Uczciwa kategoryzacja. Oddzielamy rozbieżności na poziomie bajtów dla poprawnych danych (główny wynik) od zachowań typu akceptacja kontra odrzucenie oraz wejść potencjalnie wykraczających poza specyfikację, aby żadna liczba nie była nadinterpretowana.
Środowisko testowe, generator korpusu oraz skrypty uruchomieniowe dla poszczególnych bibliotek zostały zachowane w celu zapewnienia powtarzalności metody. Raportujemy tutaj wyłącznie wyniki zagregowane.
Dlaczego to ma znaczenie i jakie są ograniczenia badania
Kanonikalizacja po cichu znów staje się elementem krytycznym. Dążenie do nadania autonomicznym agentom weryfikowalnych tożsamości za pomocą podpisanych kart agentów i verifiable credentials opiera decyzje o zaufaniu na potoku JCS-then-sign, często z podpisującym i weryfikatorem napisanymi w różnych językach przez różne zespoły. To dokładnie te warunki, w których brak zgodności w jednej bibliotece przekształca się w błąd weryfikacji. Dobra wiadomość z tego przeglądu jest taka, że JCS zapewnia dobrą interoperacyjność: wybierz dwie zgodne biblioteki, a będą nie do odróżnienia. Zła wiadomość jest taka, że zgodności nie gwarantuje sama etykieta, a jedyne miejsce, w którym dystrybuowana biblioteka nadal popełnia błąd, czyli kolejność kluczy dla znaków z płaszczyzn dodatkowych, jest zarówno osiągalne dla atakującego, jak i łatwe do przeoczenia.
Wynik bez określenia jego granic to marketing, oto więc ograniczenia.
- Siedem bibliotek, a nie cały ekosystem. Są to powszechne, gotowe do zainstalowania implementacje, ale istnieje ich więcej, a implementacja w C lub C#, której nie testowaliśmy, mogłaby znaleźć się po dowolnej stronie rozbieżności. Metoda jest uniwersalna, natomiast dokładne liczby są specyficzne dla tego zestawu w tych konkretnych wersjach.
- Niskie prawdopodobieństwo w typowych ładunkach. Rozbieżność w sortowaniu kluczy daje o sobie znać tylko wtedy, gdy klucze obiektów zawierają znaki z płaszczyzn dodatkowych, które rzadko występują w zwykłych kartach agentów lub poświadczeniach z nazwami pól w ASCII. Ryzyko jest realne, ale warunkowe, a atakujący kontrolujący klucz może celowo ten warunek spełnić.
- Wersje się zmieniają. Biblioteki są poprawiane. Crate, który dziś sortuje według punktów kodowych, jutro może być zgodny ze specyfikacją, dlatego uniwersalną radą jest testowanie konkretnej wdrażanej wersji, a nie poleganie na samej nazwie.
- Rozbieżność w liczbach dotyczy danych skrajnych. Liczby całkowite powyżej 253 wykraczają poza zakres zdefiniowany dla JCS, dlatego traktujemy tę rozbieżność jako słabszy, drugorzędny wniosek i nie umieszczamy jej w tytule.
Często zadawane pytania
Czym jest JSON Canonicalization Scheme (JCS)?
JCS, zdefiniowany w RFC 8785, to zestaw reguł przekształcających wartość JSON w jeden deterministyczny ciąg bajtów. Sortuje nazwy pól obiektów, serializuje liczby za pomocą algorytmu number-to-string z ECMAScript, stosuje minimalne sekwencje ucieczki w ciągach znaków i usuwa nieistotne białe znaki. Dwie strony wychodzące od tej samej wartości JSON generują dokładnie te same bajty, dzięki czemu mogą je haszować lub podpisywać z gwarancją zgodności. JCS pozwala podpisać dokument JSON bez wcześniejszego uzgadniania jego dokładnego zapisu znakowego.
Dlaczego weryfikacja podpisu JCS kończy się niepowodzeniem w różnych językach?
Kończy się niepowodzeniem, gdy biblioteka podpisującego i biblioteka weryfikatora różnią się co do kanonicznych bajtów dla tej samej wartości. W naszym teście sześć z siedmiu implementacji było zgodnych bajt w bajt, ale jeden crate w Rust sortował klucze obiektów według punktu kodowego Unicode zamiast według jednostki kodowej UTF-16, jak wymaga tego RFC 8785. W przypadku obiektu, którego klucze zawierają emoji lub inny znak z płaszczyzn dodatkowych, obie biblioteki emitują klucze w innej kolejności, więc znacznik obliczony dla obiektu różni się i weryfikacja kończy się błędem.
Czy implementacje JCS generują takie samo kanoniczne wyjście?
Przeważnie tak. Spośród 426 poprawnych, jednoznacznych wejść przekazanych do siedmiu implementacji w pięciu językach, sześć było bajtowo identycznych dla każdego wejścia, a wszystkie siedem było zgodnych z RFC 8785 Appendix B. Jedna różniła się na 4.7% wejść, przy czym każda rozbieżność dotyczyła klucza obiektu ze znakiem z płaszczyzn dodatkowych lub liczby całkowitej powyżej 2 do potęgi 53. JCS zapewnia dobrą interoperacyjność na typowych danych i wykazuje rozbieżności tylko w specyficznych przypadkach brzegowych.
W jaki sposób JCS zapobiega obejściu podpisu?
Eliminuje swobodę oferowaną przez zwykły JSON: kolejność kluczy, białe znaki oraz wiele sposobów zapisu liczby. Dzięki temu jedna wartość mapuje się na jeden ciąg bajtów i nie może zostać ponownie zakodowana w wyglądający inaczej, lecz równoważny format. Ta gwarancja obowiązuje tylko wtedy, gdy obie strony korzystają ze zgodnej implementacji. Niezgodna implementacja ponownie wprowadza niejednoznaczność, którą JCS miał wyeliminować, dlatego kluczową właściwością jest zgodność implementacji, a nie samo używanie JCS.
Jak A2A wykorzystuje JCS do podpisywania kart agentów?
W protokole Agent-to-Agent karta agenta to dokument JSON opisujący tożsamość i możliwości agenta. Jej podpis to JWS obliczony na zawartości karty po jej uprzedniej kanonikalizacji za pomocą JCS, a klientom zaleca się zweryfikowanie co najmniej jednego podpisu przed zaufaniem karcie. Ponieważ podpisywanymi bajtami jest wyjście z JCS, klient, którego biblioteka JCS dokonuje kanonikalizacji inaczej niż biblioteka podpisującego, oblicza inne dane wejściowe do weryfikacji.
Czym jest atak typu canonicalization confusion?
Wykorzystuje rozbieżność między tym, jak podpisujący i weryfikator sprowadzają wiadomość do formy kanonicznej. Jeśli obie strony generują różne bajty dla tej samej wartości logicznej, atakujący może spreparować wejście, które weryfikuje się jako jedno, a oznacza co innego, lub spowodować odrzucenie prawidłowego podpisu. Kanonikalizacja to powracająca klasa podatności w systemach podpisujących dane strukturyzowane, ponieważ bezpieczeństwo zależy od obliczenia przez każdą ze stron identycznej formy kanonicznej.
Czy RFC 8785 jest oficjalnym standardem IETF?
RFC 8785 to informacyjny dokument IETF (Informational RFC) opublikowany w czerwcu 2020 roku. Jest to stabilna, referencyjna specyfikacja JSON Canonicalization Scheme, cytowana w późniejszych pracach nad podpisanym JSON, verifiable credentials oraz bezpieczeństwem agent-to-agent. Status informacyjny oznacza, że nie jest to obligatoryjny Internet Standard, ale stanowi definicję, do której odwołują się implementacje.
Powiązane artykuły
- Deterministyczny CBOR nie jest deterministyczny pomiędzy bibliotekami. To samo porównanie różnicowe dla sąsiedniego kodowania, binarnego CBOR, gdzie 26% wartości uzyskało więcej niż jedną formę kanoniczną.
- Bezpieczeństwo zdalnych serwerów MCP: co pokazuje spis 19 321 serwerów. Powierzchnia narzędziowa agentów, którą te podpisane karty mają chronić, zmierzona w skali całej populacji.
- Co poświadczają certyfikaty. Odczytywanie zapewnień kryptograficznych bezpośrednio z bajtów zamiast polegania na etykietach, ta sama metoda zastosowana wobec certyfikatów.