CBOR determinístico não é determinístico entre bibliotecas
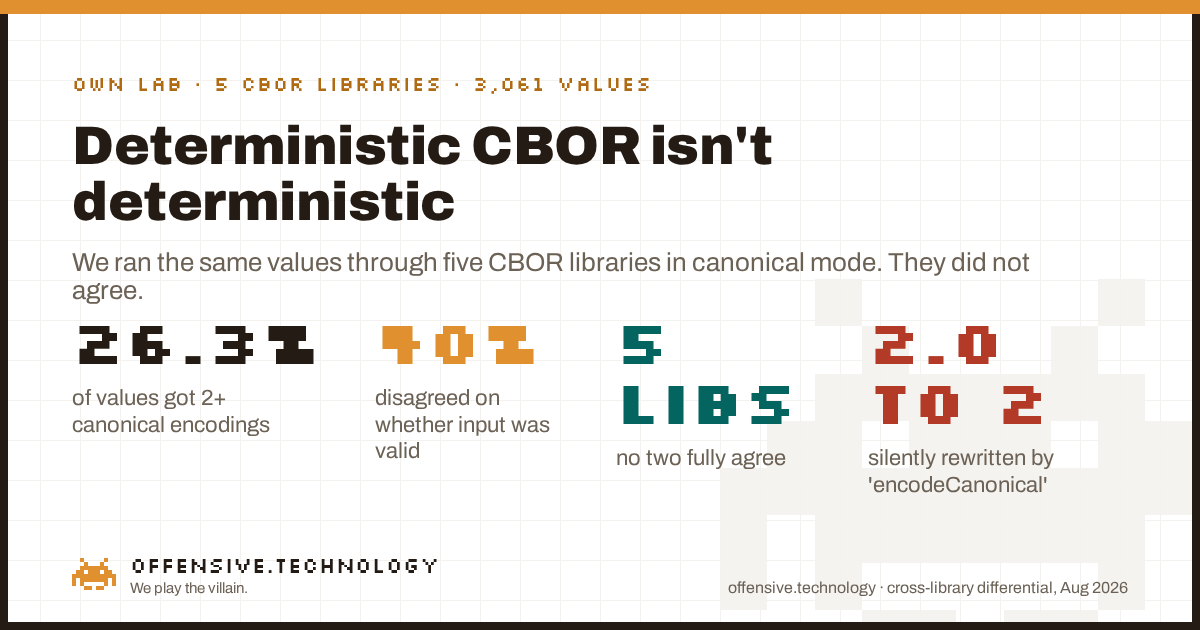
O CBOR determinístico deveria garantir que um valor tenha exatamente uma codificação em bytes. Executamos os mesmos 3,061 valores em cinco bibliotecas populares de CBOR em seus modos determinísticos ou canônicos, e 26.3% resultaram em mais de uma codificação canônica distinta. Em 40% dos valores, as bibliotecas sequer concordaram se a entrada já era uma forma canônica válida. Isso importa porque as assinaturas COSE e CWT são computadas sobre os bytes codificados, portanto, quando um valor é assinado como canônico em uma biblioteca e recodificado como canônico em outra, as duas podem divergir nos bytes e a assinatura falha na verificação. O caso mais gritante: uma biblioteca, sob uma função literalmente chamada encodeCanonical, reescreve silenciosamente o valor de ponto flutuante 2.0 para o inteiro 2, alterando os bytes que um verificador irá processar via hash.
O que o CBOR determinístico deveria fazer
O CBOR, Concise Binary Object Representation definido na RFC 8949, é o equivalente binário e compacto do JSON que sustenta COSE, CWT, WebAuthn/FIDO2 e um número crescente de formatos de IoT e supply-chain. O CBOR padrão permite que o mesmo valor seja escrito de várias maneiras: um inteiro pode ser preenchido com mais bytes do que necessita, as chaves de um mapa podem aparecer em qualquer ordem, um float pode ser armazenado em precisão half, single ou double. Essa flexibilidade funciona bem até que você precise gerar um hash ou assinar um valor, porque uma assinatura é feita sobre bytes, e se os bytes podem variar, a assinatura perde o sentido.
A codificação determinística, descrita na RFC 8949 Section 4.2, é a solução: um conjunto de regras que reduz cada valor a uma, e apenas uma, codificação. Materiais mais antigos chamam isso de CBOR canônico; o termo atual é determinístico, e ambos significam a mesma coisa. O perfil principal exige quatro coisas: inteiros e comprimentos na forma mais curta, apenas comprimentos definidos, floats na forma mais curta e chaves de mapa ordenadas pela sequência de bytes de sua forma codificada. Se acertar as quatro, em princípio, quaisquer dois codificadores emitirão bytes idênticos para valores idênticos. Todo o valor do esquema reside nessa palavra idênticos. Então, nós testamos.
O que medimos e por que um cético deve confiar
Construímos um oráculo diferencial: um conjunto compartilhado de valores de teste, processado por várias bibliotecas independentes de CBOR em seus modos determinísticos ou canônicos, comparando o que cada uma produziu. Esse é o mesmo método que usamos para tabular o comportamento de TLS entre bibliotecas sob FIPS. Não requer terceiros e não toca na infraestrutura de ninguém; é nosso próprio código, em nosso próprio laboratório descartável, codificando números que nós mesmos geramos. As bibliotecas aparecem apenas em uma tabela de compatibilidade neutra, da mesma forma que uma tabela de compatibilidade de navegadores lista navegadores.
As cinco implementações, escolhidas para cobrir diferentes linguagens e incluir uma linha de base estrita de dCBOR:
| Biblioteca | Versão | Modo utilizado |
|---|---|---|
| cbor2 (Python) | 6.1.4 | dumps(canonical=True) |
| cbor (Node.js) | 10.0.12 | encodeCanonical |
| fxamacker/cbor (Go) | v2.9.3 | Core Deterministic, chaves duplicadas impostas |
| ciborium (Rust) | 0.2.2 | codificador padrão (sem modo canônico dedicado) |
| bc-dcbor (Rust) | 0.15.2 | perfil dCBOR estrito |
O corpus foi de 3,061 valores: 61 vetores de borda criados manualmente cobrindo dez pontos de decisão conhecidos, mais 3,000 valores tipados gerados aleatoriamente a partir de uma seed fixa para que a execução se reproduza com exatidão. Para cada valor e cada biblioteca, registramos duas coisas: a recodificação canônica em hex e um veredito, indicando se a biblioteca aceitou a entrada como forma canônica válida, se a decodificou como não canônica ou se a rejeitou por completo. Em seguida, fizemos a comparação diff. O método é deliberadamente simples, o que constitui sua força: ele não julga quem está certo, apenas contabiliza onde implementações independentes, todas alegando serem canônicas, discordam.
O resultado: 26% dos valores com mais de uma codificação canônica
Entre os 3,061 valores, 806 (26.3%) produziram mais de uma codificação canônica distinta entre as cinco bibliotecas, e 1,223 (40.0%) produziram mais de um veredito de aceitação ou rejeição. O corpus aleatório por si só, contendo valores comuns que uma aplicação real serializaria, divergiu na codificação em 26.2% das vezes. Este não é um fenômeno restrito a casos de borda; um quarto dos valores cotidianos é codificado de forma diferente dependendo de qual canonicalizador é utilizado.
Os vetores manuais mostram onde a discordância se concentra. Cada linha abaixo representa um ponto de decisão conhecido na codificação determinística, e as porcentagens indicam a frequência com que as cinco bibliotecas divergiram na codificação e no veredito de validade.
| Ponto de decisão | Divergência na codificação | Divergência no veredito |
|---|---|---|
| Chaves de mapa duplicadas | 100% | 100% |
| Redução numérica (2.0 para 2) | 83% | 83% |
| Ordenação de chaves de mapa | 67% | 67% |
| Float de menor representação | 50% | 70% |
| Zero negativo | 33% | 100% |
| NaN não canônico | 25% | 63% |
| Minimalidade de inteiros | 0% | 60% |
| Comprimentos indefinidos | 0% | 80% |
| Bytes excedentes no final | 0% | 75% |
Leia as três últimas linhas com atenção, pois elas contêm nuances importantes. Na minimalidade de inteiros, comprimentos indefinidos e bytes excedentes, as bibliotecas que geram uma codificação produzem a mesma codificação, de modo que a coluna de divergência na codificação é 0%. Contudo, elas discordam frontalmente sobre a entrada ser aceitável em primeiro lugar: divergências de veredito entre 60% e 80%. Uma biblioteca simplesmente ignora e recodifica um inteiro não minimal; outra sinaliza a anomalia; uma terceira a rejeita. Para um pipeline de assinatura, uma discordância entre aceitar ou rejeitar é tão perigosa quanto uma divergência nos bytes, pois determina se a mensagem será processada ou não.
O impacto real: uma assinatura que valida em uma stack e falha em outra
Eis por que isso sai do campo da curiosidade teórica. O COSE (RFC 9052) e o CWT (RFC 8392) não assinam um valor abstrato. O COSE constrói uma Sig_structure, uma estrutura de array CBOR contendo o contexto, os cabeçalhos protegidos, dados externos e o payload, codifica esse array em CBOR, e a assinatura é calculada sobre esses bytes. O verificador reconstrói a mesma estrutura, a codifica e valida a assinatura contra seus bytes. Todo o mecanismo assume que ambos os lados produzem os mesmos bytes para o mesmo valor. A codificação determinística é essa premissa.
Agora observe isso quebrar. O exemplo mais claro em nossos dados é o valor de ponto flutuante 2.0, CBOR f94000:
| Biblioteca | Saída canônica | O que fez |
|---|---|---|
| cbor (Node.js) | 02 | reduziu o float para o inteiro 2 |
| cbor2 (Python) | f94000 | manteve como float |
| fxamacker/cbor (Go) | f94000 | manteve como float |
| ciborium (Rust) | f94000 | manteve como float |
| bc-dcbor (Rust) | reject | recusou a forma float |
Três resultados distintos para um único número trivial, sob funções todas anunciadas como canônicas ou determinísticas. Um serviço que assina um token contendo o número 2.0 usando a biblioteca de Node, cujo modo canônico aplica redução numérica no estilo dCBOR e emite 02, e um verificador que recodifica o valor com a biblioteca de Python ou Go e obtém f94000, irão calcular o hash de sequências de bytes diferentes. A assinatura não será validada, e a falha parecerá um bug intermitente e misterioso de interoperabilidade, em vez do que realmente é: duas bibliotecas que acreditam ser canônicas, mas não compartilham o mesmo conceito de canônico.
O caso de chaves duplicadas é ainda pior em outro aspecto. Dado o mapa {1:1, 1:2} (entrada a201010102), Go e a linha de base dCBOR o rejeitam, Python e Node silenciosamente o reduzem a um mapa de uma única entrada {1:2}, e o codificador padrão de Rust repassa a duplicata sem alterações. Cinco bibliotecas, três comportamentos com impacto em segurança: rejeitar, descartar dados silenciosamente ou preservar uma estrutura ambígua. Qualquer um desses descompassos entre quem assina e quem verifica abre espaço para um invasor escolher qual lado enxerga qual valor.
Dois padrões canônicos e uma taxa de rejeição reveladora
A razão pela qual este é um problema estrutural e não uma coleção de bugs isolados é a existência de mais de um padrão canônico. A codificação determinística padrão da RFC 8949 é um dos alvos. O perfil mais estrito dCBOR, draft-mcnally-deterministic-cbor, é outro, e ele deliberadamente vai além: impõe redução numérica para que 2.0 se torne 2, canonicaliza todo NaN para uma forma única e rejeita chaves duplicadas imediatamente. Existem ainda mais propostas em andamento, incluindo o trabalho de draft-ietf-cbor-cde Common Deterministic Encoding da IETF, que existe justamente porque o ecossistema não convergiu. Adam Langley, do Google, catalogou pelo menos três ordenações conflitantes de chaves de mapa em 2022, e a divergência continua em produção: problemas reais de interoperabilidade estão abertos contra a biblioteca CBOR do .NET sobre a ordenação da RFC 7049 versus RFC 8949.
Nossos próprios números mostram essa divisão entre dois padrões canônicos em um dado contundente. A biblioteca estrita dCBOR rejeitou 1,221 dos 3,061 valores (40%) por não serem dCBOR válidos, embora as outras bibliotecas os tenham aceitado e codificado canonicamente sem problemas sob as regras padrão da RFC 8949. Nos 1,840 valores que o dCBOR aceitou, ele concordou com os demais em mais de 99.9% das vezes. Em outras palavras, dCBOR e o CBOR determinístico básico não são um par compatível onde um é apenas mais estrito; são duas linguagens diferentes com interseção parcial. Escolha um no assinador e o outro no verificador, e 40% dos seus valores cairão nesse abismo.
Os números de concordância par a par demonstram o mesmo ponto sob outra perspectiva:
- cbor2 (Python) e fxamacker/cbor (Go) concordaram em 99.93% dos valores. Duas implementações independentes, em linguagens distintas, que realmente convergem na codificação determinística básica da RFC 8949. É algo alcançável.
- cbor (Node.js) e ciborium (Rust) concordaram em apenas 73.7%. O par menos similar, divergindo em mais de um quarto dos valores, porque um aplica redução numérica e o outro simplesmente não canonicaliza.
- O codificador padrão do Rust nunca ordenou mapas nem reduziu floats. Isso não é um bug; o ciborium simplesmente não possui um modo canônico dedicado, o que ilustra perfeitamente a armadilha. Um desenvolvedor que utiliza uma biblioteca CBOR e não encontra uma opção de modo canônico assinará bytes não canônicos sem perceber.
Como medimos isso e as limitações do teste
A base de dados é nossa, construída a partir de valores que criamos, e apresentada de forma agregada. Não sondamos nenhum sistema externo e não apontamos nenhuma biblioteca como vulnerável; uma divergência de compatibilidade não é uma vulnerabilidade, é uma diferença de compatibilidade. O propósito de citar versões é a reprodutibilidade, não a atribuição de culpa.
- O corpus. 61 vetores manuais cobrindo dez pontos de decisão (minimalidade de inteiros, ordenação de mapas, chaves duplicadas, float mais curto, redução numérica, NaN, zero negativo, comprimento indefinido, bytes excedentes, inteiros grandes), mais 3,000 valores aleatórios gerados via seed para que toda a execução seja determinística e reproduzível.
- O veredito. Para cada valor e biblioteca, registramos a recodificação canônica em hex e se a biblioteca tratou a entrada como canônica válida, não canônica ou se a rejeitou. A divergência é calculada sobre as bibliotecas que retornaram uma codificação, evitando que uma biblioteca que rejeita um valor seja incorretamente contabilizada como geradora de uma codificação diferente.
- Modos específicos, não padrões, onde existe modo canônico. Cada biblioteca foi executada em seu modo determinístico ou canônico documentado, com exceção do ciborium, que não possui tal modo; incluímos seu codificador padrão justamente para ilustrar o comportamento que o desenvolvedor obtém quando nenhum modo canônico é oferecido.
- As limitações. Cinco bibliotecas não representam a totalidade do ecossistema, e cada biblioteca oferece diferentes parâmetros de rigor; uma configuração distinta poderia alterar os números. Estes também são comportamentos de bibliotecas, não uma prova de que produtos em produção realizem assinaturas com descompasso. A conclusão é que a divergência é real, comum e atinge exatamente os pontos de decisão que quebram assinaturas. É um alerta sobre uma premissa, não uma acusação contra um produto.
- Diferente de um bug de segurança no parser. Decodificadores de CBOR possuem seu próprio histórico de mitigação de vulnerabilidades, como as correções de memória e negação de serviço nos avisos de segurança do cbor2. Esses são problemas de robustez do decodificador, uma classe à parte. A confusão de canonicalização não gera um crash; trata-se de duas implementações íntegras discordando silenciosamente sobre qual é a saída correta.
O que fazer se você assina CBOR
As recomendações defensivas são previsíveis, o que confirma sua validade.
- Assine e verifique com a mesma biblioteca e versão em ambas as pontas sempre que possível. A assinatura entre stacks distintas é exatamente onde os 26% de divergência cobram o preço.
- Defina o perfil explicitamente. Decida se você exige a RFC 8949 determinística básica ou dCBOR estrito, documente isso e imponha que todos os participantes utilizem o mesmo padrão. Eles não são intercambiáveis.
- Nunca confie em configurações padrão. Se uma biblioteca não possui modo canônico, sua saída padrão quase certamente não será canônica, e você não receberá nenhum aviso.
- Valide contra vetores fixos, incluindo os casos complexos: chaves duplicadas,
2.0, zero negativo, NaN e mapas com chaves de comprimentos codificados distintos. Se o seu assinador e seu verificador produzirem bytes diferentes para qualquer um desses casos, você terá encontrado seu problema de interoperabilidade antes de um invasor.
O CBOR determinístico é uma excelente ideia que funciona na maioria das vezes, e duas das nossas cinco bibliotecas provaram que é possível convergir byte a byte. No entanto, funcionar na maioria das vezes não é a garantia que o termo determinístico exige, e assinaturas criptográficas não toleram inconsistências. A lacuna atinge um quarto dos valores comuns e afeta formatos dos quais depende grande parte da segurança moderna.
Perguntas frequentes
O que é CBOR determinístico e como ele difere do CBOR canônico?
O CBOR determinístico é um conjunto de regras adicionais sobre o CBOR comum (RFC 8949) que força um valor a ter exatamente uma codificação em bytes. É o que documentos antigos chamavam de CBOR canônico; a norma atual utiliza a palavra determinístico, e ambas significam o mesmo. A RFC 8949 Section 4.2 define as regras centrais: inteiros e comprimentos na forma mais curta, apenas comprimentos definidos, floats na forma mais curta e chaves de mapa ordenadas. O objetivo é que dois codificadores independentes emitam os mesmos bytes para o mesmo valor, premissa fundamental para assinaturas e hashes.
O que a RFC 8949 Section 4.2 exige para a codificação determinística?
Quatro pontos. Serialização preferencial, para que todo inteiro, comprimento e argumento de tag utilize o menor número de bytes possível. Apenas comprimentos definidos, eliminando strings, arrays ou mapas de comprimento indefinido. Ordenação de chaves de mapa por comparação lexicográfica byte a byte das chaves codificadas, a ordenação de etapa única. E float de menor representação, para que um valor utilize a menor forma entre half, single ou double que o represente com precisão. A Section 4.2.3 também documenta uma ordenação antiga baseada no comprimento mantida para compatibilidade com a RFC 7049, o que é uma fonte direta de divergência entre bibliotecas.
Como as chaves de mapa CBOR são ordenadas na codificação determinística?
Sob a RFC 8949, as chaves são ordenadas comparando suas sequências de bytes totalmente codificadas de forma lexicográfica, byte por byte. A RFC 7049, versão anterior, ordenava chaves codificadas menores antes das mais longas. As duas regras divergem sempre que as chaves têm comprimentos codificados distintos, por exemplo, uma chave inteira de um byte ao lado de uma de dois bytes, e bibliotecas desenvolvidas para versões diferentes ordenam o mesmo mapa de maneira distinta, embora ambas classifiquem o resultado como canônico.
O que é dCBOR e como ele difere do CBOR determinístico da RFC 8949?
O dCBOR é um perfil mais estrito definido no draft draft-mcnally-deterministic-cbor. Além das regras da RFC 8949, ele adiciona a redução numérica, exigindo que um float sem parte fracionária seja codificado como inteiro quando couber, transformando 2.0 em 2. Ele também canonicaliza todo NaN para uma forma única half e rejeita mapas com chaves duplicadas como erro de decodificação. Como ele reduz 2.0 para 2, um mapa válido sob CBOR determinístico comum pode se tornar inválido em dCBOR quando duas chaves colapsam para o mesmo valor reduzido.
Por que a codificação determinística é importante para assinaturas COSE e CWT?
O COSE (RFC 9052) e o CWT (RFC 8392) calculam assinaturas sobre bytes codificados em CBOR, não sobre valores abstratos. O COSE monta uma estrutura Sig_structure, a codifica em CBOR e assina esses bytes. Se o assinador canonicaliza um valor de uma forma e o verificador o recodifica de outra, o verificador aplica o hash em bytes diferentes e a assinatura falha, ou um valor manipulado nos limites da especificação passa em um lado significando algo diferente no outro. A codificação determinística é a premissa que garante a segurança da assinatura de valores estruturados.
Bibliotecas CBOR diferentes produzem os mesmos bytes canônicos?
Nem sempre. Em nosso teste com cinco bibliotecas amplamente utilizadas em modo canônico, 26.3% de 3,061 valores produziram mais de uma codificação canônica distinta, e 40% geraram mais de um veredito de validade. As divergências se concentram em chaves duplicadas, redução de float, ordenação de mapas e seleção do menor float. Duas bibliotecas concordaram em mais de 99.9% dos valores, enquanto o par menos similar coincidiu em menos de 74%, demonstrando que a consistência depende criticamente de quais implementações são combinadas.
2.0 é codificado da mesma forma que 2 em CBOR?
Depende da biblioteca e do perfil. No CBOR determinístico padrão da RFC 8949, o float 2.0 permanece como float e é codificado de forma diferente do inteiro 2. No dCBOR, a redução numérica exige que 2.0 seja codificado como o inteiro 2. Em nossos testes, uma biblioteca reescreveu 2.0 para 2 em um modo chamado encodeCanonical, três mantiveram como float, e a linha de base dCBOR rejeitou a forma em float, resultando em bytes assinados divergentes para o mesmo valor em stacks diferentes.
Como codificar CBOR de forma determinística?
Ative o modo determinístico ou canônico explícito da biblioteca em vez de confiar nas opções padrão, que não ordenam mapas nem reduzem floats. Defina o perfil exato, seja a RFC 8949 padrão ou o dCBOR estrito, e garanta que o assinador e o verificador usem o mesmo. Realize testes com casos de borda, especialmente chaves duplicadas, floats sem parte fracionária, zero negativo, NaN e chaves de mapa com comprimentos mistos. Se você assina CBOR, a abordagem mais segura é usar bibliotecas e versões idênticas em ambas as pontas, ou validar bytes contra vetores de teste fixos.
Leituras complementares
- O FIPS desativa o TLS pós-quântico? O mesmo método diferencial, aplicando um conjunto de entradas em várias bibliotecas, direcionado ao handshake TLS em vez de um formato de serialização.
- Certificate Transparency pós-quântico: 43% dos logs CT estáticos já assinam com ML-DSA-44. Outro cenário onde assinaturas são calculadas sobre uma codificação precisa de bytes, e onde analisar os bytes brutos revela o comportamento real.
- O que os certificados provam. Analisando uma garantia criptográfica diretamente no tráfego por construção em vez de confiar no rótulo, o mesmo princípio aplicado à contagem de bytes aqui.
A criptografia da qual você depende está realmente ativa?
Nossa verificação de $100 analisa sua postura criptográfica e de protocolos externa real da mesma forma que um invasor a mapeia, dentro de um escopo verificado e autorizado por escrito, com um operador sênior na apresentação dos resultados. As premissas nas quais suas assinaturas e tokens silenciosamente confiam fazem parte dessa superfície de ataque.
Agende uma verificação de $100