Verificação de assinatura JCS: seis de sete bibliotecas da RFC 8785 concordam com a forma canônica, uma não
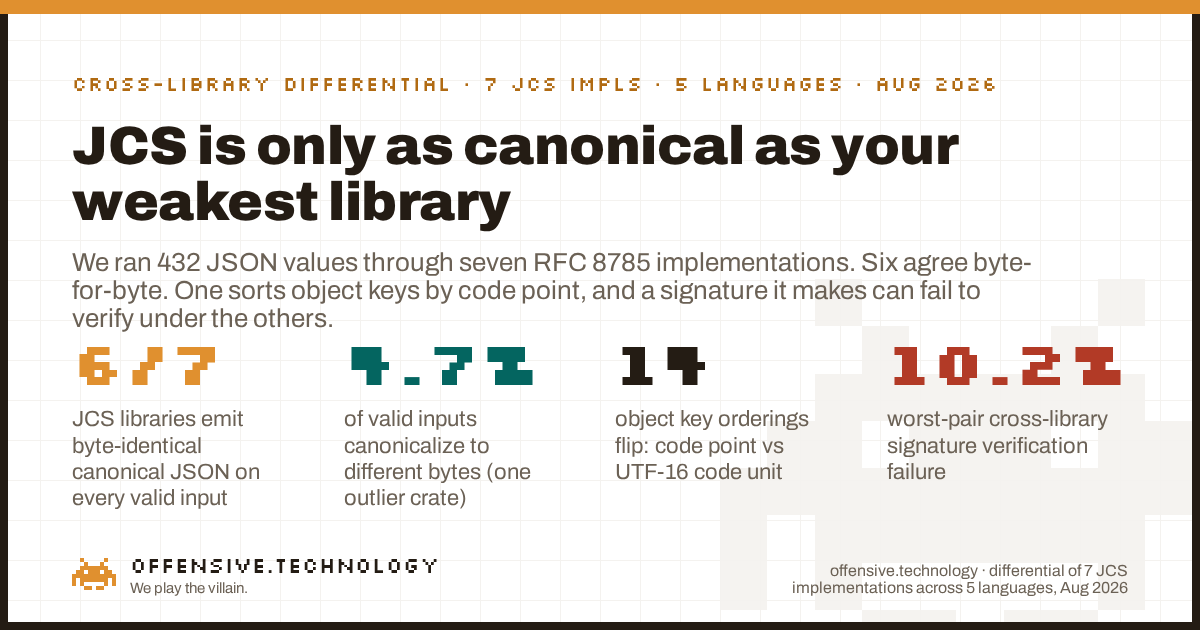
Seis das sete bibliotecas de canonicalização JSON da RFC 8785 que testamos produzem uma saída idêntica em nível de bytes em todas as entradas válidas; a sétima não, e essa única divergência causa uma quebra na verificação de assinaturas. Executamos 432 valores JSON válidos em sete implementações independentes de JCS em cinco linguagens. Todas as sete coincidem com o exemplo prático do Apêndice B da RFC 8785, portanto, todas as sete são genuinamente JCS. Mas uma delas, a crate em Rust serde_jcs, ordena as chaves de objetos por code point Unicode em vez de code unit UTF-16, como exige a especificação. Em 4.7% das nossas entradas válidas, ela gera bytes diferentes das outras seis. Se ela estiver em um dos lados de uma assinatura e qualquer uma das outras bibliotecas estiver no outro, um objeto JSON assinado por uma pode falhar na verificação pela outra. Quando simulamos isso diretamente com HMAC, o pior par de bibliotecas falhou em verificar 10.2% das mensagens que deveria ter aceito.
Por que um byte de divergência é uma falha de segurança
O JSON comum oferece liberdade demais. O mesmo objeto lógico pode ser escrito com suas chaves em qualquer ordem, com qualquer quantidade de espaços em branco e com números grafados de várias maneiras equivalentes. Essa flexibilidade é aceitável até você querer assinar o objeto, pois uma assinatura é calculada sobre bytes, não sobre o significado. Se o assinador e o verificador serializarem o objeto de formas diferentes, o verificador gera o hash de bytes distintos e a assinatura não é validada. Pior ainda, se um atacante conseguir encontrar duas sequências de bytes que um lado trata como iguais e o outro como diferentes, temos um ataque de canonicalização: uma mensagem manipulada que é verificada como uma coisa, enquanto significa outra. Um levantamento de 2026 cataloga falhas de canonicalização como uma classe recorrente de vulnerabilidade exatamente nesses sistemas.
RFC 8785, o JSON Canonicalization Scheme, é a solução. Ele elimina qualquer grau de liberdade: os nomes dos membros do objeto são ordenados, os números são serializados com o algoritmo Number.prototype.toString do ECMAScript, as strings recebem o escape mínimo permitido e espaços em branco insignificantes são descartados. Forneça o mesmo valor JSON a qualquer implementação compatível e você obterá os mesmos bytes, garantindo que ambas as extremidades de uma assinatura concordem sobre o que foi assinado. Esse esquema agora é estrutural. O protocolo Agent-to-Agent assina um agent card como um JWS sobre o conteúdo do card canonicalizado com JCS, e orienta os clientes a verificarem pelo menos uma assinatura antes de confiar no card. Credenciais verificáveis e fluxos JWS detached fazem o mesmo. Os bytes canônicos são o limite de confiança.
Portanto, a questão interessante não é se a especificação é sólida. É se as bibliotecas que as pessoas realmente implementam concordam entre si. Nós medimos isso.
O que testamos
Reunimos sete implementações independentes de JCS em cinco linguagens, escolhidas por serem as que um desenvolvedor provavelmente obteria em um gerenciador de pacotes:
canonicalize4.0.0 para JavaScript (npm), o módulo amplamente utilizado derivado de erdtman.- A implementação de referência
cyberphone/json-canonicalizationem Python, o próprio código de referência do autor. - O pacote do PyPI
jcs, versão 0.2.1, uma implementação separada em Python. gowebpki/jcsv1.0.1 para Go.- A implementação de referência
cyberphone/json-canonicalizationem Go. serde_jcs0.1.0 para Rust.java-json-canonicalization1.1 para Java (o artefato Maven de erdtman).
Cada uma foi executada em seu próprio contêiner com imagem oficial, garantindo que o resultado seja reproduzível e que nenhuma biblioteca influencie outra. Criamos um corpus de 440 entradas manipuladas, sendo 432 delas JSON válido, classificadas por categoria: formatação de números perto dos limites do IEEE-754 e do ECMAScript, zero negativo, casos de ordenação de chaves com caracteres que se ordenam de forma diferente em UTF-16 e em code point, escape e normalização Unicode, chaves duplicadas, surrogates isolados e casos extremos estruturais. Enviamos os mesmos bytes para todas as bibliotecas e capturamos sua saída canônica, preservando os bytes com exatidão para que nenhuma divergência fosse um artefato do nosso próprio ferramental.
Dois oráculos analisaram as saídas. O primeiro é um teste diferencial direto: para cada entrada, as bibliotecas que tiveram sucesso produzem os mesmos bytes? O segundo é o próprio ataque: com uma chave HMAC-SHA256 fixa, uma biblioteca assinadora canonicaliza uma entrada e gera a tag, e então uma biblioteca verificadora canonicaliza a mesma entrada e valida a tag. Cada par ordenado de bibliotecas, cada entrada. Uma falha aí representa uma assinatura entre bibliotecas que deveria ser verificada, mas não é.
Antes de confiar em qualquer resultado, verificamos o dado de referência. Todas as sete implementações reproduzem a saída canônica do Apêndice B da RFC 8785 byte a byte, incluindo seus números deliberadamente complexos e sua string com escape. Todas são JCS de verdade. É isso que torna a divergência abaixo significativa: não se trata de uma biblioteca quebrada contra uma correta, mas de sete bibliotecas aparentemente corretas, uma das quais falha silenciosamente em um caso extremo.
O resultado: 4.7% das entradas válidas divergem, e sempre da mesma forma
Nas 426 entradas válidas e inequívocas que todas as bibliotecas aceitaram, seis das sete foram idênticas em nível de bytes em todas elas. Não apenas próximas: idênticas, em cada valor. A sétima, serde_jcs, divergiu em 20 dessas 426 entradas, o que representa 4.7%, e foi a única minoria em todas as vezes. Quando as bibliotecas JCS divergem, no nosso corpus, é uma biblioteca contra todas as outras.
| Categoria | Entradas | Divergentes | Causa |
|---|---|---|---|
| Ordenação de chaves | 80 | 14 | ordem de code point vs UTF-16 |
| Formatação de números | 194 | 6 | inteiros acima de 253 |
| Zero negativo | 18 | 0 | todas concordam (-0 para 0) |
| Escape Unicode | 76 | 0 | todas concordam |
| Normalização Unicode | 27 | 0 | todas concordam (sem NFC/NFD silencioso) |
| Estrutural | 30 | 0 | todas concordam |
Duas categorias concentram toda a divergência, e a primeira é a que realmente importa.
A divergência na ordenação de chaves: code point versus code unit UTF-16
A RFC 8785 é explícita ao definir que os nomes dos membros dos objetos são ordenados por sua codificação UTF-16, comparando code units. Esse detalhe existe porque o JCS herda a ordenação de strings do ECMAScript, e strings no ECMAScript são sequências de code units UTF-16. Para caracteres no Basic Multilingual Plane, a ordem de code unit e a ordem de code point são as mesmas, então quase ninguém percebe. Elas divergem apenas para caracteres do plano suplementar, aqueles acima de U+FFFF codificados como um par de surrogates. Um emoji como U+1F600 tem o code point 0x1F600, que é maior que um caractere do Basic Multilingual Plane como U+E000. Mas sua codificação UTF-16 começa com a code unit de high-surrogate 0xD83D, que é menor que 0xE000. Portanto, sob as duas regras, as duas chaves são ordenadas de maneiras opostas.
Quatorze das nossas entradas de ordenação de chaves atingiram exatamente essa linha de falha, e a serde_jcs ordena por code point, enquanto as outras seis ordenam por code unit UTF-16. Aqui está o menor caso, um objeto com duas chaves:
input:      {"😀": 1, "\uE000": 2}

six libs:   {"😀":1,"\uE000":2}     😀 first  (0xD83D < 0xE000)
serde_jcs:  {"\uE000":2,"😀":1}     😀 last   (0x1F600 > 0xE000)
O caractere de uso privado U+E000 é exibido aqui com escape para facilitar a leitura; o JCS na verdade o emite como um byte literal, e ambas as bibliotecas concordam nessa parte. No que elas não concordam é na ordem dos dois membros, e isso é o bastante. Assine o objeto da esquerda com HMAC ou JWS, entregue-o a um verificador executando serde_jcs, e o verificador o canonicaliza como o objeto da direita, calcula uma tag diferente e rejeita uma assinatura perfeitamente válida. Inverta os papéis e o mesmo acontece no sentido oposto. As duas bibliotecas têm uma divergência estável e silenciosa sobre qual é a forma canônica desse objeto.
Esta não é uma descoberta exótica sobre o esquema. Trata-se da clássica armadilha de conformidade do JCS, apontada na própria RFC e em artigos anteriores sobre canonicalização. O que nossa medição acrescenta é a taxa base: de sete bibliotecas lançadas e instaláveis que passam no próprio vetor de teste da RFC, uma ainda erra nisso hoje. Conformidade com o exemplo principal não implica conformidade nos casos extremos.
A divergência numérica e por que a relatamos separadamente
As outras seis entradas divergentes são números inteiros maiores que 253, como 9007199254740993. O JCS especifica que os números são serializados por meio do algoritmo number-to-string do ECMAScript, que utiliza um double IEEE-754. Acima de 253, um double já não consegue representar todos os inteiros, então 9007199254740993 arredonda para 9007199254740992. Seis bibliotecas fazem exatamente isso. A serde_jcs prefere preservar o inteiro com exatidão. Destacamos com franqueza que esse é um achado mais fraco do que a divergência na ordenação de chaves: a RFC 8785 é definida apenas para números no intervalo de double do IEEE-754, de modo que um inteiro acima de 253 pode ser considerado uma entrada fora da especificação que um chamador nunca deveria passar. Mesmo assim, continua sendo um JSON sintaticamente válido, ainda produz uma divergência em nível de bytes entre bibliotecas reais, e um sistema que aceite identificadores numéricos maiores que um safe integer do JavaScript ainda pode cair nisso. Mantemos isso na análise diferencial e fora do título principal.
Todo o restante se manteve. O zero negativo foi canonicalizado para 0 em todos os casos. Nenhuma biblioteca aplicou normalização Unicode silenciosamente, portanto uma string em NFC e a mesma string em NFD permaneceram distintas em todas as sete, o que é o correto: o JCS não normaliza. O escape de strings foi uniforme. As divergências são pontuais e específicas, o que as torna perigosas em vez de óbvias.
Transformando a divergência em uma falha de assinatura
Uma divergência nos bytes canônicos só é interessante se quebrar algo. Então fizemos quebrar. Usando uma chave HMAC-SHA256 fixa, fizemos cada biblioteca atuar como assinadora e cada biblioteca atuar como verificadora em todas as entradas válidas nas quais ambas produziram bytes: 42 pares ordenados, 11,754 verificações no total. Uma verificação falha quando os bytes canônicos do assinador e os do verificador diferem, pois as tags resultantes serão diferentes.
Em todos os pares, 1.87% das verificações falharam. Esse número é diluído pelas seis bibliotecas que nunca discordam entre si, portanto a forma correta de interpretá-lo é por par. Todo par que não envolve a serde_jcs verificou com 100% de sucesso. Todo par que combina a serde_jcs com uma biblioteca compatível falhou nas entradas divergentes. A pior combinação, a referência em Go da cyberphone como assinadora e a serde_jcs como verificadora, falhou em 15 de 147 verificações, uma taxa de falha de verificação de assinatura de 10.2% entre duas bibliotecas que passam no vetor de teste da RFC. Em uma implantação que combina linguagens através de um limite de confiança, e sistemas agent-to-agent fazem exatamente isso, essa é a falha que você realmente veria.
O outro eixo: algumas bibliotecas rejeitam o que outras aceitam
Além das divergências em nível de bytes, encontramos uma grande superfície de aceitação versus rejeição: 288 entradas em que pelo menos uma biblioteca retornou saída e outra retornou erro. Isso não é uma discordância de forma canônica, mas é um risco de interoperabilidade por si só, dividindo as bibliotecas em campos opostos.
- Escalares no nível raiz. Os dois parsers derivados das implementações de referência,
cyberphoneem Go eerdtmanem Java, rejeitam um0ou"x"simples como entrada raiz; as outras o canonicalizam. Se o seu protocolo algum dia assinar um escalar JSON simples, metade dessas bibliotecas não o processará de forma alguma. - Chaves duplicadas. Dado
{"a":1,"a":2}, todos os três parsers em Go e Java rejeitam o objeto imediatamente, enquanto as implementações em JavaScript, Python e Rust mantêm silenciosamente o último valor. O tratamento de chaves duplicadas é indefinido o suficiente para que o assinador e o verificador discordem até mesmo sobre a mensagem ser válida. - Surrogates isolados. Um surrogate não pareado em uma string é um JSON inválido, e as bibliotecas divergem: uma emite o caractere de substituição U+FFFD, outra transmite os bytes brutos não UTF-8 diretamente e o restante rejeita. Qualquer um desses comportamentos em uma extremidade e um diferente na outra é uma divergência prestes a acontecer.
Mantemos isso fora do número de destaque porque se trata de aceitação versus rejeição, não de byte contra byte, mas a lição é a mesma: a garantia reside na implementação, não na sigla de três letras.
O reflexo inverso do nosso resultado com CBOR
Executamos o mesmo experimento em outra codificação, no CBOR binário, e obtivemos o cenário oposto. Nele, o CBOR determinístico não foi determinístico entre bibliotecas: 26% dos valores resultaram em mais de uma codificação canônica, e a divergência se espalhou por todo o conjunto de bibliotecas. O JCS é o irmão organizado. Suas regras são mais estritas e suas bibliotecas concordam na maioria dos casos, portanto a divergência se reduz a um ponto fora da curva e a um punhado de entradas extremas, em vez de um quarto de tudo. Esse contraste é a lição prática. A segurança de um esquema de canonicalização não é uma propriedade apenas do esquema; é o produto do rigor do esquema e da conformidade das bibliotecas específicas no seu caminho. O JCS oferece um esquema melhor. Ele não isenta você de verificar suas bibliotecas.
Teste sua própria biblioteca em dez segundos
Você não precisa do nosso harness para descobrir de que lado dessa divisão você está. Canonicalize este objeto com a biblioteca JCS que você utiliza:
{ "😀": 1, "\uE000": 2 }Se a saída colocar a chave com emoji primeiro, sua biblioteca ordena por code unit UTF-16 e está em conformidade com a RFC e com a maioria. Se ela colocar a chave de uso privado primeiro, sua biblioteca ordena por code point e divergirá de um par compatível em qualquer objeto cujas chaves misturem caracteres do plano suplementar e do Basic Multilingual Plane. Execute essa mesma verificação em ambas as extremidades de cada limite de confiança que assina JSON, especialmente onde as duas extremidades usam linguagens diferentes e sobretudo se qualquer uma das suas chaves puder conter Unicode influenciado por invasores.
Como medimos isso, para que os céticos possam confiar nos números
O conjunto de dados é inteiramente nosso e sintético. Não acessamos nenhum serviço de terceiros, não realizamos varreduras nem coletamos dados do mundo real; cada entrada é um valor JSON que escrevemos para testar um caso extremo específico. As bibliotecas são pacotes públicos de código aberto, testados em suas versões publicadas e identificados nominalmente porque apontar o comportamento de uma implementação de especificação é todo o propósito de um teste de conformidade, e não uma acusação contra ninguém.
- Isolamento. Cada implementação foi executada em seu próprio contêiner com imagem oficial, lendo o mesmo corpus e gravando sua saída canônica com os bytes preservados com exatidão, garantindo que qualquer divergência pertença à biblioteca, e não ao nosso pipeline.
- Dado de referência. Todas as sete reproduzem a saída canônica do Apêndice B da RFC 8785 byte a byte, e é assim que sabemos que são implementações reais de JCS, e não serializadores aproximados.
- Dois oráculos independentes. Um teste diferencial em nível de bytes e uma validação real de assinatura e verificação com HMAC em todos os 42 pares ordenados de bibliotecas. As falhas de assinatura são o teste diferencial concretizado, não uma afirmação separada.
- Categorização honesta. Separamos as divergências em nível de bytes em entradas válidas (o dado principal) do comportamento de aceitação versus rejeição e de entradas possivelmente fora da especificação, para que nenhum número tenha mais peso do que realmente merece.
O harness, o gerador de corpus e os executores de cada biblioteca foram mantidos para que o método seja reproduzível; relatamos aqui apenas o agregado.
Por que isso importa e os limites realistas
A canonicalização está silenciosamente se tornando estrutural de novo. O esforço para fornecer identidades verificáveis a agentes autônomos, por meio de agent cards assinados e credenciais verificáveis, passa a decisão de confiança por um pipeline de JCS seguido de assinatura, frequentemente com o assinador e o verificador escritos em linguagens diferentes por equipes distintas. Essa é exatamente a condição na qual uma falha de conformidade em uma única biblioteca se transforma em uma quebra de verificação. A boa notícia desse levantamento é que o JCS tem boa interoperabilidade: escolha duas bibliotecas em conformidade e elas serão indistinguíveis. A má notícia é que a conformidade não é garantida pelo rótulo, e o único ponto onde uma biblioteca lançada ainda erra, a ordenação de chaves para caracteres do plano suplementar, é acessível a invasores e fácil de passar despercebido.
Um resultado sem limites claros é apenas marketing, portanto aqui estão as ressalvas.
- Sete bibliotecas, não o ecossistema inteiro. Estas são implementações comuns e instaláveis, mas existem outras, e uma implementação em C ou C-sharp que não testamos poderia estar em qualquer um dos lados da divergência. O método é generalizável; as contagens exatas são específicas deste conjunto nestas versões.
- Baixa probabilidade em payloads típicos. A divergência na ordenação de chaves só se manifesta quando as chaves do objeto contêm caracteres do plano suplementar, que são raros em agent cards comuns ou credenciais com nomes de campos em ASCII. O risco é real, mas condicional, e um invasor que controle uma chave é quem tornará essa condição verdadeira de propósito.
- As versões mudam. Bibliotecas são corrigidas. Uma crate que hoje ordena por code point pode se tornar compatível amanhã, e é exatamente por isso que o conselho duradouro é testar a versão específica que você implementa, em vez de confiar ou desconfiar de um nome.
- A divergência numérica é uma entrada extrema. Inteiros acima de 253 estão fora do intervalo para o qual o JCS foi definido, portanto tratamos essa divergência como um achado secundário, menos expressivo, e a mantemos fora do destaque.
Perguntas frequentes
O que é o JSON Canonicalization Scheme (JCS)?
O JCS, definido na RFC 8785, é um conjunto de regras que transforma um valor JSON em uma sequência de bytes determinística. Ele ordena os nomes dos membros dos objetos, serializa números com o algoritmo number-to-string do ECMAScript, aplica escape mínimo de strings e descarta espaços em branco insignificantes. Duas partes que partem do mesmo valor JSON produzem os mesmos bytes, permitindo gerar hashes ou assinar esses bytes com correspondência exata. O JCS é o que permite assinar JSON sem a necessidade de combinar previamente sua grafia exata.
Por que a verificação de assinaturas JCS falha entre linguagens diferentes?
Ela falha quando a biblioteca do assinador e a do verificador discordam sobre os bytes canônicos para o mesmo valor. Em nosso teste, seis de sete implementações concordaram byte a byte, mas uma crate em Rust ordenou as chaves de objetos por code point Unicode em vez de code unit UTF-16, como exige a RFC 8785. Para um objeto cujas chaves incluem um emoji ou outro caractere do plano suplementar, as duas bibliotecas emitem as chaves em ordens diferentes, fazendo com que a tag sobre o objeto seja diferente e a verificação falhe.
As implementações de JCS produzem a mesma saída canônica?
Na maior parte das vezes. Em 426 entradas válidas e inequívocas fornecidas a sete implementações em cinco linguagens, seis foram idênticas byte a byte em todas as entradas e todas as sete coincidiram com o Apêndice B da RFC 8785. Uma divergiu em 4.7% das entradas, e cada divergência envolveu uma chave de objeto no plano suplementar ou um número inteiro superior a 2 elevado à 53ª potência. O JCS apresenta boa interoperabilidade em dados comuns e diverge apenas em casos extremos específicos.
Como o JCS impede um bypass de assinatura?
Ele remove a liberdade que o JSON comum oferece: ordem de chaves, espaços em branco e as várias formas de representar um número, de modo que um valor seja mapeado para uma única sequência de bytes e não possa ser recodificado em um equivalente visualmente diferente. Essa garantia só se sustenta se ambos os lados usarem uma implementação em conformidade. Uma implementação não compatível reintroduz a ambiguidade que o JCS deveria eliminar, e é por isso que a conformidade da implementação, e não o simples uso do JCS, é a propriedade essencial.
Como o A2A usa o JCS para assinar agent cards?
No protocolo Agent-to-Agent, um agent card é um documento JSON que descreve a identidade e as capacidades de um agente. Sua assinatura é um JWS sobre o conteúdo do card após esse conteúdo ser canonicalizado com JCS, e os clientes são orientados a verificar pelo menos uma assinatura antes de confiar em um card. Como os bytes assinados são a saída do JCS, um cliente cuja biblioteca JCS canonicalize de forma diferente da do assinador calculará uma entrada distinta para a verificação.
O que é um ataque de confusão de canonicalização?
Ele explora uma divergência entre a forma como o assinador e o verificador reduzem uma mensagem à forma canônica. Se os dois produzirem bytes diferentes para o mesmo valor lógico, um invasor pode criar uma entrada que é verificada como uma coisa enquanto significa outra, ou fazer com que uma assinatura legítima falhe. A canonicalização é uma classe recorrente de vulnerabilidades em sistemas que assinam dados estruturados, pois a segurança depende de todas as partes calcularem a mesma forma canônica.
A RFC 8785 é um padrão oficial da IETF?
A RFC 8785 é uma RFC informativa da IETF publicada em junho de 2020. É uma especificação estável e de referência do JSON Canonicalization Scheme, citada por trabalhos posteriores sobre JSON assinado, credenciais verificáveis e segurança agent-to-agent. O status informativo significa que ela não é um padrão obrigatório da Internet (Internet Standard), mas é a definição apontada pelas implementações.
Leituras relacionadas
- O CBOR determinístico não é determinístico entre bibliotecas. O mesmo teste diferencial em outra codificação, no CBOR binário, onde 26% dos valores obtiveram mais de uma forma canônica.
- Segurança de servidores MCP remotos: o que um censo de 19,321 servidores revela. A superfície de ferramentas de agentes que esses cards assinados deveriam proteger, medida em escala populacional.
- O que os certificados provam. Lendo garantias criptográficas diretamente dos bytes em vez de confiar no rótulo, o mesmo método aplicado a certificados.